
什么是CID?
在去中心化网络上与对等方交换数据时,依靠内容寻址(而不是中心化网络的位置寻址)来安全地定位和识别数据。在这里将了解重要的去中心化网络概念的基础知识,如内容编址、加密散列、内容标识符(CID)以及与对等方的共享。在本文中,我们将深入探讨CID的结构,它是由Multiformats项目定义的各种自我描述的值构成的。
CID规范起源于IPFS,现在以多格式存在,并支持广泛的项目,包括IPFS、IPLD、libp2p和Filecoin。本文是关于CID本身的剖析,每个分布式信息系统都将其用作参考内容的核心标识符。
内容标识符(CID)是一个自我描述的内容寻址标识符。它不表示内容的存储位置,而是形成一种基于内容本身的地址。CID的字符数取决于底层内容的加密哈希值,而不是内容本身的大小。由于IPFS中的大多数内容是使用sha2-256进行哈希处理,在那里遇到的大多数CID将是具有相同的大小(256比特,相当于32字节)。这使得它们更易于管理,特别是在处理多条内容的时候。
例如,如果我们在IPFS网络上存储一个土豚的图像,它的CID将如下所示:QmcRD4wkPPi6dig81r5sLj9Zm1gDCL4zgpEj9CfuRrGbzF
创建CID的第一步是转换输入数据,使用一种加密算法将任意大小的输入(数据或文件)映射到固定大小的输出。这种转换被称为加密哈希摘要或简称为哈希。
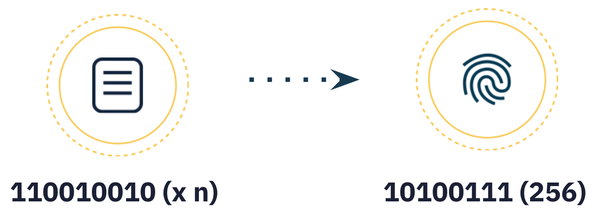
使用的加密算法必须生成具有以下特点的散列:
- 确定性:相同的输入应该总是产生相同的散列。
- 无关联性:输入的微小变化应该产生一个完全不同的哈希值。
- 单向的:从散列值重建数据应该是不可行的。
- 唯一性:一个文件只可以产生一个特定的哈希值。
请注意,如果改变土豚图像中的一个像素,加密算法将为该图像生成一个完全不同的哈希值。当我们使用内容地址获取数据时,可以保证会看到该数据的预期版本。这与集中式网络上的位置寻址截然不同,在集中式网络上,给定地址(URL)的内容会随着时间的推移而改变。
加密散列并不是IPFS独有的,现在有许多散列算法,如sha2-256、blake2b、sha3-256和sha3-512、不再安全的sha1和md5等等。IPFS默认使用sha2-256,尽管CID几乎支持任何强大的加密哈希算法。
Multihash
有时,散列算法被证明是不安全的,这意味着它不再符合前面定义的特征。sha1已经发生了这种情况。随着时间的推移,其他算法可能被证明不足以在IPFS和其他分布式信息系统中进行内容寻址。由于这个原因,并且为了支持多种加密算法,需要知道哪种算法能够被用来生成特定内容的哈希值。
那么应该怎么做呢?为了支持多种散列算法,选择了Multihash。
Multihash格式
Multihash是一种自我描述的哈希,它本身包含描述其长度和生成它的加密算法的元数据。多格式CID是面向未来的,因为它们使用Multihash来支持多种散列算法,而不是依赖一种特定的算法。
Multihash遵循TLV模式(类型—长度—值)。本质上,“原始散列 ”是以所应用的散列算法的类型和散列的长度为前缀。
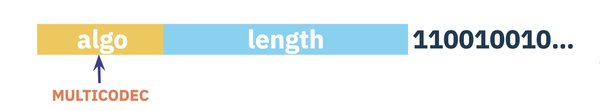
- 类型:用于生成散列的加密算法的标识符(例如,sha2-256的标识符是18—十六进制的0x12)——所有标识符请参阅多解码表
- 长度:哈希值的实际长度(使用sha2-256,它将是256比特,相当于32字节)。
- 值:实际的哈希值
为了将CID表示为紧凑的字符串,而不是普通的二进制(一系列1和0),可以使用基础编码。当IPFS首次创建时,它使用base58btc编码来创建如下所示的CID:QmY7Yh4UquoXHLPFo2XbhXkhBvFoPwmQUSa92pxnxjQuPU
Multihash格式和base58btc编码启用了CID的第一个版本,现在被称为Version 0(CIDv0),并且它的初始Qm...字符仍然很容易发现。
然而,随着时间的推移,人们对这种multihash格式是否足够产生了怀疑:
- 怎么知道用什么方法对数据进行编码呢?
- 怎么知道用什么方法来创建CID的字符串表示?会一直使用base58btc吗?
为了解决这些问题,有必要向CID的下一个版本进行演变。在下面的内容中,将探讨在规范中增加了哪些内容,从而能够达到目前的CID版本:CIDv1。
Multicodec前缀
CIDv0使用多重散列来支持多种散列函数。这意味着可以使用不同的散列算法为特定的内容生成散列,然后能够使用这个散列来识别内容。
但是试图读取数据本身时,怎么知道所使用的编码方法呢?它可以使用CBOR、Protobuf、纯JSON等编码的。为了解决这个问题,CIDv1引入了另一个唯一标识所使用的编码方法的前缀。
Multicodec前缀指示对数据使用的编码。
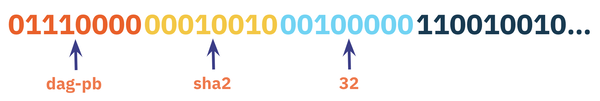
Multibase支持许多不同类型的编码,每一种都有自己的短编解码器标识符,如完整表格所示。
在上面的例子中,能够发现使用编解码器dag-pb编码的数据将如何在CID中表示。dag-pb是许多不同类型的IPLD(InterPlanetary Linked Data)编解码器中的一种。因为IPFS总是使用这些IPLD格式中的一种用于其数据,所以IPFS CID中的multicodec前缀总是IPLD编解码器。
然而,需要注意的是,multicodec不仅被IPFS和IPLD使用,与多重散列和其他一些自我描述的协议一样,也是多格式项目的一部分,该项目从IPFS中分离出来,现在支持各种各样的其他项目和协议,包括在这里了解到的CID规范。
版本前缀
现在,已经添加了一个multicodec,Version 1 CID包含以下字段:
<multicodec><multihash-algorithm><multihash-length><multihash-hash>。
但是,Version 0 CID只包含<multihash-*>部分,那么如何区分不同版本的CID呢?没错,就是更多的前缀!
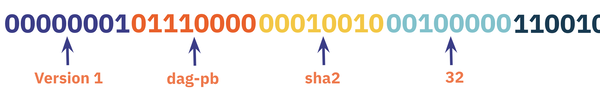
所以现在的CID看起来像这样:
<cid-version><multicodec><multihash>。
<cid-version>代表CID的版本(0或1)。
Multibase前缀
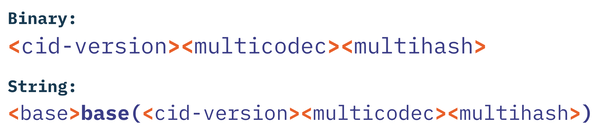
现在CIDv1在二进制(0和1)中提供了以下信息:
<cid-version><multicodec><multihash>。
由于二进制CID不是很人性化,可以用字符串的形式表示这些二进制CIDs(二进制数据表示为文本)。例如:
bafybeigdyrzt5sfp7udm7hu76uh7y26nf3efuylqabf3oclgtqy55fbzdi
在二进制和字符串格式之间转换数据需要进行基础编码,因此在使用字符串CID时,了解应用于二进制数据的基础编码的类型非常重要。但是,如何才能识别呢?
在CIDv0中,哈希值总是用base58btc编码。这意味着可以正确地解释CIDv0的哈希值,假设它们是使用base58btc。然而,由于环境的限制(如DNS名称),需要支持其他基础编码的能力。为此,可以添加另一个前缀!
Multibase前缀:表示在字符串和二进制格式之间转换CID时使用的基础编码,仅用于CID的字符串形式。
查看两个字符串形式的 CID 示例:
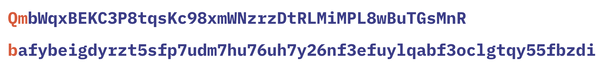
第一个是CIDv0,因为它的开头是Qm.... 所有以Qm开头的哈希值都可以被解释为base58btc作为版本0的CID。
第二个例子以b开头,是base32的基础编码前缀标识符,大多数IPFS的实现都默认使用它。
关于Multibase标识符的完整列表,请参见此表。
一个哈希值——带来多个CID版本
可以将IPFS的CID粘贴到方便的CID检查器中,用来可视化其所有的前缀和它们所代表的内容。
例1:CIDv1
bafybeigdyrzt5sfp7udm7hu76uh7y26nf3efuylqabf3oclgtqy55fbzdi
第一个例子是一个版本1的CID。

查看CID检查工具的结果,能够看到该工具能解析的几个部分:
人类可读的CID:分解CID的每个部分,以便我们轻松阅读
- Multibase:代码是基地的标识符,在本例中,b代表base32。
- Multicodec:代码是编解码器的标识符,在本例中0x70表示dag-pb,一种IPLD格式。
- Multihash:将多重散列分为所使用的哈希算法(18是sha2-256的代码),散列的长度(256比特,相当于32字节),以及内容散列本身(十六进制)。
从 “人类可读的CID”细分中,可以发现在添加适当的CIDv1前缀之前,内容的原始哈希值是C3C4733EC8AFFD06CF9E9FF50FFC6BCD2EC85A6170004BB709669C31DE94391A。
例2:CIDv0
QmbWqxBEKC3P8tqsKc98xmWNzrzDtRLMiMPL8wBuTGsMnR
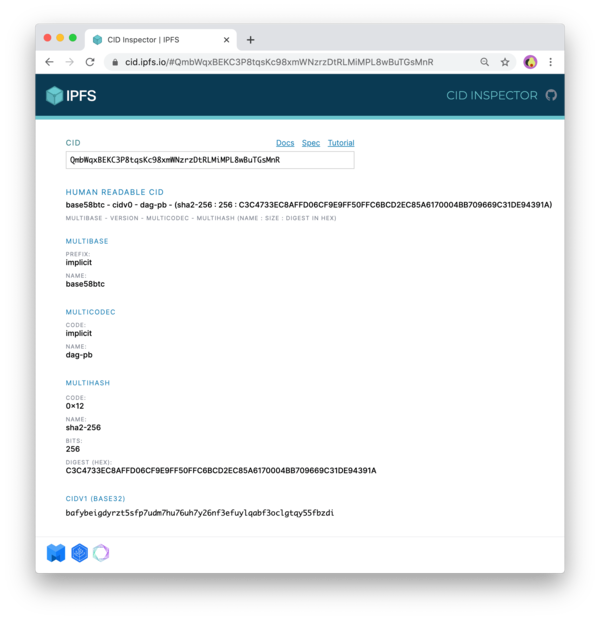
这个Version 0的CID显示了一些不同的结果:multibase和multicodec都被列为“隐性”。由于Version 0 CID没有这些前缀,因此它们总是被假定是base58btc和dag-pb。
在Base32 CIDV1标签下,能看到bafybeigdyrzt5sfp7udm7hu76uh7y26nf3efuylqabf3oclgtqy55fbzdi,这与第一个例子中的CID是一样的! CID检查器已经提供了一个从CIDv0到CIDv1的转换。
请注意,在这个CIDv0的例子中“人类可读的CID”(前缀之后的部分)的结尾与在CIDv1的例子中是完全一样的:C3C4733EC8AFFD06CF9E9FF50FFC6BCD2EC85A6170004BB709669C31DE94391A.
是为什么呢?因为这两个CIDs指向相同的内容。事实上,这是在两个不同版本的CID规范中所代表的相同哈希值(C3C4733EC8AFFD06CF9E9FF50FFC6BCD2EC85A6170004BB709669C31DE94391A)。
转换CID版本
可以将任何CIDv0转换为CIDv1,因为v0的隐式前缀在v1中会变成显式。但是,由于CIDv1支持multiple codecs和multiple bases,而CIDv0不支持,因此并非所有的CIDv1都可以转换为CIDv0。 实际上,只有具有以下属性的CIDv1可以转换为CIDv0:
- multibase = base58btc
- multicodec = dag-pb
- multihash-algorithm = sha2-256
- multihash-length = 32(32字节,相当于256比特)
为了测试这一理论,你可以在这里查看可爱的土豚图像,它托管在IPFS网络上:https://ipfs.io/ipfs/QmcRD4wkPPi6dig81r5sLj9Zm1gDCL4zgpEj9CfuRrGbzF
在浏览器中打开链接,复制URL末尾的CID(QmcRD4wkPPi6dig81r5sLj9Zm1gDCL4zgpEj9CfuRrGbzF)。在一个新的浏览器窗口,将其粘贴到CID检查工具中,并找到显示在屏幕底部的等效CIDv1值,回到ardvark标签,用原始URL中转换后的V1 CID替换v0 CID,然后刷新页面,就可以看到土豚的相同图像。
原文链接:https://proto.school/anatomy-of-a-cid
---煤油灯科技victorlamp.com翻译整理---
