大多数网站使用JavaScript (JS)代码来制作动态内容,因此,JS代码成为针对浏览器、浏览器插件、电子邮件客户端和其他JS应用程序的有价值的攻击载体。常见的基于JS的攻击包括下载驱动、跨站点脚本编写(XSS)、跨站点请求伪造(XSRF)、恶意广告和其他。大多数恶意JS代码都进行了混淆处理,以隐藏它们正在做的事情,并避免被基于签名的安全系统检测到。换句话说,混淆技术是一系列令人困惑的代码转换,以降低其可理解性,但同时保存其功能。
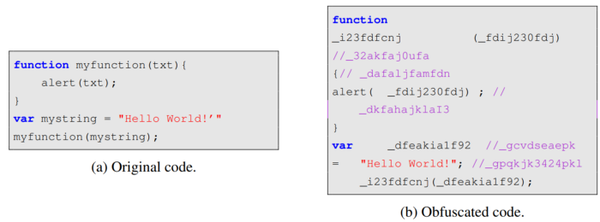
随机化混淆示例
介绍
传统的防病毒和入侵检测系统(IDS)采用基于启发式和基于签名的方法来检测恶意JS代码,但是在零日攻击的情况下,这种分析可能是无效的。机器学习(ML)应用目前正在各个行业积极开发,也在网络安全领域找到了自己的位置。ML已经证明了它对零基础攻击的有效性。在检测恶意JS代码方面,有来自自然语言处理(Natural Language Processing, NLP)、使用表格数据的标准ML和深度学习模型的不同方法。
由于有两种方法来分析程序的行为,ML模型的输入数据会有所不同:静态代码分析和动态代码分析。静态方法在不运行源代码的情况下分析数据,并且仅基于源代码。例如,这可以通过遍历代码抽象语法树来存档。相反,动态代码分析需要执行源代码。在这篇文章中,我们将只考虑静态分析的情况。
在本文中,我们将研究一些相关的工作,以了解研究人员为模糊JS代码检测提供了什么,还将考虑使用NLP特性和标准ML方法的组合对良性/恶意JS代码片段进行分类的任务。
相关工作
在“使用机器学习检测模糊JavaScript”中,作者使用了一个数据集,其中包括来自jsDelivr内容发布网络(Alexa排名前500的网站)的常规、缩小和模糊样本,以及来自瑞士信息保证报告和分析中心MELANI的一组恶意JavaScript样本。作者表明,区分混淆脚本和非混淆脚本是可能的,其精确度和召回率约为99%。使用了以下一组特性:
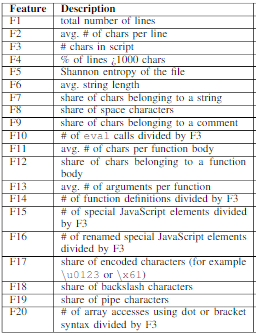
JavaScript 片段的静态特性
利用提取的特征向量集训练和评估三种不同的分类器:线性判别分析(LDA)、随机森林(RF)和支持向量机(SVM)。
在“使用AST特征和段落向量检测基于javascript的攻击的机器学习方法”中,作者使用了另一种方法从JS代码中提取特征。他们使用抽象语法树(AST)来表示代码结构,并将其作为Doc2Vec方法的输入。用于恶意JS代码的Marionette驱动下载数据和用于良性JS代码的JSUNPACK + Alexa前100个网站数据集被用作训练数据集。为了构建AST,作者使用了Esprima:一个句法和词汇分析工具。
以前的方法依赖于词汇和语法特性,而“基于双向LSTM模型的恶意JavaScript检测”中考虑的方法利用了语义信息。除了AST特性,作者还构建了程序依赖图(Program Dependency Graph, PDG),生成JS代码语义片,并将语义片转换为数值向量。然后输入双向长短时记忆(BLSTM)神经网络。BLSTM模型的准确率为97.71%,f1评分为98.29%。
综上所述,在静态分析的情况下,可以确定几种常见的JS代码特性:
- 方法1(自然语言):将JS代码视为自然语言文本。特征可以表示为字符集的统计量、文件的熵、特殊函数的计数、特殊符号的数量等。
- 方法2(词法特征):使用正则表达式提取纯js文本元素(如[a-z]+,并去除* *、=、!等特殊字符),结合NLP特征方法应用(如Bag-of-Words (BOW)、TF-IDF、Doc2Vec、LDA、embeddings等)。
- 方法3(语法特征):AST特征加NLP特征;
- 方法4(语义特征):获取 AST 特征 -> 构建控制流图 (CFG) -> 构建程序依赖图 (PDG) -> 获取语义切片 -> 转换为数值向量。
编码部分:良性/恶意JS代码分类
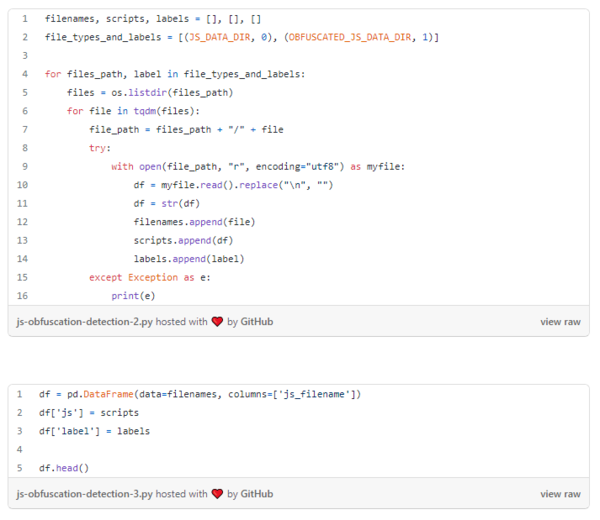
为此,我们将机器学习中的数据集用于网络安全指谱。为简单起见,我将使用上面提到的方法 1。
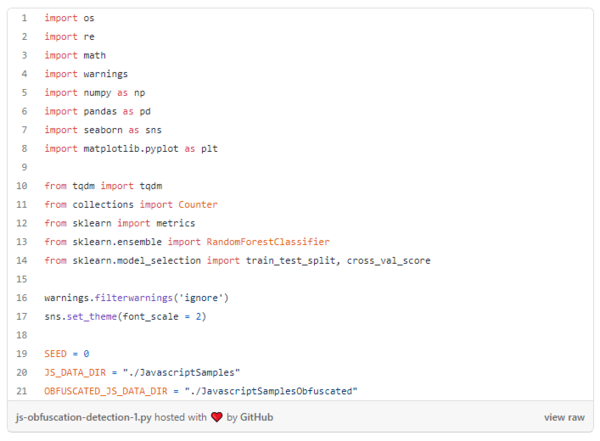
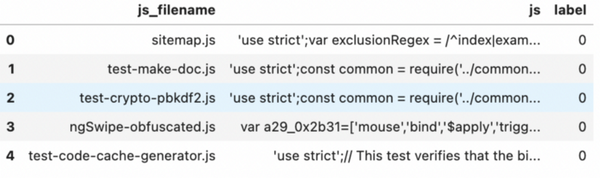
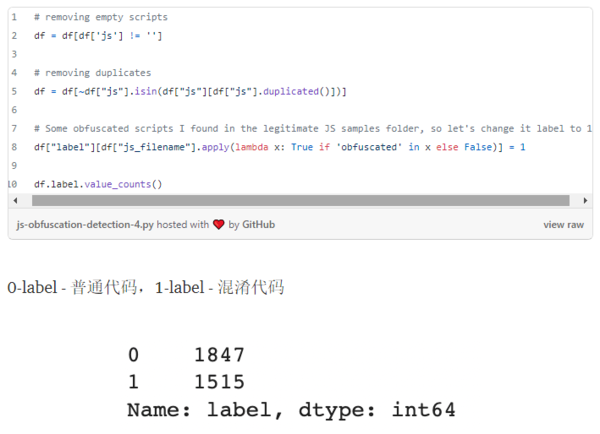
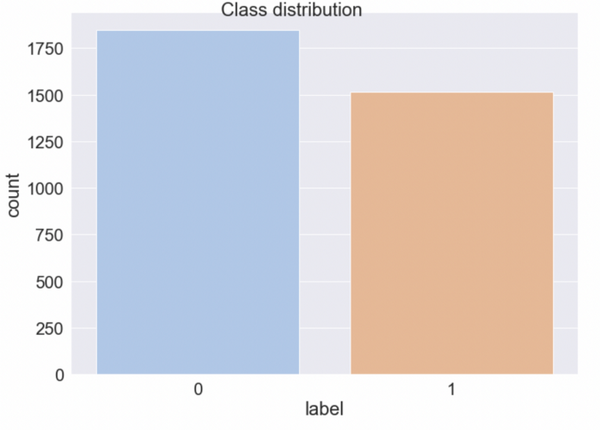
数据下载:
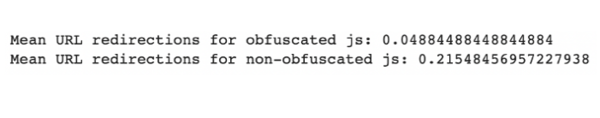
特征工程:
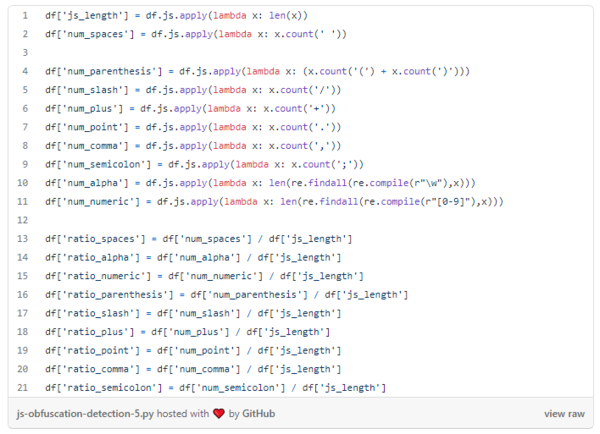
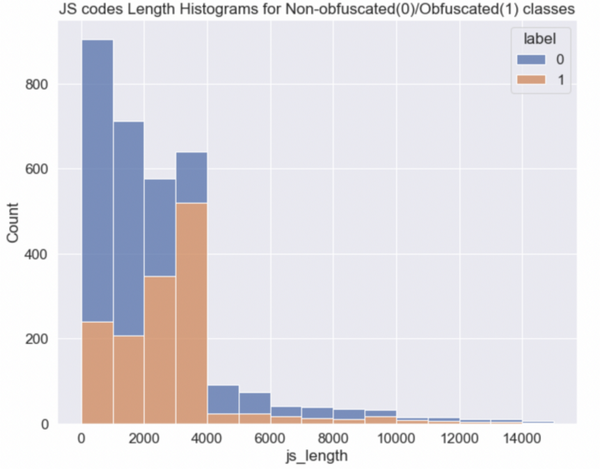
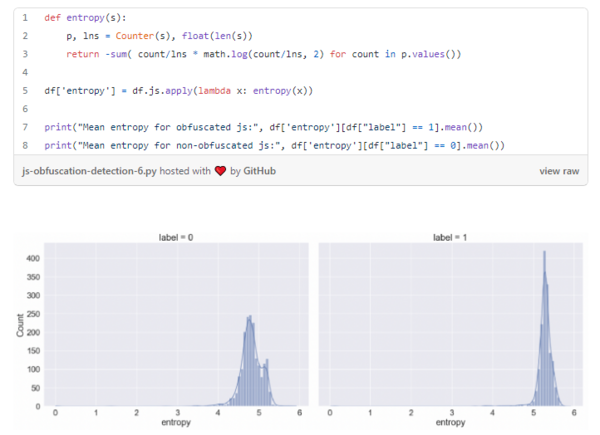
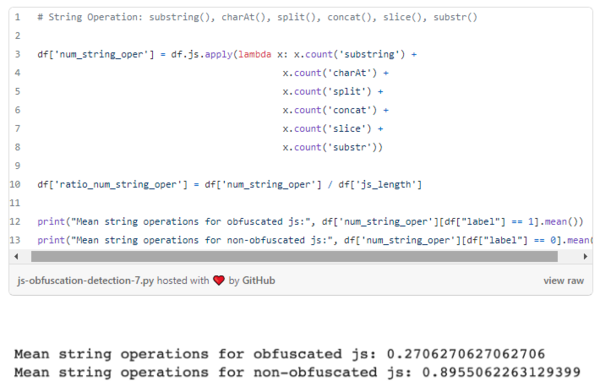
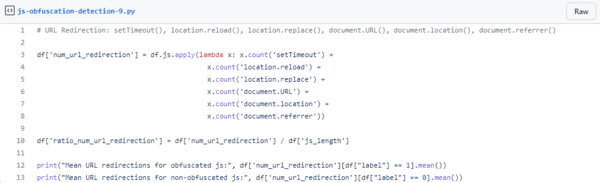
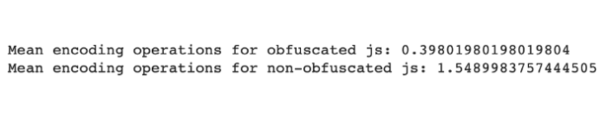
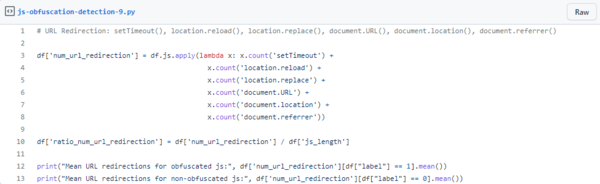
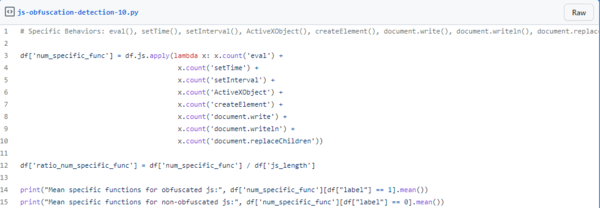
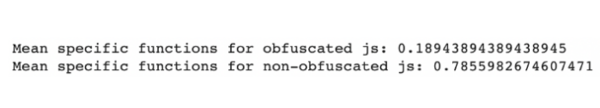
对于其他功能的想法,我使用了以下恶意 JS 代码中经常使用的 JS 函数列表:
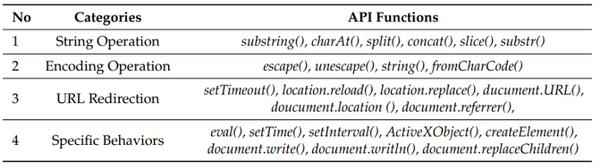
恶意 JavaScript 中广泛使用的函数
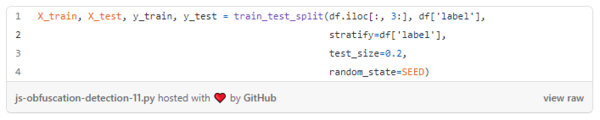
训练/测试数据拆分:
随机森林模型:
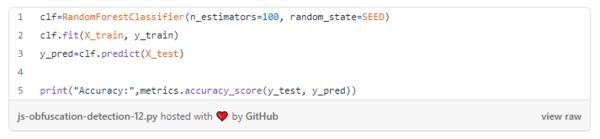
指标结果:
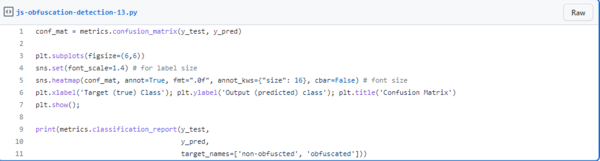
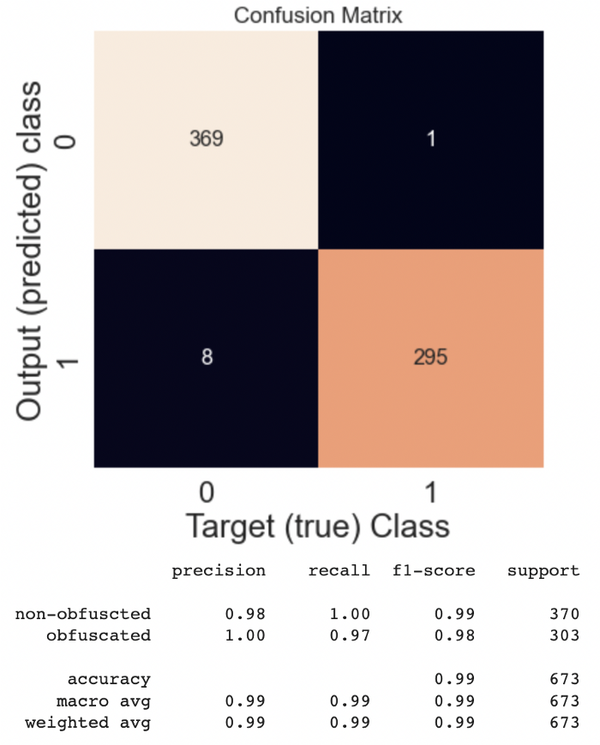
最后,完整代码也可以通过作者的GitHub访问查阅。
原文链接:https://pub.towardsai.net/detect-malicious-javascript-code-using-machine-learning-7709f9cdb7e7
