我们生活在一个令人兴奋的时代,因为我们看到我们周围的技术正以惊人的速度发展。我们还看到,数据正在取代原油,成为这一代企业最有价值的可用资源,现在向您展示机器学习算法的类型。
计算能力从传统的内部大型机数据中心过渡到易于使用和永远可伸缩的云计算,这释放了前所未有的使用数据的无限可能性。我们才刚刚开始利用数据的真正力量。
数据科学可能是目前技术和IT领域最著名的术语,我们正在看到几种工具和技术的民主化与计算机的发展同步。
利用几乎所有事物的数据,我们可以让计算机像人类一样学习和复制动作。我们还可以通过长期以现实世界观察的形式向他们提供数据和信息,以自主的方式提高他们的学习速度,这就是所谓的机器学习。
关键要点
- 机器学习是计算机通过数据和基于现实生活观察的算法应用来学习和复制人类行为的过程。
- 机器学习算法分为 3 类——监督学习、强化学习和无监督学习。
- 决策树算法主要用于机器学习应用的分类问题,它也适用于两种类型的分类和连续因变量。
- 线性回归算法以根据您要使用的应用程序根据一个或多个独立因素生成实际价值估计而闻名。
机器学习算法有哪些类别?
监督学习
监督学习算法包括需要从一组预测变量中预测的目标变量。通过利用这些预测变量,完成了从输入到期望输出的函数映射的生成。
训练过程一直持续到模型在训练数据上达到预设的准确度水平。监督学习的一些例子是决策树、随机森林、KNN、回归、逻辑回归等。
强化学习
强化学习算法使机器能够在训练后做出特定的决策。使用这些算法,机器在与环境不断交互后使用试错过程来训练自己。
机器学习是通过过去的测试及其输出发生的。它考虑了最有效地达到所需输出的过程,机器经过多次反复试验和错误循环,进一步完善了这个过程。强化学习的一个例子是马尔可夫决策过程。
无监督学习
在无监督学习的情况下,没有目标变量或任何期望的结果来实现。它主要用于将人口聚集在不同的群体中,这些集群组广泛用于将市场细分为不同的组。无监督学习的一些例子是 K-means 和 Apriori 算法。
机器学习算法的类型
一、决策树
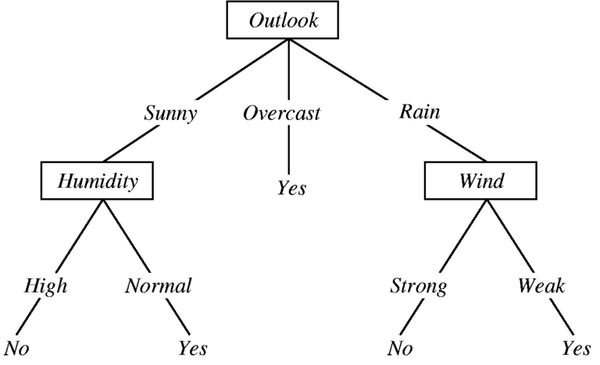
这是一种监督学习算法,在分类问题中有很多应用。它也是为数不多的同时适用于分类和连续因变量的算法之一。
该算法通过将人口分成两个或多个同质组来工作,这是通过更多的独立变量来实现的,以使其尽可能独特。
二、线性回归
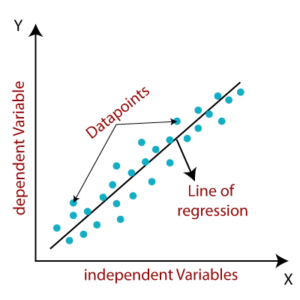
该算法用于根据您要使用的应用程序生成实际价值估计。这是通过使用连续自变量来预测因变量来实现的,通过 Y=aX + b 形式的线性方程在自变量和因变量之间建立关系。
在上式中,Y 是因变量,X 是自变量,a和b的值分别是斜率和截距,这些系数是从数据点和回归线之间距离的平方差之和的最小化得出的。
为了理解线性回归的整个概念,我们可以举个例子,我们可以带一个人,可以要求他们按体重增加顺序排列他们的同事,该人可以直观地分析各种因素,例如他/她的每个同事的构建类型和高度,基于这些变量,当以组合方式考虑时,将提供对每个人体重的良好估计。
三、逻辑回归
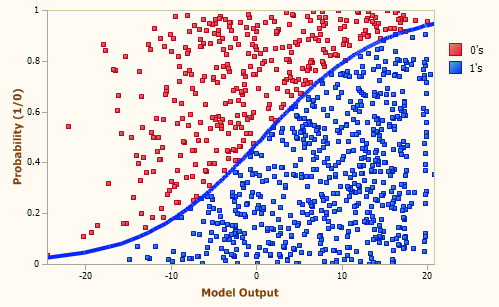
逻辑回归算法用于根据一组给定的自变量预测离散值。通过离散值,它表示真或假或 0 或 1。简单地说,此回归算法通过将数据拟合到 logit 函数来估计特定事件的发生概率。
这就是它也被称为 logit 回归的原因。由于该算法估计概率,它的输出值是 0 或 1 的形式。
让我们用一个例子来分解这个算法。
想象一下,你必须解决一个难题。现在,这个事件只有两种结果——要么你完成了这个谜题,要么你没有。
但是,如果给你各种各样的谜题来了解你擅长什么科目,它会产生不同的结果。这个实验的结果是这样的——如果给你一个分析谜题,你有 80% 的可能解决它。但是如果给你一个基于语言的谜题,你有 40% 的可能解决它,这就是逻辑回归所做的。
四、朴素贝叶斯
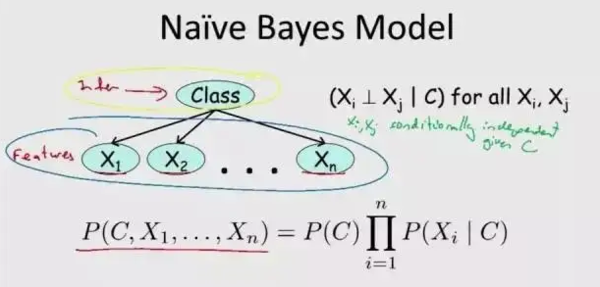
它是一种基于贝叶斯定理的分类算法,预测变量之间具有独立性。朴素贝叶斯分类器假定一个类中特定特征的参与与任何其他特征的存在无关。
例如,如果一个物体有光泽、反射光线并具有独特的光泽,则该物体被认为是钻石。现在,即使这些参数背后的原因可能相互依赖,朴素贝叶斯分类器也会考虑所有这些属性,以独立地贡献对象实际上是钻石的概率。
该算法易于应用,对于非常大的数据集尤其有效。但是不要误会它的功效,因为它甚至优于最复杂的分类算法。
五、支持向量机
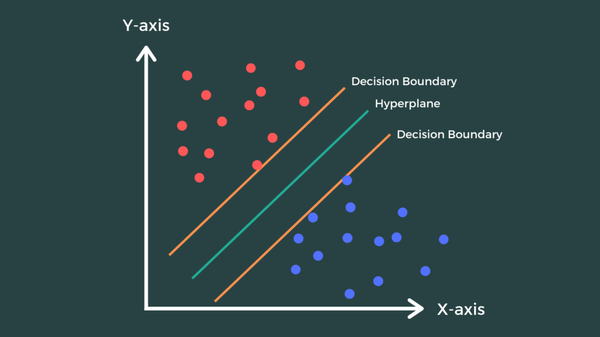
这也是一种分类算法。该算法使用每个数据点的图作为 n 维空间中的一个点,每个属性的值都是特定坐标的值。在 n 维空间中,n 表示您正在考虑的特征的数量。
简而言之,该算法的目标是在 n 维空间中找到一个对数据点进行唯一分类的超平面。为了分离这两类数据点,存在各种可能的超平面并且可以选择。但目标是找到一个具有最大余量的平面。
这里,边距定义为两类数据点之间的最大距离。通过最大化边距距离,它将增强未来数据点的分类置信度。
六、k-均值
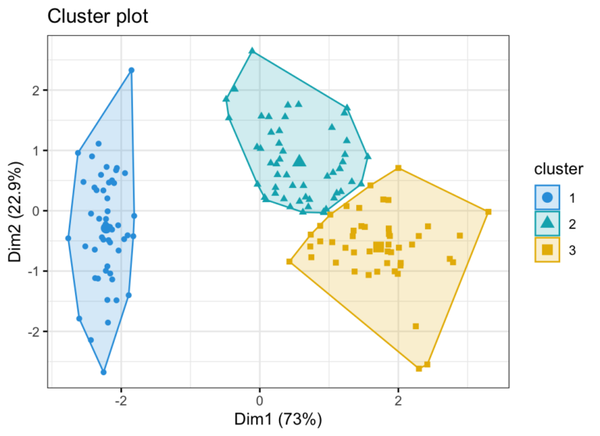
这是一种无监督学习算法,它解决了数据点的聚类问题。该算法提供了一种通过一组集群对提供的数据集进行分类的简单方法。这个集合的簇数被假设为k个簇。
集群内的所有数据点本质上都是同质的。但是这些集群本身是异质的,因此形成了不同的群体,图提供了集群及其分组的外观。
K-means 集群是通过一个过程形成的。首先,K-means 算法为每个簇取 k 个质心。每个数据点围绕最近的质心形成一个簇。然后它根据现有的集群成员找到每个集群的质心。
这导致为每个集群创建新的质心。当找到每个数据点与新质心的最近距离时,该过程会不断重复,然后与新形成的 k 簇相关联。在没有新质心出现的完全收敛发生后,此过程停止。
七、随机森林
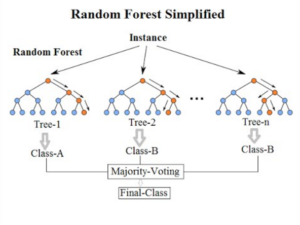
随机森林算法基本上是决策树的集合,是一种用于分类、回归和各种其他任务的集成学习方法,考虑到决策树或“森林”的集合来实现该算法。
随机森林算法通过森林中的每一棵树进行分类预测,获得最大票数的类成为模型的预测。随机森林真正有效工作的原因是它利用大量不相关的树作为委员会工作。
模型之间的低相关性是整个算法的关键要素。不相关的树可以提出比其单独估计更准确的整体估计。
这背后的原因是这些树相互保护免受各自的不准确/错误的影响。但它并没有摆脱这样一个事实,即会有几棵树的错误预测指向错误的方向。只要这组树朝着正确的方向移动,随机森林就可以正常工作。
八、k-最近邻
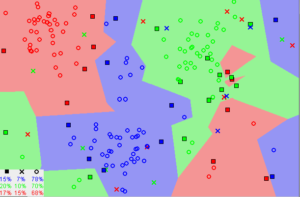
它采用了“同归于尽”的概念,并通过该算法提供了一个非常强大的应用程序。
k-Nearest Neighbors 或 kNN 算法的工作假设是相似的事物属于一起。或者更准确地说,它们非常接近。在给出的图像中,您可以看到相似的数据点被分组在一起。
分组是基于数据点之间的相似性(通常由欧几里得距离确定)完成的,但是还有许多其他方法可以计算图形上点之间的直线距离。
kNN 算法的优点是在大量用例上实现起来非常简单方便,它还消除了构建模型和管理众多参数的繁琐任务。
也不需要提供任何假设,这就是 kNN 算法用途广泛的原因。它可用于搜索、分类和回归。但是,当加载更多数量的预测变量时,该算法会变得明显变慢。
九、主成分分析 (PCA)
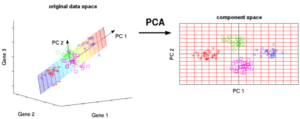
PCA 是一种机器学习算法,它使用正交变换将一组可能相关的变量的数据点转换为一组标记为主成分的线性不相关变量的值。
PCA 的一些用例用于压缩、简化数据以便于理解和可视化。尽管在将 PCA 作为其用例中首选的机器学习之前,需要具备足够的领域知识。
十、独立成分分析(ICA)
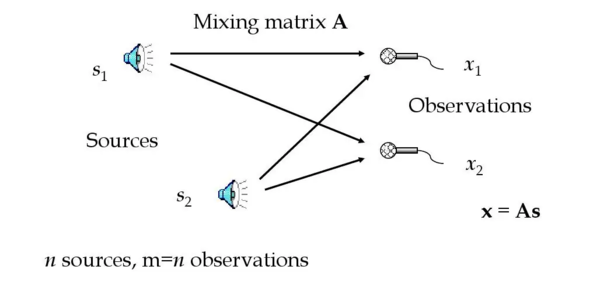
独立分量分析 (ICA) 是一种机器学习技术,用于从混合信号中区分和分离源。独立成分分析的工作原理是独立成分,而不是主成分分析。它是一种在随机变量或信号集中挖掘隐藏因素的统计方法。
该算法为观察到的多变量数据定义了一个生成模型,该模型通常以大量数据集的形式给出。在模型中,假设信号是一些未知潜变量的线性组合。组合系统也是未知的。
潜变量被假定为非高斯且相互独立。这些被称为观测数据的独立成分。这些自变量被称为使用 ICA 找到的因子。
结论
希望这篇文章能让你对常用的不同类型的机器学习算法有一个公平的了解,不同类型的机器学习算法可用于解决不同类型的问题,应根据要求以及最适合您的方式做出决定。
机器学习在我们的日常生活和业务中的应用已经产生了影响,如果您对机器学习感兴趣或已经在使用机器学习,您应该考虑探索机器学习如何使企业的需求受益的各种方式。如果你真的很擅长机器学习,你甚至可以开始自己的业务,但建议先从较小的模型项目开始,然后再进行更大规模的尝试。
原文链接:https://verzeoedu.medium.com/10-most-popular-types-of-machine-learning-algorithms-61e065793a96
