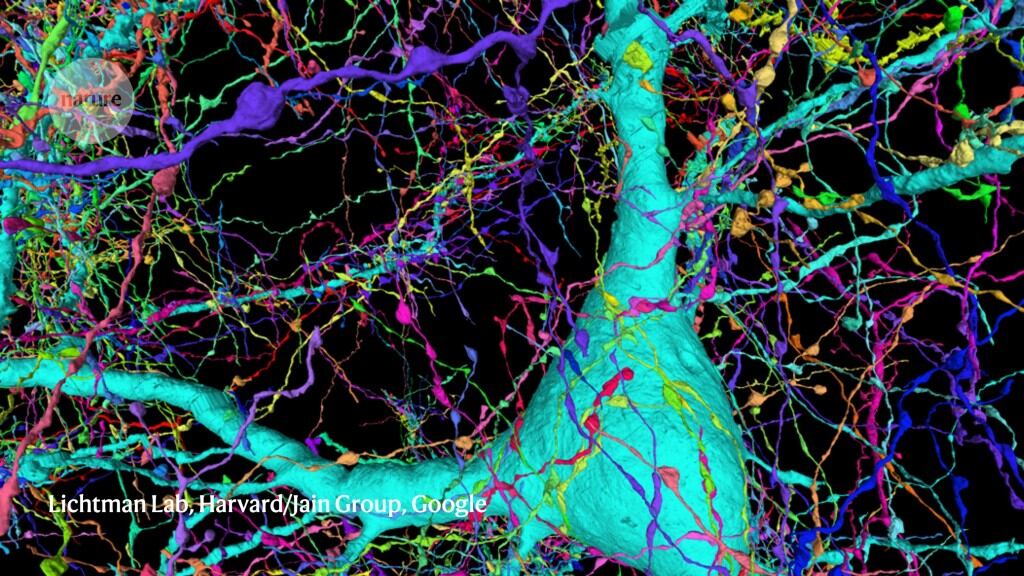
一立方毫米听起来并不多。但在人脑中,这一体积的组织包含约5万根神经“线”由1.34亿个突触连接。
为了获得原始数据,马萨诸塞州剑桥市哈佛大学的分子和细胞生物学家 Lichtman 使用了一种被称为串行薄切片电子显微镜的方法,在11个月的时间里对数以千计的组织切片进行成像。但是数据集非常庞大,达到了1.4PB——相当于大约200万张CD—ROM,对于研究人员来说,单靠他们自己的力量是远远不够的。人类根本不可能手动追踪所有的神经线,地球上没有足够的人能真正有效地完成这项工作。
这在连接组学(研究大脑结构和功能连接的学科)和其他生物科学中都是常见的重复,在这些科学中,显微镜技术的进步创造了大量的成像数据。但当人力资源失败时,计算机可以介入,尤其是深度学习算法,它经过优化,可以从大型数据集中梳理出模式。
麻省理工学院和哈佛大学布罗德研究所(Broad Institute of MIT and Harvard)的计算生物学家Beth Cimini说:“在过去的几年里,我们真的经历了深度学习工具的寒武纪大爆发。”
深度学习是一种人工智能(AI)技术,它依赖于多层人工神经网络,灵感来自于大脑中神经元相互连接的方式。由于这些算法基于黑箱神经网络,因此也有其局限性,这包括依赖大量数据集来教会网络如何识别感兴趣的特征,以及有时难以理解的生成结果的方法。但大量快速增长的开源和基于网络的工具正使它比以往任何时候都更容易开始。
向深度学习迈进
马萨诸塞州的伍兹霍尔海洋研究所(Woods Hole Oceanographic Institute)和欧洲生物图像分析师全球网络NEUBIAS等组织都提供如何开始深度学习的课程。开放生物图像分析中心是麻省理工学院布罗德研究所和位于马萨诸塞州剑桥市的哈佛大学的合作项目,威斯康星大学麦迪逊分校赞助了有关科学图像软件的讨论论坛 image.sc。研究人员还可以梳理Kaggle的老挑战:为科学家和人工智能爱好者举办的计算竞赛,寻找模型和数据的例子,以便他们进行练习和学习。“所有的数据和训练集都是可用的,你可以查看获奖模型的代码和描述,所以这是一个非常好的起点,”加州斯坦福大学的生物工程师 Emma Lundberg说。
研究人员可能还想从Cellpose、StarDist和DeepCell等工具集中预先训练的模型开始,这些模型可以通过web界面使用,作为ImageJ和napari软件生态系统的插件或者作为独立的应用程序。布罗德研究所的计算生物学家Beth Cimini说:“他们训练的模型在相当一部分用例中都很有效。你不需要真正知道它们在做什么,也不需要了解深度学习网络是如何工作的,你只需要稍微调整一下旋钮,直到你得到一个好的结果。”对于那些需要更大的可定制性的人,Piximi和ImJoy允许研究人员训练他们自己的神经网络来识别各种表型,并在图像中定位细胞,这个过程被称为分割。
大多数这样的工具都可以在浏览器中运行。ZeroCostDL4Mic是一个用于显微镜深度学习的开源工具箱,它使用谷歌的计算笔记本平台Colab,允许研究人员在云中训练各种流行的开源模型,以及访问可以在云中运行的预训练模型。此外还有生物图像模型动物园(BioImage Model Zoo),这是一个一站式商店,为流行的使用案例提供开源的预训练模型。
研究人员还可以安装并运行专用软件。例如,ilastik有一个指向点击的界面,不仅可以帮助检测细胞和细胞核,还可以检测微管和囊泡等特征。该软件的联合开发者Anna Kreshuk是德国海德堡欧洲分子生物实验室的计算机科学家,她和她的同事们正在努力提高该软件训练神经网络的能力,以完成分类和分割等任务。“每个人都需要细分,”她说,“但每个人都在细分不同的东西。”在不受支持的调试模式中已经有一个训练特性可用。
学习编程,特别是Python编程,可以帮助想要定制或训练新模型的研究人员。“这真的会给你带来优势,比如你可以更自由地操纵你的数据,应用人们没有特别为你包装的最好的方法,”Kreshuk说。一个或多个图形处理单元和能够使用它们的计算机也会很有帮助。
但软件和硬件都不如数据重要。“任何深度学习中最困难、最耗时的部分是获取训练数据。如果你的数据很糟糕,那么你的模型也会很糟糕,”Cimini说。“你通常至少需要数百或数千个例子,而创建注释本身是冗长乏味的。”
理想情况下,数据集应该是庞大而多样的,如果人类能够明确地识别深度学习模型被要求寻找的任何东西,这将有所帮助。位于帕萨迪纳市的加州理工学院的生物工程师David Van Valen说:“人们期望这些模型能创造奇迹,但如果你想要提取的信息不在数据中,那么在我看来,在我的经验中,它不太可能奏效。”
深度学习算法有效地像黑匣子一样运行,但一些工具可以为它们的推理提供线索。Cimini说:“例如,你可以分辨出图像的哪一部分对做出某个决定最重要。”
目前,像识别细胞或细胞核这样明确但繁琐的任务是理想的,因为人类可以很容易地验证结果。但随着算法的改进,研究人员野心的规模和范围也将发生变化。“这是一个非常令人兴奋的领域,”Cimini说。“我认为这将使很多人的工作生活更轻松。”
以下是深度学习对生物图像分析产生深远影响的五个领域:
- 大规模神经连接组学
深度学习使研究人员能够从果蝇、老鼠甚至人类身上生成越来越复杂的神经连接体,这些数据可以帮助神经科学家了解大脑是如何工作的,以及大脑结构在发育和疾病中是如何变化的,但神经连接并不容易绘制。
2018年, Lichtman与加利福尼亚州山景城谷歌的神经连接组学主管Viren Jain合作,后者在为他的团队的AI算法寻找合适的挑战。
“连接组学中的图像分析任务非常困难,”Jain说。“你必须能够跨越很远的距离追踪这些细丝,细胞的轴突和树突,而传统的图像处理方法犯了太多的错误,它们基本上无法完成这项任务。”这些导线可以比一微米还细,可以延伸到数百微米甚至毫米的组织中。深度学习算法提供了一种方法,使连接组学数据的分析自动化,同时仍能达到较高的准确性。
在深度学习中,研究人员可以使用包含感兴趣特征的注释数据集来训练复杂的计算模型,以便快速识别其他数据中的相同特征。德国海德堡欧洲分子生物实验室(European Molecular Biology Laboratory)的计算机科学家Anna Kreshuk表示:“当你在进行深度学习时,你会说,‘好吧,我就举个例子,你把一切都弄明白’。”
但是,即使是使用深度学习,Lichtman和 Jain在绘制人类皮层的图谱时也面临着艰巨的任务。仅为5000个左右极薄的组织切片成像就花了326天,两名研究人员花了大约100个小时手工标注图像,并追踪神经元,创建“基本真相”数据集来训练算法,这种方法被称为监督机器学习。然后,经过训练的算法自动将图像拼接在一起,识别神经元和突触,生成最终的连接组。
Jain的团队为解决这一问题投入了大量的计算资源,包括数千个张量处理单元(TPU),这是谷歌内部的相当于专门为神经网络机器学习而构建的图形处理单元(GPU)。Jain说,处理数据需要在几个月的时间里达到100万TPU小时量级,之后人类志愿者在协作过程中对连接组进行校对和更正,“有点像谷歌文档”,Lichtman说。
他们说,最终的结果是,在任何物种中,在这种详细程度上重建的这种数据集是最大的。尽管如此,它只占人脑的0.0001%。但随着算法和硬件的改进,研究人员应该能够绘制更大的大脑区域,同时有分辨率发现更多的细胞特征,如细胞器甚至蛋白质。“在某些方面,”Jain说,“我们只是触及了从这些图像中可能提取到的东西的表面。”
- 虚拟组织学
组织学是医学上的一个关键工具,并被用于在化学或分子染色的基础上诊断疾病。但这很费力,整个过程可能需要几天甚至几周的时间才能完成。活组织切片成薄片,染色以显示细胞和亚细胞特征,然后病理学家阅读切片并解释结果,加州大学洛杉矶分校(University of California, Los Angeles)的电子和计算机工程师Aydogan Ozcan认为他可以加速这个过程。
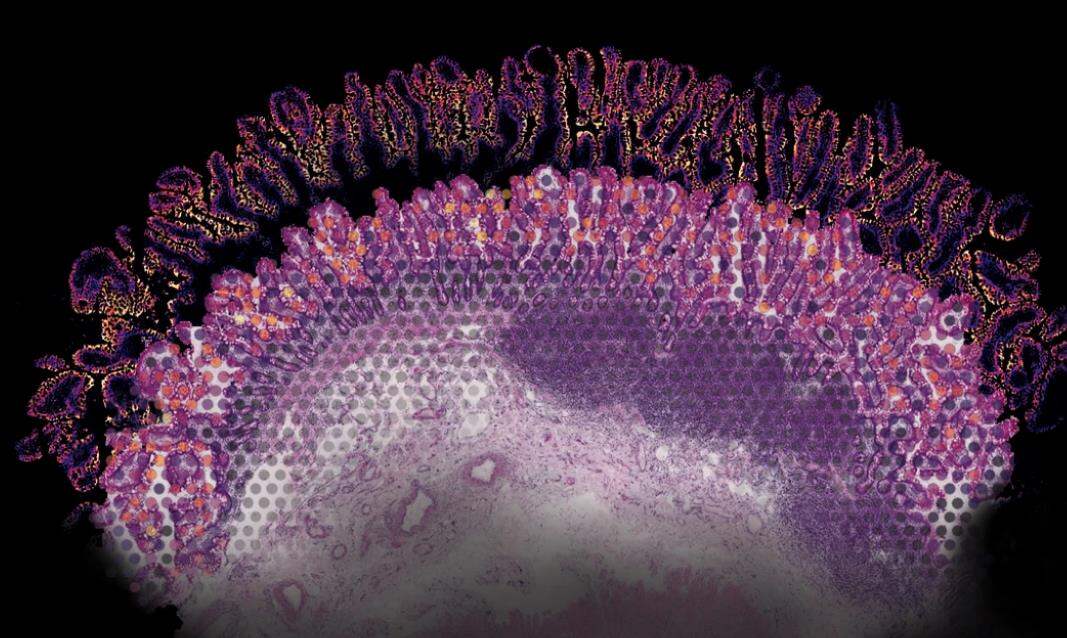
Ozcan训练了一个定制的深度学习模型,通过向它展示同一切片的数万个未染色和染色版本的例子,并让模型计算出它们之间的差异,从而对组织切片进行染色计算。
虚拟染色几乎是瞬间完成的,经过认证的病理学家发现,几乎不可能将结果图像与常规染色图像区分开。Ozcan还表明,该算法可以在几秒钟内复制乳腺癌生物标志物HER2的分子染色,而在组织实验室中,这一过程通常需要至少24小时。一个由三名经委员会认证的乳腺病理学家组成的小组认为,这些图像的质量和准确性与传统的免疫组织化学染色相当。
Ozcan的目标是将虚拟染色商业化,他希望在药物开发中看到应用。但他说,通过消除对有毒染料和昂贵染色设备的需求,该技术还可以增加世界范围内组织学服务的可及性。
- 细胞发现
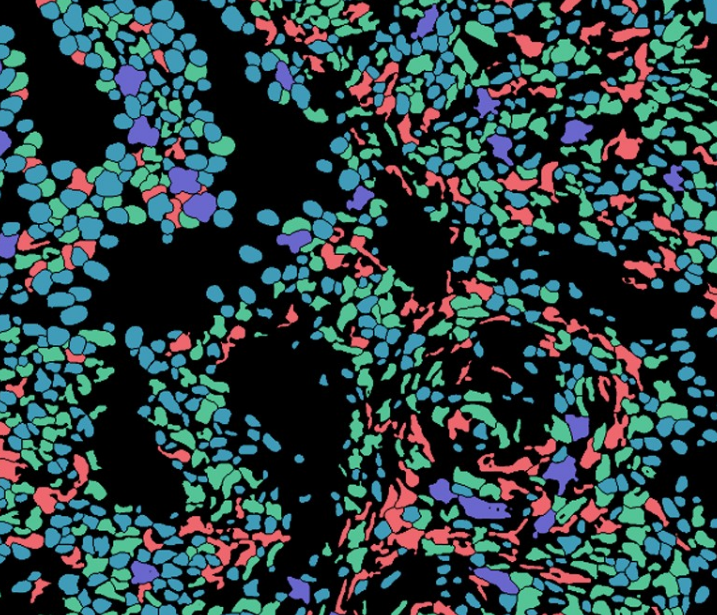
如果你想从细胞图像中提取数据,你必须知道细胞在图像中的实际位置。
研究人员通常通过在显微镜下观察细胞或在软件中逐个图像勾勒出细胞的轮廓来执行这个过程,称为细胞分割。位于帕萨迪纳市的加州理工学院的计算生物学家Morgan Schwartz正在开发用于生物图像分析的深度学习工具,他说:“最能描述人们一直在做的事情的词是‘苦心经营’。”但随着成像数据集变得越来越大,这些艰苦的方法正在碰壁。“如果没有自动化过程,你就无法分析其中一些实验。”
Schwartz的研究生导师、生物工程师David Van Valen创建了一套人工智能模型,可以在deepcell.org上找到,用来从活细胞和保存的组织的图像中计算和分析细胞和其他特征。Van Valen与包括加利福尼亚斯坦福大学癌症生物学家 Noah Greenwald合作,开发了一种名为Mesmer的深度学习模型,可以快速、准确地检测不同组织类型的细胞和细胞核。Van Valen说:“如果你有需要处理的数据,现在你只需要上传它们,下载结果,并在门户网站或使用其他软件包中可视化。”
据 Noah Greenwald说,研究人员可以利用这些信息来区分癌组织和非癌组织,并寻找治疗前后的差异。他说:“你可以观察基于图像的变化,以更好地了解为什么有些病人有反应或没有反应,或者识别肿瘤的亚型。”
- 映射的蛋白质定位
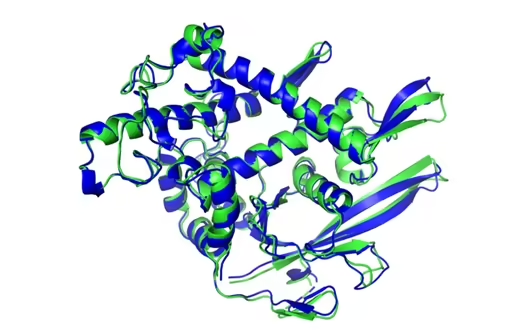
人类蛋白质图谱项目利用了深度学习的另一个应用:细胞内定位。“几十年来,我们一直在生成数百万张图像,勾勒出人体细胞和组织中的蛋白质表达,”斯坦福大学生物工程师、该项目负责人Emma Lundberg说。起初,该项目手动注释这些图像,但由于这种方法无法长期持续,Lundberg转向了人工智能。
Lundberg首先将深度学习与公民科学结合起来,让志愿者在玩大型多人游戏《EVE Online5》时,对数百万张图像进行注释。在过去几年里,她转向了一种只面向人工智能的众包解决方案,发起了Kaggle挑战——科学家和人工智能爱好者在其中竞争完成各种计算任务,奖金为3.7万美元和2.5万美元,目的是设计有监督的机器学习模型,对蛋白质图谱图像进行标注。Lundberg说:“后来的Kaggle挑战让玩家们大吃一惊。获胜的模型比Lundberg先前在蛋白质定位模式的多标签分类方面的努力高出约20%,并且可在细胞系中推广。她补充说,他们做到了以前发表的模型没有做到的事情,那就是准确地对存在于多个细胞位置的蛋白质进行分类。
Lundberg说:“我们已经证明,一半的人类蛋白质定位于多个细胞隔层。”位置很重要,因为相同的蛋白质在不同的地方可能表现不同。她说:“知道一种蛋白质是在细胞核里还是在线粒体里,有助于了解它的许多功能。”
- 跟踪动物行为
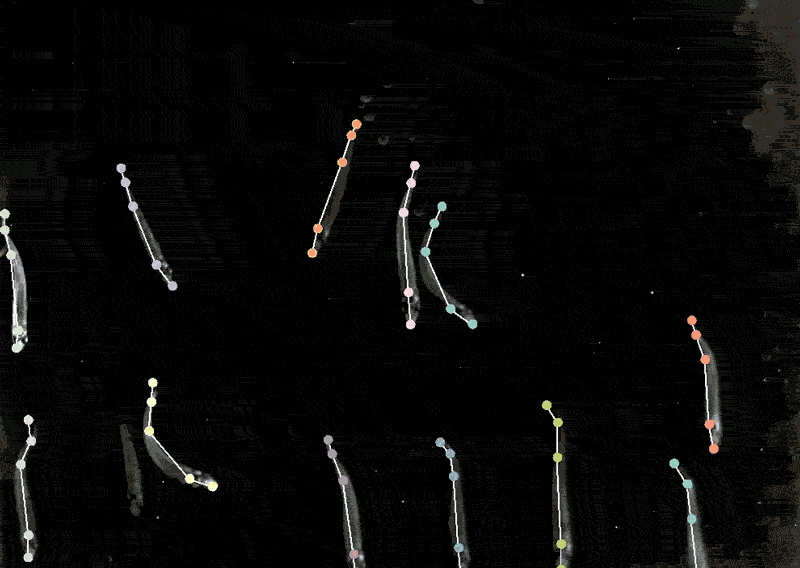
位于日内瓦洛桑的瑞士联邦理工学院校园生物技术中心的神经科学家Mackenzie Mathis长期以来一直对大脑如何驱动行为感兴趣,她开发了一个名为DeepLabCut的程序,使神经科学家能够从视频中跟踪动物的姿势和精细动作,将“猫视频”和其他动物的记录转化为数据。
DeepLabCut提供了一个图形用户界面,这样科学家就可以上传和标记他们的视频,并在点击一个按钮时训练一个深度学习模型。今年4月, Mathis的团队扩展了该软件,可以同时估计多种动物的姿势,这对人类和AI来说通常都是一个挑战。
将多动物DeepLabCut应用到绒猴身上,研究人员发现,当这些动物靠近时,它们的身体是对齐的,它们倾向于看向相似的方向,而当它们分开时,它们倾向于面对彼此。 Mathis说:“这是一个很好的例子,姿势确实很重要。如果你想了解两只动物是如何相互作用的,如何观察对方或观察世界。”
原文链接:https://www.nature.com/articles/d41586-022-02964-6
