人工智能系统使用广泛的数据进行训练,这通常包括个人信息。分布式机器学习可以改善AI开发中的数据保护,因为使用的数据是在用户的设备上处理的,而不是在中央服务器上。然而,攻击者也有更多的潜在入口。德国平台“学习系统”(Learning Systems)在最新一期的“AI at a glance”中做了概述。
在分布式机器学习中,每个终端设备访问当前模型,并使用自己的数据集对其进行本地训练,因此,潜在的个人数据不需要通过中央服务器进行处理。
为了更新和改进ML模型,与其他终端设备共享的不是实际数据,而是训练结果(称为权重)。分布式机器学习有三种技术途径:
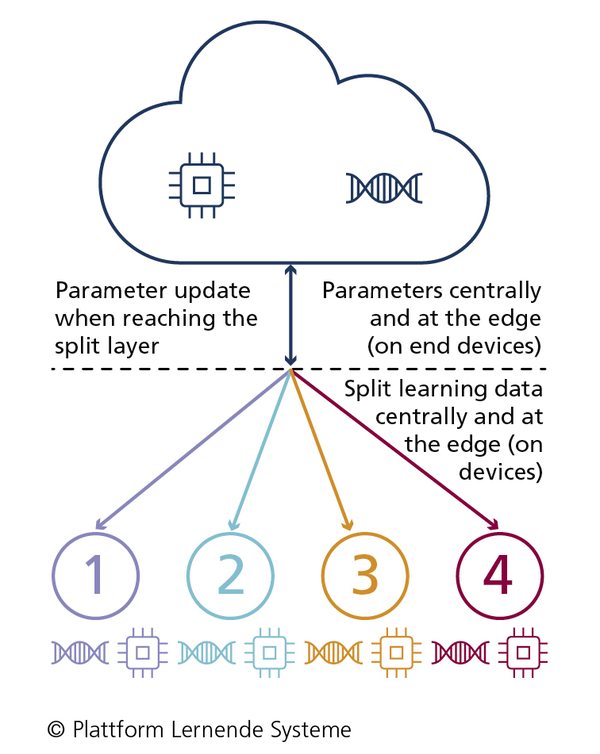
拆分学习
在拆分学习中,人工智能模型分别在端点和服务器上进行训练。
- ML模型被分成不同的子模型(所谓的链接),并在端设备(客户端)和服务器上进行训练,而不共享原始数据(计算负载的有效分布)。
- 迭代训练过程:在ML模型的分裂点(所谓的分割层),终端设备和服务器只交换经过训练的ML模型部分的结果(权重)(而不是原始数据),并在自己的数据集上继续使用这些结果进行训练(降低通信成本)。
- 当终端设备的ML模型和服务器之间达到收敛时,迭代结束。
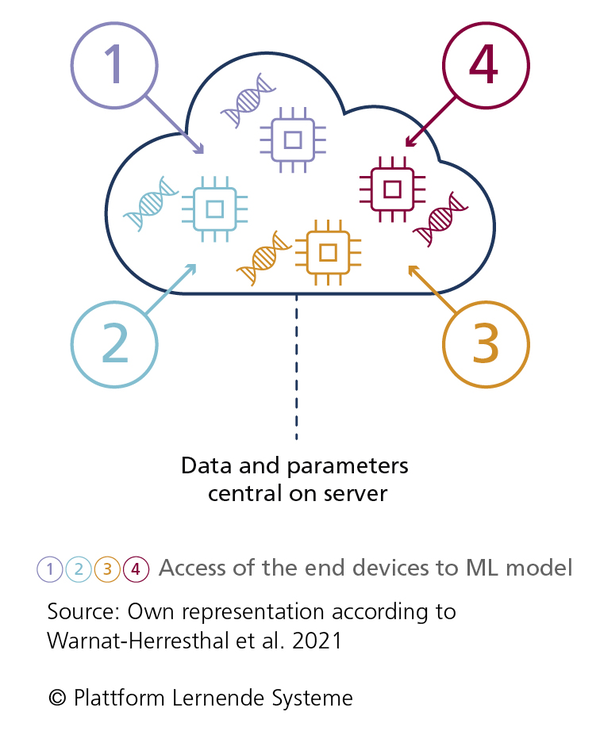
联邦学习
在联邦学习中,中央服务器充当权重的聚合实例。
- 终端设备从服务器下载ML模型的参数
- ML模型由终端设备用本地数据集进行训练
- 终端设备只向服务器发送权重;本地数据集保留在终端设备中
- 在服务器上没有进行任何训练,只有权重的组成,用于ML模型的中央更新(推理)
- 服务器提供改进后的参数,因为同步,ML模型对端设备进行新的训练
- 这个过程可以根据需要重复很多次,分布式ML模型可以不断地进一步优化自己
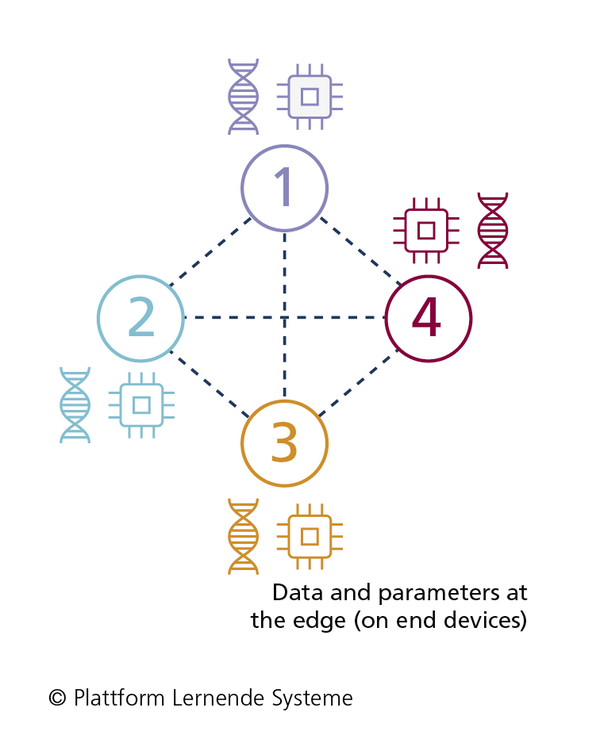
群体学习
在群学习中,人工智能模型是在没有中央聚合实例的分布式设备上进行训练。
- ML模型的参数存储在访问受限的区块链中,而不是存储在中央服务器上
- 没有协调实例,但有一个中央实例,用于访问区块链所需的终端设备的预授权
- 终端设备从区块链加载ML模型的参数,并可以使用本地数据集对其进行训练
- 训练结束后,只有调整后的重量存储在区块链中
- ML模型调整后的权重和参数可被终端设备读取,并在本地组装形成整体模型
分布式机器学习的应用实例
拆分学习的一个潜在应用是自动驾驶的图像识别。一个基本图像识别模型的持续改进可以分布在许多车辆上,每辆车都使用其传感器数据来改进模型。然后,它们将本地训练的参数提供给中央服务器上的基本模型,以进行进一步训练。通过这种方式,与隐私相关的路由完全在本地处理。
另一个例子是本地训练智能手机自动补全和校正的AI模型。通过联邦学习,只有模型的权重与中央服务器共享。用智能手机写的短信可以提供生活状况的线索,甚至可以泄露公司机密,因此会保留在手机上。
群体学习可以帮助诊断疾病而不用担心隐私问题。该诊断模型在区块链上分发给通过健康保险公司获得执照的各诊所,中心模型的参数由诊所检索,局部合并为整体模型,并使用当地健康数据进行训练。然后将更新后的模型的参数同步回区块链,医疗敏感的个人信息不会被转移。
分布式机器学习的优点和缺点
“分布式机器学习为有效和可扩展地使用数据而不必共享数据开辟了新的可能性”。德国达姆施塔特理工大学计算机科学教授、Plattform Lernende Systeme的IT安全和隐私工作组成员Ahmadi - Reza Sadeghi说。
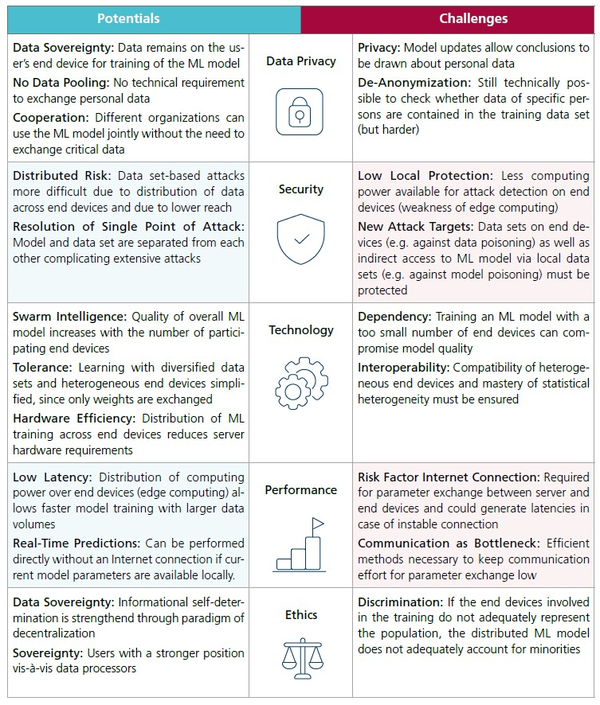
但也存在挑战:跨多个端点分布数据和训练过程为攻击者创造了新的入口。此外,分布式机器学习需要Internet连接来进行参数交换,这可能会导致不稳定。
模型更新允许对个人数据得出结论。此外,可以在训练数据集中识别个人的数据。下图提供了优点和缺点的概述:
总结
- 分布式机器学习为隐私友好的AI模型训练提供了巨大的潜力,例如在自动驾驶或医疗领域。
- 基本原理是,人工智能训练所用的数据在用户的终端设备上处理,而不是在中央服务器上处理。
- 然而,这为攻击创造了更多潜在的网关。
原文链接:https://the-decoder.com/distributed-machine-learning-can-improve-ai-data-protection/
