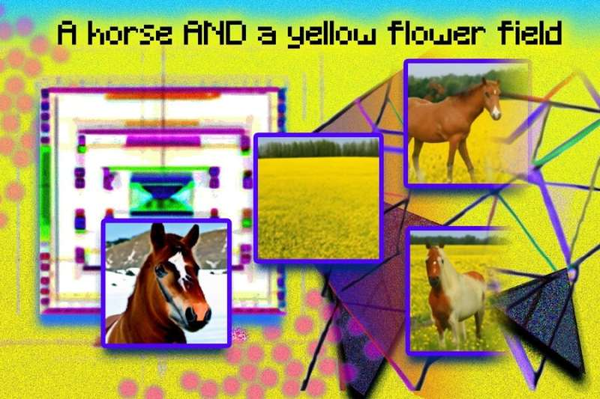
人工智能图像生成器在网络的每个角落都能创造出梦想与现实交汇的奇幻景象,它们的娱乐价值体现在不断扩大的奇思妙想和随机图像的宝库中,这些图像是人类设计师大脑的间接入口,一个简单的文字提示就能产生几乎即时的图像,从而满足了我们原始的大脑,这是与生俱来的即时满足。
尽管人工智能生成的艺术领域看似新生,但可以追溯到20世纪60年代,早期尝试使用基于符号规则的方法来制作技术图像。虽然对单词进行梳理和解析的模型已经变得越来越复杂,但生成艺术的爆发引发了关于版权、虚假信息和偏见的辩论,所有这些都陷入了炒作和争议。
麻省理工学院计算机科学与人工智能实验室(CSAIL)电子工程与计算机科学系的博士Yilun Du最近开发了一种新方法,使诸如DALL-E 2 这样的模型更具创造性,并具有更好的场景理解能力。
在这里,Yilun Du教授描述了这些模型是如何工作的,这种技术基础设施是否可以应用到其他领域,以及我们如何在人工智能和人类创造力之间划清界限。
麻省理工学院Yilun Du博士解释 AI 图像生成器
问:人工智能生成的图像使用一种叫做“稳定扩散”的模型,可以在短短几分钟内将文字变成令人惊叹的图像,但每张图片背后通常都有一个人。那么,人工智能和人类创造力之间的界限是什么?这些模型究竟是如何工作的?
答:想象一下你能在谷歌搜索上得到的所有图像和它们的相关模式,这就是这些模型的饮食。它们接受了所有这些图像及其标题的训练,以生成与它在互联网上看到的数十亿张图像相似的图像。
假设一个模特看过很多狗的照片,经过训练,当它得到类似的文本输入提示,如“狗”,它能够生成一张照片,看起来非常类似于许多已经见过的狗的照片。现在,从方法论上讲,这一切是如何运作的,可以追溯到一个非常古老的模型,叫做“基于能量的模型”,起源于70年代或80年代。
在基于能量的模型中,在图像上构建能量景观,用来模拟物理耗散来生成图像。例如,当你把一点墨水扔到水里,它就会消散,到最后,你只会得到这种均匀的纹理。但如果你试图逆转这个消散的过程,你就会逐渐地让原来的墨点再次回到水中。
或者假设你有一个非常复杂的积木塔,如果你用球打它,它就会倒塌成一堆积木。这一堆积木是非常无序的,没有太多的结构。为了恢复塔,你可以尝试反向这个折叠过程来生成你原来的积木堆。
这些生成模型生成图像的方式是非常相似的,最初,你有一个非常漂亮的图像,你从这个随机的噪声开始,你基本上学习如何模拟这个过程如何将这个过程逆转从噪声回到你的原始图像,你尝试迭代地改进这个图像使它越来越真实。
至于人工智能和人类创造力之间的界限是什么,你可以说这些模型真的是训练人的创造力。互联网上有人们过去已经创作的各种类型的绘画和图像,这些模型经过训练,可以再现和生成互联网上的图像。因此,这些模型更像是数百年来人们把创造力花在什么上面的结晶。
与此同时,由于这些模型是根据人类的设计进行训练的,它们可以生成与人类过去所做的非常相似的艺术作品,他们可以在人们创作的艺术作品中找到图案,但对这些模特来说,真正靠自己创作出有创意的照片要困难得多。
如果你尝试输入“抽象艺术”或“独特艺术”或类似的提示,它并不能真正理解人类艺术的创造性方面。可以说,这些模型是对人们过去所做的事情的再现,而不是产生全新的创造性艺术。
由于这些模型是根据来自互联网的大量图像进行训练的,这些图像中有很多可能是有版权的。当模型生成新图像时,您并不确切地知道它在检索什么,因此如何确定模型是否使用了受版权保护的图像是一个大问题。如果模型在某种意义上,依赖于一些受版权保护的图像,那么这些新图像受版权保护吗?这是另一个需要解决的问题。
问:你认为通过扩散模型生成的图像编码了某种对自然或物理世界的理解吗?无论是动态的还是几何的?有没有努力“教”图像生成器婴儿很早就学会的宇宙的基本知识?
答:他们能通过代码理解自然和物质世界吗?我想是肯定的。如果你要求一个模型生成一个稳定的块配置,它肯定会生成一个稳定的块配置。如果你告诉它,生成一个不稳定的块配置,它看起来确实很不稳定。或者如果你说“湖边的一棵树”,它大致可以产生这样的效果。
从某种意义上说,这些模型似乎抓住了常识的一个很大方面。但是,让我们离真正理解自然和物理世界还很遥远的问题是,当你试图生成你或我在我们的工作中很容易想象的单词的罕见组合时,这些模型不能。
例如,如果你说,“把叉子放在盘子上”,这种情况经常发生。如果您要求模型生成这个,它很容易就可以。如果你说,“把盘子放在叉子上”,我们很容易想象这是什么样子。但如果你把它放到这些大模型里,你永远不会得到一个盘子放在叉子上。取而代之的是把叉子放在盘子上,因为模型正在学习再现它所训练的所有图像。它不能很好地概括它没见过的单词的组合。
一个相当著名的例子是宇航员骑马,这个模型可以轻松地做到。但如果你说一匹马骑着宇航员,它仍然会产生一个人骑着马。这些模型似乎捕捉到了它们训练的数据集中的大量相关性,但它们实际上并没有捕捉到世界的潜在因果机制。
另一个常用的例子是,如果你有非常复杂的文本描述,比如一个物体在另一个物体的右边,第三个物体在前面,第三或第四个物体在飞行。它只能满足一两个对象。这可能部分是因为训练数据,因为很少有非常复杂的标题,但这也可能表明这些模型不是非常结构化。
您可以想象,如果您得到非常复杂的自然语言提示,那么没有任何方法可以让模型准确地表示所有组件细节。
问:你最近提出了一种新的方法,使用多个模型来创建更复杂的图像,同时更好地理解生成艺术,这个框架在图像或文本领域之外是否有潜在的应用?
答:这些模型的一个局限性给了我们很大的启发,当你给这些模型非常复杂的场景描述时,它们实际上无法正确地生成与它们匹配的图像。
一种想法是,因为它是一个具有固定计算图的单一模型,这意味着你只能使用固定的计算量来生成图像,如果你得到一个非常复杂的提示,你就没有办法使用更多的计算能力来生成图像。
如果我给一个人类一个场景的描述,比如100行和一个只有一行的场景,人类艺术家可以花更多的时间在前者上,这些模型并没有这样的敏感度。我们建议,在给出非常复杂的提示时,你可以将许多不同的独立模型组合在一起,让每个单独的模型代表你想要描述的场景的一部分。
我们发现这使得我们的模型能够生成更复杂的场景,或者更准确地同时生成场景的不同方面。此外,这种方法可以广泛应用于各种不同的领域。虽然图像生成可能是目前最成功的应用程序,但生成模型实际上已经看到了各种领域中所有类型的应用程序。
你可以使用它们来生成不同的机器人行为,合成3D形状,更好地理解场景,或设计新材料。您可以组合多个所需因素,以生成特定应用程序所需的确切材料。
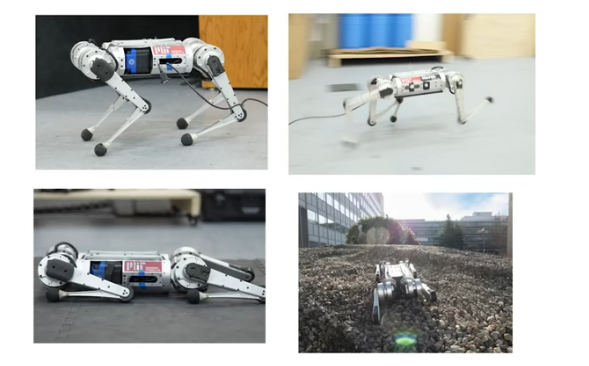
我们一直很感兴趣的一件事是机器人,就像你可以生成不同的图像一样,你也可以生成不同的机器人轨迹(路径和时间表),通过将不同的模型组合在一起,你可以用不同的技能组合生成轨迹。如果我有跳跃和避开障碍的自然语言规范,你也可以将这些模型组合在一起,然后生成既能跳跃又能避开障碍的机器人轨迹。
以类似的方式,如果我们想设计蛋白质,我们可以指定不同的功能或方面,类似于我们如何使用语言指定图像的内容——用类似于语言的描述,例如蛋白质的类型或功能,然后我们可以将它们组合在一起,生成新的蛋白质,这些蛋白质可能满足所有这些给定的功能。
我们还探索了在3D形状生成中使用扩散模型,在那里您可以使用这种方法来生成和设计3D资产。通常情况下,3D资产设计是一个非常复杂和费力的过程。通过将不同的模型组合在一起,我们可以更容易地生成形状,如“我想要一个有四条腿的3D形状,具有这种风格和高度”,这可能会自动化部分3D资产设计。
原文链接:https://techxplore.com/news/2022-10-ai-image-robots.html
