摘要
随着人工智能算法越来越多地参与到曾经是人类的专属领域的日常活动中,我们不可避免地需要考虑机器到底有多像我们。为了解决这个问题,我们求助于图灵测试,系统地测试当前人工智能模仿人类的能力。我们建立了一种方法,在图灵类测试中评估人类与机器的对比,并系统地评估所选领域、参数和变量的代表性集合。该实验涉及769名人类代理、24名最先进的人工智能代理、896名人类法官和8名人工智能法官,通过包括视觉和语言模式在内的6个任务的21570项图灵测试。令人惊讶的是,研究结果显示,目前的人工智能距离在复杂的视觉和语言挑战中模拟不同年龄、性别和教育水平的人类法官相差不远。相比之下,简单的人工智能法官在区分人类答案和机器答案方面优于人类法官。这里介绍的策划的大规模图灵测试数据集及其评估指标为评估代理是否是人类提供了有价值的见解,提出的在当前人工智能中对人类模仿能力进行基准测试的公式,为研究界将图灵测试扩展到其他研究领域和条件铺平了道路。所有的源代码和数据都可以通过这个网址(https://drive.google.com/drive/folders/1vKplQUud271et4MPcqs8VXosGl_atOhP)公开获取。
1. 简介
图灵测试,也被称为“模仿游戏”,由艾伦·图灵在1950年提出,作为一种评估机器表现出与人类没有区别的智能行为能力的方法(图1)。自图灵测试诞生以来,它是否能充分量化智力一直存在争议,本文的目的不是争论图灵测试作为一种一般智力的测量方法是赞成还是反对。相反,我们认为图灵测试是对当前人工智能模仿人类能力的定量评估。
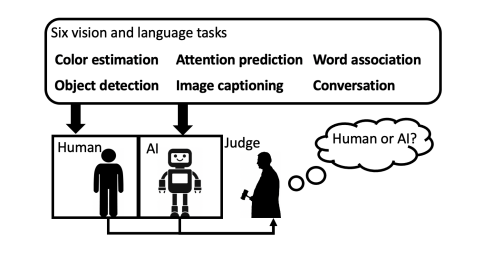
图1:图灵测试在六种视觉和语言任务中的示意图。图灵测试是由一名法官要求测试对象(人类或人工智能代理)完成一系列任务,每个人都被关在一个单独的房间里,所以不允许身体接触。如果法官不能通过从给定任务中收集的回答将AI和另一个人区分开来,那么AI就通过了图灵测试。图2是六个任务的概述。
随着强大的人工智能技术在现实世界中得到部署,对于非专业人士、法官、医生、政客和其他专家来说,确定与他们互动的代理是否为人类变得越来越重要。这是众多例子中的两个:无法区分人类和人工智能机器人可能导致网络安全漏洞,导致私人和受保护的数据丢失。此外,无法将真实新闻与人工智能生成的假新闻或深度造假区分开来,可能会对选举活动产生灾难性的影响。
目前的人工智能是否通过图灵测试的答案取决于大量的考虑因素,包括机器代理、人类代理、法官、具体任务、上下文条件等等。与不受限制对话中的图灵测试的原始版本不同,当前工作的目的不是详尽地研究这些参数和选项的所有可能组合。相反,我们的目标是:(1)建立一种评估人类模仿者的方法,(2)为人工智能社区提供一种系统协议,以量化一项任务是由人类还是机器执行的,(3)在任务和条件的子集上引入评估指标和分析工具,作为原理证明。具体来说,我们在图灵测试中对24个AI模型进行了基准测试,测试对象是计算机视觉和自然语言处理中的6个基本任务(图2):颜色估计、目标检测、注意力预测、图像配标题、单词关联和对话。
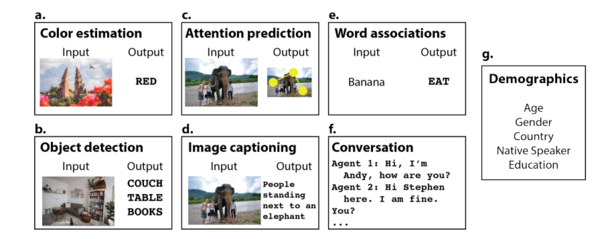
图2:6个任务的示意图。我们系统地评估了3个视觉任务,1个视觉-语言任务和2个语言任务。a.在颜色估计中,代理提供一个图像,并必须输出主颜色。b.在对象检测中,代理提供一个图像,必须提供三个对象。c.在注意预测中,向代理提供一个图像,输出是注意位置或眼球运动的序列。d.在图像字幕中,代理提供对图像的单句描述。e.在单词关联中,代理看到一个单词,必须生成一个与提示相关的单词。f.在对话中,代理产生24个交换。参见第3节了解每个任务的详细描述,并参见补充材料了解来自所有任务的人工和人工智能代理的更多刺激示例。用人类法官进行图灵测试的结果取决于法官的特点。作为初始特征,我们收集了该表中所示的基本人口统计信息。
这项工作的主要贡献是:
(1)、我们设计了一个系统的格式来进行图灵测试和评估AI模型的不同任务,涉及多种模式,这有助于社区将图灵测试扩展到更广泛的任务和基准未来AI模型。
(2)、我们引入数据集来评估当前在6个基本视觉和语言任务的图灵类测试中的人工智能。
(3)、我们进行了人类心理物理学实验,在24个最先进的视觉和语言AI模型的图灵测试中评估人类法官。
(4)、我们证明,简单的机器学习算法可以作为人工智能法官,在相同的任务中区分机器和人类代理。
2. 相关工作
2.1.图灵测试的70年历史
图灵测试最初是一种模仿游戏,在对话中,机器试图伪装成人类,由人类裁判判断它们是否在与人类互动。1991年,Loebner奖被颁发给被人类评委认为最像人类的程序,还有一个最具人情味的人奖。图灵测试引发了广泛的争议和讨论,争论的焦点是机器是否能成功模仿人类。一些著名的争论包括Searle的中文房间思维实验,Block的行为主义,Harnad的完全图灵测试,Watt的反向图灵测试,Damassino的提问图灵测试和Sejnowski的反向图灵测试。与这些论点不同的是,我们的目标是系统地、定量地提供方法、数据集,并通过在多种视觉和语言任务中通过图灵测试来模拟人类的当前人工智能的基准。
2.2.人工智能与人类在视觉任务上的对比
当前的计算机视觉模型可以执行广泛的任务,如物体识别和检测。模型通常通过与人类地面真相注释比较其输出进行评估,许多物体识别研究在非分布泛化、对抗性攻击和上下文变化方面对人工智能与人类进行了基准测试,几项研究还比较了人工智能模型在显著性预测和眼动预测方面与人类的注意力。然而,在特定任务中的高性能并不构成图灵测试,人工智能模型可以在一些特定的任务中显示出与人类相似的平均表现,甚至超越人类,但仍然与人类不同。图灵测试为模仿人类行为的AI模型提供了独特的评估,扩展和补充了当前的基准测试框架。
2.3.人工智能与人类在语言任务上的竞争
在自然语言处理中也可以进行类似的观察。在辨别任务中,如图像字幕或视觉问题回答,AI模型经常与人类的基本真相数据进行比较。人工评估分数是可靠的,但获取成本昂贵。为了缓解这些问题,提出了一些评价指标,如图像字幕中的BLEU、THUMB和METEOR。然而,这些度量关注的是n-gram重叠,对语义信息不敏感。Cui等人提出了一个作为人类法官的学习评论模型,在图像字幕任务中执行图灵测试。本文还介绍了评判模型,并将其与人类评判模型进行了比较。
生成式AI模型由于语言的固有歧义而难以评估。例如,通常招募人工评估人员来评估BERT或GPT2/3生成的文本的情感质量和语义相关性,这种评估仅限于文本生成的特定领域,人类法官的异质性还没有得到表征。在这里,我们基于来自不同人口统计数据的896名法官,对多个大型最先进的语言模型提供了广泛的图灵测试集。
对话是最初图灵测试的关键目标,对人工智能来说仍然是一个令人生畏的挑战。在对话中产生受限话题的早期尝试有很多,比如Colby的PARRY模拟偏执型精神分裂症患者,Weizenbaum的ELIZA模拟精神病学家。然而,这些模型都没有接近不受限制的图灵测试。大型语言模型的进步使得新闻和社交媒体产生了关于当前人工智能在对话中有感知能力的传闻。然而,很少有研究对人工智能在对话中模仿人类的能力进行严格和定量的评估,初步工作引入了不受限制的图灵测试,每次对话只进行一次交换。在这里,我们提供了参与多达24个交流对话的人工智能的广泛评估。
3.实验
我们介绍了6个任务(图2),我们如何创建数据集,以及我们如何设置图灵测试(图3)。关于每个任务、控件和Amazon Mechanical Turk (AMT)接口的示例快照的进一步详细信息在补充部分S2 - S7中提供。所有的AMT实验都是基于“master”工作者。我们还收集了参与者的人口统计信息作为元数据,包括他们的母语、年龄、性别、教育背景和他们的原籍国(图2g)。对于每个任务,我们都会收集人工和机器的答案。在每个图灵测试中,我们给出一个答案实例,并要求参与者指出答案是来自人类还是人工智能(例如,图3中的对象检测任务)。有一半的时间,显示的条目来自人类。另一半时间,会显示一个人工智能答案,从每个任务使用的不同计算模型中以相等的概率抽样。试验顺序是随机的,没有向参与者提供任何反馈,对每一项具体任务都进行了额外的对照试验,以确保遵守规定。
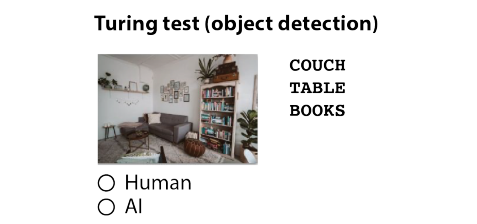
图3:物体检测任务的图灵测试示意图。法官将看到一张图像和三个标签,并必须决定这些标签是由人类还是人工智能制作的。
3.1. 颜色评估
数据集。我们从MS-COCO的验证集中收集了1000张图像样本的测试集,以确保计算模型在训练过程中没有看到这些图像。我们在颜色估计任务中使用AMT收集了785张图像的人类反应。AMT实验对象被问到“这张图片的主色调是什么?”,并必须从11种可能的颜色中进行选择。有关AMT接口的示例图像、说明和颜色列表,请参阅附录S2节。
对于AI模型,我们从谷歌的云视觉API、微软的Azure认知服务和公开的中位切颜色量化(MCCQ)算法收集了主导颜色的响应,总共收集了3140个图像响应对(785个来自人类,2355个来自AI模型,见表1)。
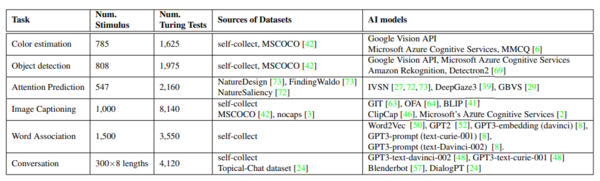
表1:为每个任务列出了源数据集、进行的图灵测试的数量、刺激的数量和用于收集响应的AI模型,任务描述见第3节。
图灵测试(人类判断)。研究人员向受试者展示了上面收集的图像-反应对,并问他们一个问题:“颜色描述是由人还是机器做出的?”。研究对象还被要求预测说话者的性别,一个辅助的True (50%)/False(50%)问题是关于图像中背景物体的存在作为对照,这个对照任务的平均准确率为91%,总共从人类法官那里收集了1625个回答。
图灵测试(AI判断)。对于每个图像-响应对,我们从ImageNet上预训练的ResNet18模型的最后一层嵌入中收集图像特征,并使用BERT收集颜色的文本特征,然后,这些特征被连接起来,并传入随机森林分类器,以预测人类和AI的标签,使用90%/10%的分割进行交叉验证。
3.2. 目标检测
数据集。我们从3.1节MS-COCO的1000张图像集合中收集了808张图像的响应。研究人员向受试者提出这样的问题:“你在这幅图中看到了什么?”,并被要求输入三个单字回答。我们引入了几个控制,确保回答都是英语单词,并且参与者不会在图像内部或图像之间重复相同的回答。有关AMT接口、指令和控制的示例图像,请参阅附录S3节。
我们从谷歌的云视觉API、微软的Azure认知服务、亚马逊的rekogniapi和Facebook的Detectron2收集了预测标签。对所有网络,收集预测得分最高的前三个预测标签。总共收集了4,040个图像响应对(808个来自人类,3,232个来自四个AI模型,见表1)。
图灵测试(人类判断)。使用3.1节中描述的相同协议和控件(图3,S18, S19, S29)对人类裁判进行图灵测试。总共从人类法官那里收集了1975个回答。
图灵测试(AI判断)。由于人类和AI模型的图像是相同的,我们仅使用文本特征让AI裁判将响应分类为人类或AI。我们将三个回答连接成一个句子,并使用BERT收集句子的文本特征。这些特征被传递到支持向量机分类器中,以90%/10%的交叉验证将响应分为人工和人工智能。
3.3. 注意力预测
数据集。在两个视觉搜索任务和一个自由观看任务中,我们使用了人类受试者的眼球运动(显性注意力)。我们评估了来自40名参与者的7000个扫描路径(表S2)。对于这三个数据集,我们使用改良版的IVSN、DeepGaze3和GBVS模型来生成眼动预测。
图灵测试(人类判断)。分别对自由观看任务(80名法官)和视觉搜索任务(100名法官)的眼球运动进行图灵测试。我们在AMT上向人类裁判展示无限重复的眼球运动动画剪辑,或最多15次注视的模型预测。每个法官都必须确定眼球运动是来自人类还是计算模型。作为对照,评委还被要求回答“你在播放的视频中看到了什么?”, 3个选项中只有一个正确答案。
图灵测试(AI判断)。我们使用支持向量机作为人工智能判断器进行图灵测试。每次试验中人类或计算模型的10次注视序列以注视坐标数组的形式输入,以训练支持向量机对人类与机器的眼球运动进行分类,使用10倍交叉验证训练支持向量机,计算模型在具有3个随机种子的褶皱验证集上的性能并取平均值。
3.4. 图像配标题
数据集。我们从nocaps数据集的验证集中随机抽样了域中、近域和域外类别的250张图像,从MSCOCO测试集中随机抽样了250张图像,创建了一个1000张图像的集合。我们从AMT参与者中收集了2290个人类字幕,每个字幕≥6个单词,每张图片≥2个字幕。我们在AMT接口中实现了额外的控件。例如,工人在观看图像≥4s之前不允许提交标题。
为了生成机器字幕,我们使用了:GIT、OFA、BLIP、ClipCap和Microsoft的Azure Cognitive Services(表S3)。对于开源模型,我们使用了COCO Captions数据集上经过微调的最大变体。我们收集了5000个机器字幕,每张图片有5个字幕。
图灵测试(人类判断)。我们收集了293名AMT参与者的反馈。每个参与者都看到了一对图片标题,并指出该标题是由人类还是人工智能生成的。为了确保参与者仔细阅读字幕,我们缩短了响应时间<3 s,我们删除了非英语母语者的回答。
图灵测试(AI判断)。我们在人机字幕数据集上训练了一个支持向量机(SVM)二分分类模型,我们从5个模型中随机抽取400个标题,得到2000个机器标题,并将它们与我们的2000个人工标题结合起来,我们使用OpenAI API为每个标题获取4096维嵌入(文本相似度-curie-001模型)作为输入特征,用10倍交叉验证和3个随机种子训练支持向量机。
3.5. 单词联想
数据集。我们选择了150个独特的提示词(50个名词,50个动词和50个形容词),跨越了广泛的出现频率。对每一个提示词的联想是从人类实验对象那里收集来的。,以及来自以下语言模型:Word2vec, GPT2, GPT3-embedding(基于davinci嵌入),GPT3-curie-prompt(基于“curie”提示补全)和GPT3-davinci-prompt(基于“davinci”提示补全)。对于人类的联想,我们遵循两个步骤:(1)自由联想,参与者用一个词来回答这个问题:“当你听到这个词(提示词)时,你想到的第一个词是什么?”;(2)基于提示的联想,参与者用一个单词完成提示。用于人工提示完成的提示与用于GPT3-curie-prompt和GPT3 - dacci -prompt的提示相同。所有参与者都是生活在美国的英语母语人士。
图灵测试(人类判断)。在人类判断图灵测试中,我们从50个使用AMT的英语母语者中收集了数据。在每次中,都会出现一个提示词和相应的猜测词(联想),法官必须选择联想是由人类还是由人工智能模型做出的。
图灵测试(AI判断)。我们用10倍交叉验证训练线性支持向量机分类器,以区分人为关联和机器关联。我们使用线索和猜测词嵌入之间的距离,基于(1)Word2Vec, (2) GPT2,或(3)GPT3 (davinci)。
3.6. 对话
数据集。我们收集了300段对话:(1)两个人,(2)一个人和一个人工智能模型,(3)两个人工智能模型。对于包括人类在内的对话,我们招募了150名英语流利的参与者在一个聊天平台上进行对话,参与者不知道他们是在和另一个人说话,还是在和一个人工智能聊天机器人说话。我们收集了包含24次交流的对话。对于人与人之间的对话,我们从topic - chat数据集中添加了40个对话,这些对话是根据最少24次交流的长度选择的。
对于AI聊天机器人,我们使用了三种最先进的语言模型:Blenderbot3 (175B模型)、GPT3文本- davci -002和GPT3文本- cure -001。
图灵测试(人类判断)。我们将每段对话分成8个不同的长度,包括最初的3、6、9、12、15、18、21和24次交流。实验中有208名人类评委(AMT: 200人,实验室:8人)。参与者面对20个随机采样的不同长度的分组对话,并必须对每两个说话者的说话者是人还是机器以及性别做出回应。作为对照,说话者还必须从五个话题列表中选择对话的一般话题,我们只考虑对20个主题中至少15个主题进行了正确分类的法官,并删除了分类错误的审判。
图灵测试(AI判断)。我们评估了简单的AI模型是否能够识别出一个句子是由模型还是由人生成的,我们只考察了单句。因此,这些结果仅为AI法官提供了一个初步的原则证明下限。我们构建了四个语料库,一个包含所有由人类编写的句子(人类语料库),另一个包含由Blenderbot、GPT3text - davci -002和GPT3text - currie -001 (AI语料库)生成的句子。我们使用BERT嵌入对每个句子进行标记化,并将标记化的句子输入经过训练的线性支持向量机,通过10倍交叉验证对人类与人工智能进行分类。
4. 结果
我们在图4中总结了所有图灵测试的结果,通过所有AI模型和所有人类判断人口统计数据的平均值。在补充材料中,我们展示了由人工智能模型分离的结果,也为不同的人类判断人口统计数据。对于每个任务,图4显示了当ground truth为人类(第一行)或AI(第二行)时,试验被分类为人类(第一列)或AI(第二列)的次数比例,每一行的条目加起来为100%。就模仿人类的能力而言,当比较特定任务的不同AI模型时,接近50%的百分比表示更好的模型。相比之下,在比较不同的法官时(例如,人类法官与人工智能法官,或不同年龄或教育背景的人类法官),整体准确性越高表示法官越好。
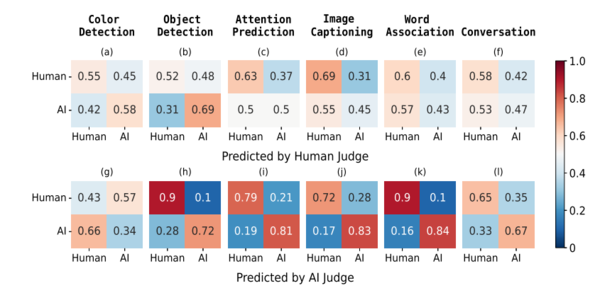
图4:每个任务的图灵测试结果。人工裁判(上行)和机器裁判(下行)的图灵测试结果。对于每个任务,混淆矩阵报告了当基础事实是人类(第一行)和AI(第二行)时,试验被标记为“人类”(第一列)或“AI”(第二列)的次数百分比。每一行的百分比总和为100。这里所有的AI模型都是平均的。参见补充材料,了解来自每个AI模型和不同人类判断人口统计群体的结果。
4.1. 颜色估计
人类在58%的时间内将AI答案区分为AI,在55%的时间内将人类答案区分为人类(图4a)。我们根据每个AI模型分析了性能,谷歌API的表现(57%)略好于Azure API(60%)和MCCQ(65%)。尽管颜色MCCQ是一个简单的度量,但它仍然在35%的情况下欺骗了人类。不同年龄群体的人类法官在表现上没有显著差异,受教育程度,或性别。相比之下,AI裁判43%的时间将人类答案归类为人类,34%的时间将AI答案归类为A。
4.2. 目标检测
人类在69%的时间内将AI答案视为AI,而在52%的时间内将人类答案视为人类。我们根据每个AI模型分解了性能。在所有的AI模型中,Detectron表现最好(49%),与第二好的谷歌API(65%)有很大差距。这种现代计算机视觉目标检测算法不仅在标准评价指标(如mAP)上取得了优异的绝对分数,而且通过识别场景中最显著的前3个目标,其响应模式也非常接近人类。具体来说,我们使用了在ImageNet和MS-COCO上训练的MaskRCNN变体。
不同年龄群体的人类法官在表现上没有显著差异,性别或教育程度。所有的数字与上述所有人类裁判的平均表现相差不超过5%。
接下来,我们分析了AI裁判在该任务中的分类性能。与人类相比,AI裁判能够更好地区分AI和人类说话者。AI法官的总体分类准确率为81%(而人类法官的分类准确率为56.5%)。具体来说,AI裁判可以将AI反应识别为AI,准确率为90%,将人类反应识别为人类,准确率为72%。最容易分类的是来自Azure API的响应,AI裁判的准确率为94%,而最难分类的是Detectron和Amazon的Rekognition API,准确率分别为67%。
4.3. 注意力预测
人类在63%的时间内将人类的眼球运动区分为人类,在50%的时间内将人工智能产生的眼球运动区分为人工智能(图4c)。我们分别检查了每个AI模型的图灵测试性能。IVSN分别优于GBVS和DeepGaze34%和17%。我们评估了眼动过程中代理的目标是否会影响后续的图灵测试。与视觉搜索任务相比,人类法官在自由观看时的表现要好2.5%。自由观看主要是由纯自底向上的显著性驱动的,在没有目标定向调制的情况下可能更容易识别扫描路径模式。与这一想法一致的是,在自由观看过程中,与视觉搜索相比,GBVS生成了更多类似人类的扫描路径,而DeepGaze3在自由观看任务中的表现比视觉搜索差得多。IVSN在这两项任务中的表现相似,这强调了在人类注意的计算模型中结合自下而上和自上而下注意机制的重要性。
不同年龄的法官),以及男性或女性法官,在图灵测试中表现同样出色。具有研究生学历的法官表现略差于本科及以下学历的法官。
作为对AI裁判的初始评估,我们训练了一个SVM分类器,它完全基于眼睛注视的序列,而不考虑图像特征(图4h)。有趣的是,一个简单的支持向量机人工智能法官的表现比人类法官好20%。在不同模型和不同任务中,AI法官的表现都优于人工法官。然而,在解释这个结果时应该谨慎,因为人工智能法官接受过明确的扫描路径分类训练,而人类法官通常没有这样的事先训练。
4.4. 图像配标题
人类在69%的时间内将人类字幕识别为人类字幕,而在45%的时间内将人工智能字幕识别为人工智能字幕。AI模型之间存在相当大的差异,标记AI的AI字幕比例从37% (BLIP)到59% (ClipCap)不等。CIDEr是评估人工智能生成字幕质量的标准评价指标。在CIDEr评分方面,OFA的表现优于GIT和ClipCap,但在模仿人类字幕方面并不好,这突显了传统性能指标与图灵测试之间的差异。相比于近域nocap和域外nocap,人类裁判将域内nocap图像标记为人类的次数略多一些。不同年龄的法官、男女法官、不同文化程度的法官之间无差异。
作为构建AI判断器的原理证明,我们使用OpenAI Embeddings API(文本相似度-curie-001模型)提取特征,并训练线性支持向量机来区分人类和机器的响应。令人惊讶的是,即使这个分类器没有使用图像特征,人工智能法官仍然可以区分人类和机器的答案,准确率高达77.5%,远远高于人类法官的表现(图4j)。在所有不同的AI模型中观察到类似的结果。
4.5. 单词关联
人类在60%的时间内将人类单词联想标记为人类,在43%的时间内将AI单词联想标记为AI(图4e),不同AI模型的结果相似。令人惊讶的是,Word2Vec模型产生的词联想更难与人类的词联想区分开来。不同年龄、性别(和教育水平的人类法官之间没有显著差异。
我们使用GPT-series模型和Word2Vec的各种单词嵌入作为特征,训练3个SVM判断器(基于每个AI模型嵌入的独立SVM分类器)。与人类法官相比,人工智能法官可以很容易地区分人类和机器的单词关联(图4k)。所有AI裁判的表现都优于人类裁判。如预期的那样,在训练基于相同模型的嵌入的SVM分类器时,该模型的分类性能基本完美,而该模型的嵌入也用于生成猜测词。经过Word2Vec嵌入训练的AI裁判确实完美地预测了作为AI的Word2Vec嵌入产生的所有猜测词。虽然这些案例可以很好地作为一个健全的检查,但它们不应该被考虑到对人工智能法官的总体评估中。因此,我们训练了3种不同的支持向量机来避免这种偏差。
4.6. 对话
人类裁判在58%的时间内将对话中的人类参与者区分为人类,在47%的时间内将AI代理区分为AI(图4f)。与在受限对话主题中通过图灵测试的AI模型不同,有趣的是,在基本不受限制的对话中,总体准确度为53.5%。
我们分别考虑了人-人、人- AI和AI-AI对话,令人惊讶的是,人与人之间的对话只有61%的时间被归为人类,而AI-AI的对话有56%的时间被归为人类。Blenderbot在64%的时间里被归类为人类,这表明人工智能可以被视为比人类本身更像人类。在与人工智能的对话中,人类参与者有61%的时间被标记为人类,人工智能有55%的时间被分类为人工智能。人类与人工智能对话的总体分类准确率高于人工智能与人工智能对话(58% vs 41%),这表明人工智能在与人类交谈时比在彼此之间更经常地暴露真实自我,这一观察结果与人类法官在进行比较时比绝对评价时更准确的概念是一致的。
当比较不同的AI模型时,Blenderbot最常被标记为人类,在AI-AI对话中66%的时间被标记为人类,在人-AI对话中50%的时间被标记为人类。图灵测试的结果取决于对话长度,人工智能模型不太擅长在较长时间的对话中冒充人类。在所有的AI模型中,GPT3-curie的下降幅度最大,而Blenderbot保持了相对较高的性能。这些观察结果强调,当在对话中模仿人类时,模型的大小、对对话数据的特定训练以及对过去对话历史的外部记忆建模是重要因素。
在AI-AI对话中,年轻的比年长的在辨别人类AI方面表现得更好,令人惊讶的是,男性评委的表现略好于女性评委(60%比57.5%),特别是在AI-AI对话中(46%比39%)。有趣的是,教育程度与人类法官的分类准确率呈轻微负相关(初中、大学和研究生学历分别为54%、53%和51%),尤其是在与人工智能的对话中。然而,在AI-AI对话中,这一趋势发生了逆转,研究生法官比初高中法官表现更好(53%对41%)。
我们训练了一个简单的支持向量机判断器来区分对话中的句子是来自人类还是人工智能。与其他实验一致的是,人工智能法官以很大的优势击败了人类法官(66%对53.5%,图4 l)。该AI法官在分类Blenderbot句子方面表现特别好,与人类法官形成鲜明对比,后者比GPT模型更容易被Blenderbot愚弄。在图灵测试中,人类裁判可能会关注高级对话理解,而不是单个句子的统计数据。
5. 讨论
作为一种评估一般智力的方法,图灵测试已经被广泛讨论和争论。相反,我们把图灵测试作为衡量算法是否能模仿人类的指标。表S1以高度简化的二进制格式总结了观察结果,这个表格是一个总体平均值,读者可以参考所有的实际数字,以更准确地描述调查结果。值得注意的是,当前工作中所测试的算法在由人类裁判评估时,似乎非常接近于通过图灵测试。鉴于模仿人类对某些目的可能非常有益,但也可能很容易被转化为潜在的邪恶应用,这些观察结果要求对能够模仿人工智能的机器进行更广泛和严格的审查。
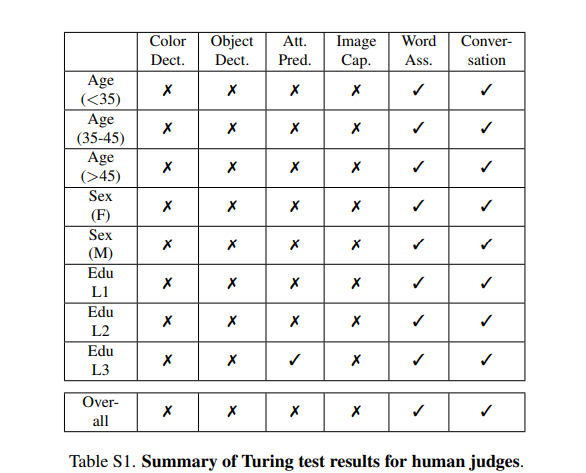
表S1:图灵测试结果摘要
降低来自人类模仿者的风险的一个步骤是构建人工智能法官。我们的结果表明,即使是像这里介绍的这样简单的人工智能法官在检测机器答案方面也比人类法官做得更好。目前人工智能法官的结果不应被过度解读,因为人工智能法官经过明确的训练,可以将人类和人工智能的反应进行分类,而人类法官则没有。这一点提出了一种可能性,即人类可能在未来被训练得更好地识别机器的答案。
一种算法模仿人类的能力并不总是与准确性等传统性能指标相关,这意味着图灵测试为AI模型提供了对现有基准测试框架的补充评估,图灵测试中模型之间的比较也为开发未来能更好地与人类保持一致的AI模型提供了有益的见解。
这里介绍的数据集和评估相当广泛(21570个图灵测试试验,904个人类和人工智能法官,6个视觉和语言任务,几个人口统计群体),但它们只是需要做的表面。本质上有无限种可能的图灵测试。图灵测试的结果取决于任务、算法、问题的表述方式、人类裁判的特征和许多其他变量。
这项工作提供了一个全面的,但肯定远远不是详尽的,评估最先进的人工智能模型在人类仿真方面,这些努力为研究团体将图灵测试扩展到其他研究领域铺平了道路,以建立更好的模仿者和更好的模仿者检测器。如果更多的人工智能模型能够“融入”人类,并接管原本是衡量人类的独特标准的任务,这将促使我们思考是什么使我们成为人类,以及我们是否在精神上、道德上和法律上为人工智能技术带来的快速革命做好了准备。
原文链接:https://arxiv.org/abs/2211.13087
---煤油灯科技victorlamp.com翻译整理---
