十五年前,研究人员就展示了GPU用来大幅加速关键AI的操作,震惊了科技界。十五年后,这种认识继续吸引着企业的想象力。IDC报告称,就基础设施而言,GPU加速计算和类似HPC的纵向扩展是寻求构建AI基础设施的技术领导者和架构师的首要考虑因素。
但是,对于所有已经成功地将AI应用于现实问题的组织来说,大多数还正处于努力超越实验或试点阶段。IDC 2021年的研究发现,不到1/3的受访者已经将他们的AI项目投入生产,其中只有三分之一达到了“成熟的生产阶段”。
该研究列举的一些障碍因素包括处理和准备数据遇到的问题,以及加强基础设施以支持企业级规模AI。IDC表示,企业需要投资于“专门建造的、规模合适的基础设施”。
实施AI项目时的问题
哪些组织在AI上的哪里出问题了呢?一个因素可能是,与其他计算引擎相比,技术领导者和AI专家未能全面审视更广泛的AI管道,同时过于关注GPU,特别是备受尊敬的CPU。
因为最终,这不是支持CPU对GPU对ASICs的问题。相反,它是关乎找到构建AI管道的最佳方式,可以从想法和数据、模型构建到部署和推理。这意味着,了解不同处理器架构各自的优势,可以在适当的时间应用适当的计算引擎。
正如英特尔数据中心AI战略和执行高级总监Shardul Brahmbhatt解释的那样,“CPU一直用于云中的微服务和传统计算实例。GPU已被用于并行计算,如媒体流、游戏和AI工作负载。”
因此,随着超大规模和其他云玩家将注意力转向AI,很明显他们正在利用这些相同的优势完成不同的任务。
例如,GPU的并行计算能力使它们非常适合训练AI算法。与此同时,CPU在低批量、低延迟实时推理方面具有优势,并使用这些算法来分析实时数据并提供结果和预测。但有些地方你想做更多的批量推断。批量推断也是通过GPU或ASICs完成的。
重新审视AI管道
但是AI管道已经超出了训练和推理。在管道的左侧,必须对数据进行预处理,并开发算法。多面手CPU在这里扮演着重要的角色。
事实上,根据英特尔的数据,GPU在整个AI管道的总处理器活动中占相对较小的比例,CPU驱动的“数据阶段”工作负载占整体的2/3。当然,CPU架构还有其他优势,包括可编程性。
“因为CPU已经被广泛使用,已经有一个现成的开发者和应用生态系统,加上为通用计算提供易用性和可编程性的工具,”他说。
其次,CPU提供了对更大内存空间的更快访问。第三件事是,相对于更多并行计算的GPU,它更多的是非结构化计算。出于这些原因,CPU作为数据移动器运行,为GPU提供数据,从而帮助推荐系统模型以及图形神经网络等工作负载的发展。
CPU和GPU的角色
那么,在规划AI开发管道时,我们应该如何分别看待CPU和GPU的角色,无论是在本地、在云中还是跨越两者?
GPU彻底改变了AI开发,因为它们通过从CPU卸载操作来提供加速AI开发的方法。但这并不意味着这是给定工作最明智的选择。
英特尔平台架构师Sharath Raghava认为,“AI应用已经实现了矢量化计算。向量计算是并行的。为了高效地运行AI工作负载,可以考虑向量计算的规模、卸载延迟、并行性和许多其他因素,利用CPU和GPU的能力。对于一个较小的任务,卸载的成本将会过高,在GPU或加速器上运行它可能没有意义。”
CPU也可以从与其他系统组件的更紧密集成中受益,这允许它们更快地完成AI工作。从AI部署中获得最大价值不仅仅涉及运行模型本身——所寻求的洞察力取决于有效的预处理、推理和后处理操作。预处理要求在输入数据以生成推理之前,准备好数据以匹配训练模型的输入预期。然后在后处理阶段从推理结果中提取有用的信息。
例如,如果我们考虑一个数据中心入侵检测系统(IDS ),根据模型的输出及时采取行动以保护和防止网络攻击造成的任何损害是非常重要的。通常,预处理和后处理步骤在主机系统CPU上执行时会更有效,因为它们与架构生态系统的其余部分集成得更紧密。
巧用CPU和GPU
那么,这是否意味着完全放弃GPU加速的好处呢?不一定。英特尔多年来一直在其Xeon Scalable CPUs中构建AI加速。该范围已经包括深度学习Boost,用于深度学习模型的高性能推理,而英特尔的高级矢量扩展512 (AVX 512)和矢量神经网络扩展(VNNI)可加快INT8推理性能。但DL Boost也使用大脑浮点格式(brain floating point format,BF16)来提高不需要高精度训练的工作负载的性能。
英特尔即将推出的Xeon可扩展第四代CPU将增加高级矩阵乘法,即AMX。根据英特尔的计算,这将比早期处理器中实施的AVX-512 VNNI x86扩展进一步提高8倍,并允许第四代英特尔Xeon Scalable处理器“像GPU一样处理训练工作负载和DL算法”。但这些加速器也可以应用于AI和非AI工作负载的通用CPU计算。
这并不意味着英特尔期望AI管道从头到尾都是x86。当完全卸载将受益于并行化的培训工作负载更有意义时,英特尔提供了其Habana Gaudi AI培训处理器。基准测试表明,后者支持Amazon EC2 DL1实例,与同样托管在云中的基于Nvidia GPU的可比训练实例相比,可以提供高达40%的性价比。
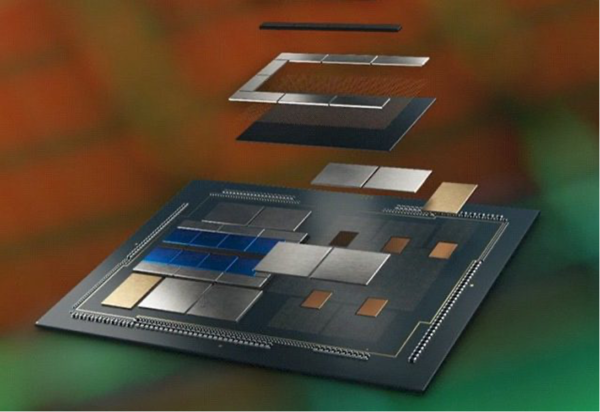
同时,英特尔的数据中心GPU Flex系列面向受益于并行化的工作负载和操作,如AI推理,不同的实现针对“更轻”和更复杂的AI模型。另一个代号为“Ponte Vecchio”的英特尔数据中心GPU——Max系列,即将为Aurora超级计算机提供动力。
让生态系统推动应用
英特尔的芯片可能会支撑整个AI管道,同时最大限度地减少不同计算引擎之间不必要的数据卸载需求。该公司的处理器——无论是GPU还是CPU——也支持基于开源工具和框架的通用软件模型,并通过其oneAPI开发环境进行了优化。
Brahmbhatt认为,英特尔具有在构建基于社区和开源的x86软件生态系统方面的传统优势。英特尔的理念是‘让生态系统推动采用’,目前正在使用一个通用的软件堆栈,让开发人员基本上不必担心CPU和GPU之间的底层知识产权差异。
在企业中,通用软件堆栈与专注于为正确的任务使用正确的计算引擎的结合更加重要。企业正在依靠AI来帮助他们解决一些最紧迫的问题,无论这些问题是驻留在云中还是本地。但是,混合工作负载需要功能齐全的软件,以及系统堆栈的维护和管理,才能运行加速器内核中不包含的代码。
---煤油灯科技victorlamp.com翻译整理---
