基于小芯片(chiplet)的设计有望降低开发成本,加快上市时间,但一直是大型芯片供应商的专利。现在,该行业正在建立一个生态系统,以实现结合使用不同工艺节点的第三方小芯片的设计。同时,RISC-V通过其开源模型实现了更大的CPU创新。这些趋势为RISC-V小芯片供应商创造了机会。
后摩尔时代
一刀切的处理器架构时代已经一去不复返,因为摩尔定律(Moore’s Law)的放缓迫使工程师针对特定领域的工作负载进行优化设计。虽然这种趋势在AI处理器中最为明显,但由于不同的功率限制和性能要求,设计人员也被迫为其他应用优化处理器。这些细分市场包括数据中心基础设施在计算要求上有很大差异,例如,基于微服务的软件和科学计算。在热预算紧张情况下,包括5G无线接入网络在内的服务提供商基础设施,会优先考虑高效、安全的数据移动。汽车和自动驾驶汽车应用同样受到功耗和空间以及传感器数据实时处理的限制。
随着前沿SoC设计成本的上升,除了最大的供应商之外,开发工作负载优化的单片处理器的成本变得非常高昂。为了抵消不断上升的开发成本并提高制造产量,一些供应商开始使用几个小芯片,而不是一个单片芯片。AMD在台式电脑和服务器处理器中都采用了小芯片;英特尔和Marvell也发布了基于小芯片的产品。然而,几乎每一个这样的设计都使用了专门设计的小芯片。这种情况限制了拥有设计完整处理器资源的公司对小芯片的采用。
Ventana Micro Systems致力于通过创建第三方生态系统,使基于小芯片的设计变得大众化。它正在开发一种采用领先工艺技术的RISC-V计算小芯片,客户可以用它来创建定制处理器。通过提供高性能计算芯片,客户可以专注于增加特定工作负载的价值,同时降低工程成本并缩短上市时间。客户示例可能包括数据处理单元(dpu)、存储处理器和AI加速器。为了进一步使处理器设计大众化,Ventana选择了开放和可扩展的RISC-V指令集,消除了许可障碍,促进了开放创新。
小芯片驱动处理器发展
在过去的几年里,包括AMD、Intel和Marvell在内,基于小芯片的设计大厂中迅速得到采用。AMD使用小芯片方法推出了三代PC和服务器处理器,这种方法采用了低成本的有机基板。通过在每个计算芯片(CCD)部署8个内核,该方法可以构建8到64内核的处理器(在当前一代中)。这列的CCD包括CPU、高速缓存和一个结构接口,而I/O小芯片提供所有外部接口,如PCI Express、DDR4通道、插座级互连和其他I/O。这允许AMD在其CCD中使用领先技术(第三代Zen 3处理器的CCD采用了7纳米工艺),而I/O小芯片则使用落后的14纳米技术。
英特尔首先在FPGAs中采用了小芯片,现正在将其扩展到服务器处理器、PC处理器和GPU。该公司下一代至强处理器代号为Sapphire Rapids,使用小芯片超越了单片设计的网线限制。与AMD相比,英特尔使用更粗略的划分,将CPU、高速缓存和I/O结合在一个小芯片上,然后使用其中四个小芯片在封装层进行扩展。它使用专有的硅桥技术(EMIB)来连接芯片,相对于有机基板来说,增加了成本和性能。在Ponte Vecchio高性能计算GPU中,该公司采用了EMIB和3D堆叠技术,将一个巨大的28逻辑芯片集成在一个封装中。
摩尔定律的放缓正在推动越来越多的基于小芯片的设计的采用,英特尔2023年的Meteor Lake PC处理器就是证明。新的工艺节点继续增加晶体管密度,但增加的晶片成本导致每个晶体管的成本减少很少或没有减少。每个新节点产生的速度提升和功耗降低都较小。小芯片为单片设计提供了一种替代方案,允许更多的晶体管数量,同时消除了对所有功能使用相同工艺的要求。芯片设计者不再被迫重新设计I/O模块或其他不能从最新节点中受益的功能。基于小芯片设计还可以简化验证,验证是复杂单片设计进度中的主要风险来源。
然而,使基于小芯片的设计大众化需要标准化管芯到管芯(die-to-die,D2D)互连,使得多个客户可以集成第三方小芯片。否则,如果每个小芯片仍然是客户特定的,就降低了分解设计的经济优势。关于D2D接口标准的最早工作来自网络世界,但串行(serdes)接口增加了AXI、CHI或TileLink等本地并行互连的设计复杂性、延迟和功耗。英特尔为其EMIB开发了一个并行接口,后来在开源许可下,在GitHub上发布了高级接口总线(AIB)规范和RTL。然而,AIB 1.0不支持低成本的有机基板。
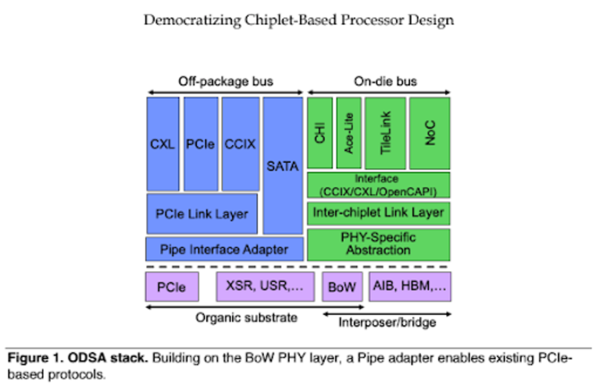
作为2019年开放计算项目的子项目,开放域特定架构(ODSA)工作组开发了一种适用于有机基板和硅插入器/桥的并行D2D接口。与AIB一样,ODSA的束线(Bunch of Wires,BoW) PHY的前向时钟指定单端DDR数据信号,最大限度地降低了复杂性、功耗和延迟。如图1所示,BoW可以作为片内总线和封装外接口的PHY层。然而,一致的D2D连接也需要链路层兼容性。
除了BoW接口,ODSA还有一个工作组开发BoW测试要求、链路层、概念验证原型、小芯片物理描述格式和小芯片业务工作流程。通过创建界面、参考设计和工作流程,ODSA正在为开放的小芯片市场奠定基础,这将使芯片供应商能够从多家供应商处采购可互操作的小芯片。
从通用到特定领域
尽管x86服务器处理器曾经主导了数据中心芯片的出货量,但这种分化的趋势正在推动芯片的更大多样性。dpu是一个新类别,主要用于智能网卡以及安全和存储设备,从它们的主机上卸载网络处理任务。存储处理器可以取代全闪存阵列中的x86处理器,从而终止网络流量并为NVMe固态硬盘提供扇出。
AI爆炸创造了多种芯片类型,包括推理加速器和可以作为独立处理器运行的训练芯片。除了这些专门的设计,云数据中心运营商正在开发自己的服务器处理器。他们看到了对小芯片生态系统的需求,以加快上市时间,降低大型芯片的成本,并减少对前沿制造的依赖。阿里巴巴(Alibaba)、脸书(Facebook)、谷歌(Google)和微软(Microsoft)通过ODSA终端用户工作组共同传达这一观点。
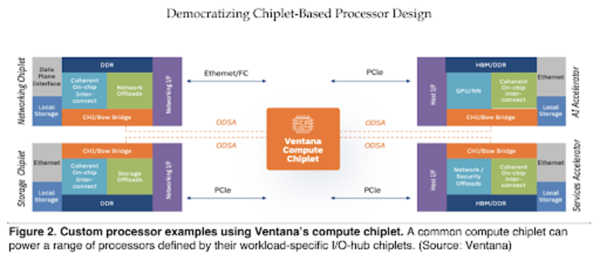
图2显示了客户可以使用小芯片方法构建处理器的示例设计,全部使用通用计算小芯片。I/O-hub小芯片仅实现目标应用所需的I/O、DRAM接口和硬件模块,与superset设计相比,也减少了总硅面积并提高了性能功耗比。需要大型硬件加速器(如神经网络引擎)的处理器可以使用多个小芯片,将这种密集的逻辑与I/o分离开来。这种芯片级分解实现了公共I/o的重用和每个小芯片的最佳工艺技术选择。
超大规模数据中心运营商消耗许多芯片,一些运营商也开发SOC,但他们缺乏开发高性能CPU内核的设计资源。一些运营商使用ASIC设计工艺来外包大部分开发,但单片ASIC仍然需要漫长的开发周期。成熟的小芯片市场可以减少开发时间、成本和风险。一些现有的芯片供应商可能会将开放的小芯片生态系统视为一种威胁,但许多初创公司正在接受这种新的商业模式。
分解RISC-V处理器
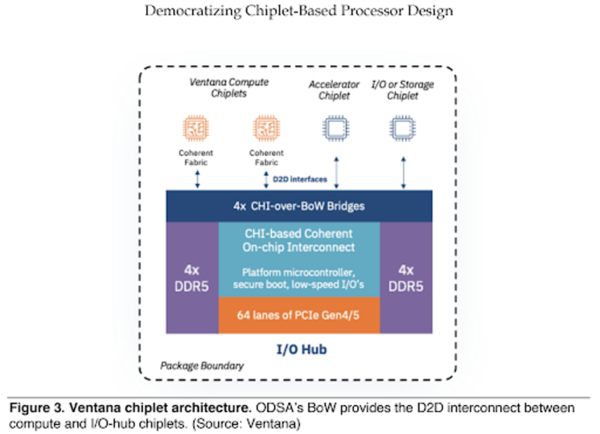
如图3所示,Ventana的处理器设计包括一个标准计算小芯片和一个客户定义的I/O-hub小芯片。该公司最初的计算小芯片是一个16核RISC-V设计,采用5纳米工艺技术。Ventana正在设计一种激进的无序CPU,预计它将提供与当代Arm和x86内核相媲美的单线程性能。这个计算小芯片有一个ODSA BoW接口,连接到I/O集线器(I/O-hub)。该公司正在开发链路层和事务层,它们将向I/O-hub模块提供Amba CHI(一致集线器接口)和AXI接口。
I/O集线器可以集成多个BoW接口来连接计算小芯片,使处理器能够拥有128个或更多内核。客户还可以将专有或第三方加速器小芯片连接到I/O集线器,这提供了跨计算和加速器小芯片的一致互连。I/O集线器还集成了系统I/O,如DRAM接口、PCIe端口或以太网端口,这是计算小芯片所缺乏的。因为I/O集线器通常省略了密集的逻辑和内存,所以它可以使用12/16纳米等成熟技术。
一旦Ventana证明其计算小芯片可提供已知良好的芯片性能,客户只需购买或开发一个I/O-hub小芯片即可完成处理器设计。小芯片方法降低了客户的流片成本,因为I/O集线器可以使用较旧的工艺。这还意味着客户无需许可和集成CPU IP,减少了非经常性开支和验证工作。许多I/O-hub功能可作为现成的IP使用,从而减少了设计时间。
结论
过去几年里,芯片已从一个时髦词变成了一项成熟的技术,芯片出货量达到每年数百万片。然而,由于缺乏成熟的生态系统,基于小芯片的设计只能由大型供应商提供。现在,一批供应商已采用新的基于小芯片的商业模式,一旦D2D接口标准化,这种新模式将获更广泛采用。客户需求为这种方法创造动力,最终目标是使用混合搭配的第三方小芯片快速设计芯片。
小芯片方法减少了开发定制处理器所需的成本和时间。通过使用现成的计算芯片,客户可以专注于开发针对目标应用的处理器IP,而不是复制一个公共模块。大多数I/O-hub功能都以IP块的形式提供,因此客户的任务主要是集成。尽管许多SoC缺乏能够证明同一节点中单片设计合理性的产量,使用计算小芯片允许客户使用领先的处理技术来实现该功能。
原文链接:https://riscv.org/blog/2022/06/democratizing-chiplet-based-processor-design-ventana-micro-systems/
---煤油灯科技victorlamp.com翻译整理---
