摘要
对于大量任务,量子计算显示了比经典计算指数级加速的潜力。在NISQ时代,可变分量子电路使量子计算的应用成为可能。为了降低量子计算机固有的噪声和量子比特大小限制,现有研究提高了变分量子算法(VQA)的精度和效率。 在本文中,我们探索了门级和脉冲级VQA的各种ansatz改进方法,并对它们进行了分类、评估和总结。
1.引言
量子计算 (QC) 是一种新的计算范式,具有超越经典计算机的指数加速的巨大潜力,可以以更高的效率和速度解决经典的棘手问题。 在许多领域,如模式识别和数据挖掘,都具有传统计算机无法比拟的优势。 近二十年来,量子硬件在物理实现技术上也取得突破,取得长足进步,为量子计算的应用提供了可能。
虽然量子计算已经取得了长足的进步,但我们应该意识到,目前仍处于嘈杂的中等尺度量子(Noisy Intermediate Scale Quantum, NISQ)阶段。目前,量子计算机通常只有数十到数百个量子比特。受硬件设备的限制,不可能建立通用的容错量子计算机。然而,变分量子算法(VQA)的出现使得量子计算的当前应用成为可能。 我们可以针对不同的问题构造不同的量子电路和损失函数。 常见的 VQA 有变分量子本征求解器(VQE)、动态量子模拟、量子逼近优化算法(QAOA)、量子机器学习(QML)等。
然而,VQA仍然面临许多困难。由于目前的VQA大多是基于经典模拟器模拟的量子环境,一旦应用到真实机器上,NISQ相位量子器件的巨大噪声(量子比特和量子门的错误率很高,在 到 之间)将显著影响算法的精度。同样,有限的量子位也限制了算法的深度,影响了算法的效率和精度。
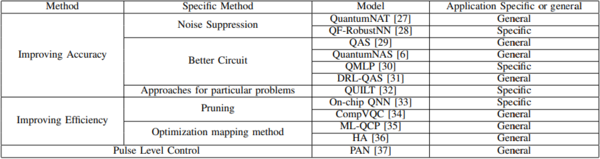
本文总结了现有的VQA改进方法,并分别在门级和脉冲级概述了不同的改进方向。我们首先来看门级的改进算法,如下表所示,VQA方法可以分为两类:提高准确率和提高效率。在此基础上,两个方向将采取不同的方法来实现目标。在简单介绍之后,本文将讨论它是否已经成功应用到真实的机器上,是否与设备相关,并对不同的方法进行总结。对于脉冲级,我们发现目前的综述涵盖的内容不多,但是一个很有前途的方向,我们将选择有代表性的方法进行简要介绍和评价。
表1:总结了现有技术的分类。定义了三个主要类别和五个子类别,阐述了所涉及的模型,并对每个模型进行了具体应用或不适用的讨论。
本文的其余部分组织如下。第二节概述了量子计算的基础知识。在同一节中,将简要讨论本文的动机。第三节将介绍改进VQA的不同方法。最后,第四节将总结和讨论一些前瞻性开放问题。
2.背景和动机
A. 量子基础
量子比特。 与只能表示 0 和 1 状态的传统比特不同,量子比特 (qubit) 可以表示两种基本状态 0 和 1 的各种线性组合: ,对于 , ,也称叠加。 由于这个独特的限制,一个 Nqubit 系统可以表示 个状态,而传统的位一次只能表示一个状态。 量子计算机的量子比特一般可以通过以下方式模拟: 1. 围绕氢原子运行的电子可能处于基态( )或激活态( ); 2. 电子的自旋可能向上( )或向下( ); 3. 光子偏振方向,可以是水平方向( ),也可以是垂直方向( );
量子门和量子电路。在经典计算中,所有的逻辑运算都可以用“与”、“或”和“非”三种运算来表示。在量子计算中,我们也需要一个类似的方案来完成相应的操作,这就是量子门。在量子计算的计算模型中,量子门是量子电路的基本组成部分,量子电路基于泡利运算。量子门和量子电路之间的关系类似于传统逻辑门和传统数字电路之间的关系。量子门通常用酉矩阵表示,一个操作于K个量子比特的门可以用2K x 2K的酉矩阵表示。量子门的操作可以通过将表示量子门的矩阵与表示量子比特状态的向量相乘来表示。常见的量子门分为单量子比特门和多量子比特门。单量子比特门包括Hadamard门、Pauli门等。多量子比特门有控制非门(CX gate)+、控制相位门(CZ gate)和交换门。
要使用量子计算机进行计算,我们需要建立一个量子电路来操纵量子比特的状态。量子电路由多个量子门组成。
变分量子算法(VQA)。变分量子算法是用经典优化器来训练量子电路。VQA的目标是找到一个可以拟合数据的模型,即确定一组最佳的参数,使模型尽可能接近给定的数据。VQA算法包括构造代价函数、构造ansatz和调整参数三个部分。常见的VQA包括变分量子特征求解器(VQE)、量子近似优化算法(QAOA)、量子机器学习(QML)等。VQA是一个很有前途的方向,但仍然面临一些困难。首先是量子电路的可训练性。在某些情况下,如贫瘠平台,由于退相干时间有限,优化器无法有效地训练大型电路。量子器件的噪声会从多方面影响VQA的准确性。物理噪声会减慢训练过程,使有噪声的全局最优不再对应于无噪声的全局最优,从而影响最终的最优损失值。
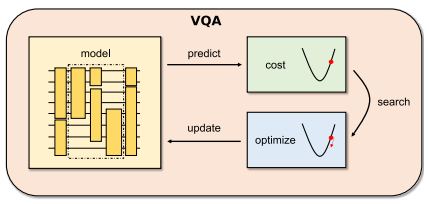
图1:变分量子算法示意图,模型基于量子计算机上的量子门设计,优化过程在经典计算机上进行,经典计算机在模型的可训练层优化和更新参数。
变分量子特征求解器(VQE)。VQE是一种利用经典优化器训练参数化量子电路求解矩阵特征值和特征向量的算法,是最早的变分量子算法,主要用于求解量子系统的基态和低激发态。由于这一性质,VQE被广泛用于解决量子化学中的问题。对于量子系统,哈密顿量H的维数随系统大小呈指数增长。其他算法通常需要数百万个量子比特,远远超出了当前量子计算机的能力。因此,VQE被提出用于NISQ机器。
量子机器学习。在解决特定任务时,量子算法比已知最快的经典计算机的算法具有量子优势。与需要 N 位的经典计算机算法不同,N 维数据在理论上只能由量子位中的 log(N) 位表示。因此,人们可以设计各种算法,通过量子计算机来实现加速,这就是量子机器学习。一些量子机器学习受到经典机器学习的启发,产生了一些有用的量子算法,如qPCA , qSVM,量子深度学习等。然而,由于现有量子计算机的规模相对较小,以及现有算法所需的规模和深度相对较深,距离真正超越经典机器学习还有很大距离。此外,嘈杂中等尺度量子(NISQ)时代机器的量子计算机噪声问题、贫瘠高原现象等,也制约了量子机器学习的性能。
NISQ机器上的噪音。首先,量子计算中的噪声,由于量子比特之间的不完美控制信号串扰,真实量子计算机之间的交互,以及来自外部环境的干扰,不可避免地会出现噪声,这极大地影响了量子机器学习的准确性,因此需要对量子机器进行频繁的表征和校准,以降低噪声的影响。同时,NISQ器件随着时间的推移会产生退相干误差,限制了电路的深度和宽度,使得实现复杂的量子电路不切实际。
Ansatz。Ansatz是电路的基本结构,是一组作用于特定子系统的门。Ansatz本质上是一些先验假设,这些假设是对适当训练回路的猜测。一方面,问题ansatz通常取决于具体问题,它可以结合问题的性质来求解问题;另一方面,一些ansatz架构是通用的和问题无关的,这意味着它们可以普遍用于量子硬件上的各种问题,我们将这种类型的ansatz称为硬件ansatz。
B.动机
近年来,量子计算的研究领域逐渐壮大。越来越多的研究表明,与经典计算机相比,vqa在大量任务中具有优异的加速潜力。研究表明,由66个功能量子位组成的二维可编程超导量子处理器Zuchongzhi可以在1.2小时内完成随机量子电路采样任务,这对于当今最强大的超级计算机来说需要8年时间。量子计算的优势在于,一个N维的数据(一个向量)理论上可以只用log(N)比特表示,而不是经典的N比特。一个量子比特可以处于0和1状态的叠加并相互相干,多个量子比特可以纠缠以表示更复杂的状态或执行更复杂的操作。
然而,当前的 VQA 仍然面临着巨大的挑战。 现有 VQA 的大部分优势都在经典模拟器模拟的量子环境中得到体现,而在 NISQ 机器中的真实量子环境中,其效率和准确性将显著下降。 这是由于 NISQ 机器的高噪声特性和现有量子计算机的量子比特规模小所致。 在量子计算机的规模和技术与量子霸权仍有差距的情况下,我们在门级优化方面可以做的是进一步优化量子电路,提高效率和精度,缩小差距。 此外,一些研究人员指出门级不是一个好的抽象层,并且已经提出了一些工作来从脉冲级控制中获益。
为了更好地理解现有电路优化方法的功能,便于用户为量子程序选择匹配的框架。在第三节中,我们回顾了现有的VQA 电路优化方法。我们可以找到各种优化方法以及它是否有用。在方法上,一些研究侧重于降低噪声的影响,一些研究使用剪枝来减少开销,还有一些研究从整体角度出发,使用传统机器学习的一些算法进行电路优化。与此同时,还将讨论它是否已经成功地应用于真正的机器,以及它是否依赖于设备。
3.不同类型的变分量子算法
为了更好地利用量子机器的量子加速特性,解决当前VQA面临的各种问题,需要对现有的VQA方法进行总结和分类。如下表所示,门级VQA方法可以分为两类:提高准确率和提高效率。在此基础上,两个方向将采取不同的方法来实现目标。之后,还将讨论脉冲电平控制。
A.提高准确度
我们要讨论的第一个方向是提高准确率,同时保证VQA的效率不会受到很大的影响甚至提升。 为了提高精度,通常有两种方法:噪声抑制和超级电路。 这两种方法试图从不同角度提高VQA的准确性。 同时,它们互不冲突,可以组合使用。
(1)噪声抑制:目前我们处于NISQ阶段,量子操作的错误率在 到 之间,远高于CPU/GPU的 ,因此有效的噪声抑制可以显著提高VQA的精度。
QuantumNAT 在该方法中提出了专用于 PQC 问题的噪声抑制框架,在训练和推理阶段都优化了 PQC 的鲁棒性。
在该方法中,作者提出对每个量子比特分别采集无噪声模拟和真实设备在一批输入样本上的测量结果,并计算其平均值和标准差。量子噪声对PQC测量的影响可以观察为无噪声测量的线性映射与缩放和移位因子。因此,可以通过归一化来减小无噪声和有噪声场景之间特征分布的差异。另一方面,根据量子硬件的实际噪声模型,在PQC中插入量子误差门,将噪声注入到训练过程中。最后,引入量测后量化,将测量结果量化为离散值,以达到去噪效果。
从结果可以看出,QuantumNAT 在五个量子设备上运行的八个任务上使用四种不同的 QNN 架构进行了实验。 QuantumNAT 在 26 项基准测试中始终达到最高准确率。 平均而言,归一化、噪声注入和量化分别将准确度提高了 10%、9% 和 3%。 然而,这种方法只对 PQC 任务有效,并且依赖于硬件。
QF-RobustNN 是一种通过训练来学习量子网络中的量子位错误的方法。 它提出了错误感知学习的通用训练框架,以减少噪声对神经网络的影响。
在基于IBM Qiskit的模拟器和IBM量子处理器上对QF-RobustNN的性能进行了评估。在高错误率条件下,QF-RobustNN的准确率远优于一般模型。另一方面,由于选择了合适的映射方法,QF-RobustNN具有更少的额外交换门,比其他方法更高效。
QF-RobustNN实现了对噪声的学习,从而可以对误差进行预测,有效降低了噪声对QNN的影响,提高了模型的精度。同时,由于采用了更合适的量子电路映射方式,可以有效减少额外门的数量,从而降低消耗,保证效率。该方法是一种有效的QNN方法,通过模拟器验证并在IBM量子处理器(即具有27个量子比特的ibmq-montreal后端)上进行测试。由于使用的机器数量较少,无法确定该方法是否硬件相关。
噪声抑制总结:从上述两种噪声感知方法中,我们可以发现该方法在提高模型精度方面有明显的效果,但并没有显著降低模型的效率,这是一种卓有成效的尝试。然而,大多数噪声感知方法需要学习噪声才能达到抑制的效果,而不同量子器件或同一器件在不同时间的噪声往往是不同的,因此这类方法通常是硬件依赖的。
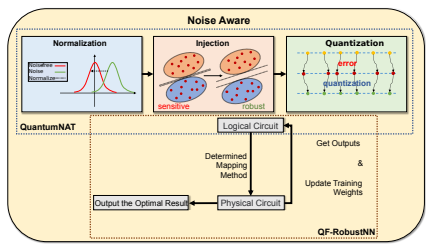
图2:量子计算上常用噪声感知技术实现的工作流程。 作品之间的差异和相关性已被标记。
(2)更好的电路:提高精度的另一种方法是找到一个足够好的电路,为目标机器上的给定任务提供相对更好的电路——量子比特映射,VQA 参数的可调节性使这一想法成为可能。一般来说,我们可以选择构建一个足够大的超级电路,以确保它包含我们需要的最优解,构建足够多的电路并找到最优解。或者,另一方面,我们也可以选择使用一些特殊的体系结构,或者应用一些经典计算机的方法来解决这个问题。
QAS 目前的VQA面临两个问题:1.当量子比特数和电路深度增加时,由于表达性和可训练性之间的平衡,vqa的性能会显着下降; 2. 较深的电路深度意味着经典优化器接收到的梯度信息充满噪声,有效信息呈指数级消失,可能导致发散优化或贫瘠高原。 QAS 通过将噪声抑制和可训练性增强统一为一个学习问题来解决这个问题。
QAS 在机器学习和 VQE 任务上都优于传统的 VQA。 在对带有噪声的量子器件进行数据分类任务中,传统量子分类器的分类准确率仅为50%,而QAS输出的量子神经网络及相应参数可以达到100%的准确率。
QuantumNAS提出了噪声自适应量子电路,为目标机器上的给定任务提供了相对更好的电路-量子比特映射。对于参数化量子电路,可以使用多个不同结构的电路来实现相同的目标,并使用不同数量和位置的量子门。QuantumNAS可以为目标机找到最合适的量子电路结构和相应的量子比特映射。
该研究借鉴了经典深度学习中的神经网络搜索(NAS)的思想。首先,构造一个足够大的超级电路。该超电路包含多个模块,每个模块包含多层参数门,其参数通过迭代采样和更新子电路来完成。Subcircuit是它的子集。由于训练成本较高,在超电路的训练中只进行子电路的梯度计算并更新超电路的参数子集。在建立正确的超级电路之后,量子使用遗传算法来找到正确的子电路。最后,进一步去除冗余量子门以降低所选分支电路的噪声,并采用迭代剪枝方法进行剪枝。
但是,这种方法是硬件依赖的,因为从它的实验结果来看,间隔3天后的实验精度明显降低,这可能是IBM的纠错机造成的。
QMLP 本文提出了一种量子多层感知器(QMLP)架构,增强了QNN电路的容错性,提供了丰富的非线性,并提出使用带有参数化双量子比特纠缠门的电路。该方法的特点体现在该方法提供的容错编码方法可以生成更准确的低层特征,改进了原有RUU层设计,提供可调的非线性度,便于构建深度QNN,以及使用参数化双量子比特门构建的ansatz。
在MNIST数据集上,QMLP在十分类任务中的准确率达到75%,高于QuantumFlow和QuantumNAS(69%和67%)。在QNN设计开销方面,QMLP门数和参数数分别减少了2倍和3倍。然而,随着电路变得更加复杂,当涉及噪声时,性能的提升会被门错误的副作用所抵消,可见该方法具有一定的局限性。在实际设计QMLP模型时,需要考虑模型深度和噪声容限之间的权衡。
DRL-QAS 本文提出了一种具有深度强化学习(DRL)能力的量子架构搜索框架。 在此框架中,DRL 智能体可以访问 PAUL-X、Y、Z 的预期值和一组预定义的量子操作,用于学习目标量子态,由主要参与者关键 (A2C) 和近端策略优化 (PPO) 优化 算法。 这种方法的优点是代理中没有编码任何量子物理知识,它可以与其他 DRL 架构或优化方法一起使用。
作者演示了成功生成多量子比特GHZ态量子门序列,证明了该方法确实是可行的,但该方法需要大量的资源,对于目前的NISQ相位,仍然无法应用到真实机器上。
较优电路总结:以上方法均归为较优电路,也可分为两个不同方向。该方法以QAS和QuantumNAS为例,通过它们的不同方法构造超电路并从中选择足够好的子电路。这种方法确实对提高准确率有一定作用。同时,这种方法通常也具有通用性。然而,由于构建超电路的工作量很大,这部分工作仍然需要在NISQ环境下交由经典计算机完成。然而,QMLP和DRL-QAS代表了另一个方向的尝试,将经典计算机上的一些方法应用于辅助电路的生成,以使模型更强。这种方法的问题还体现在电路构造工作量过大,目前只能应用于模拟器的环境。
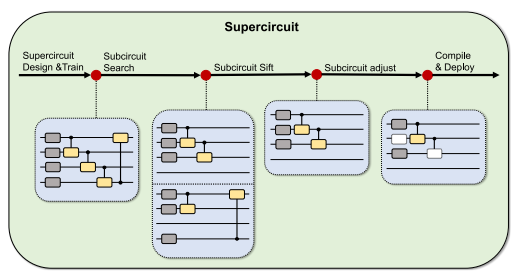
图3:超级电路概述。(1)根据不同的算法构建并训练超电路。(2)寻找合适的子电路。(3)对得到的子电路进行排序,选择最优电路。(4)迭代裁剪和微调,去除多余的门。(5)编译并部署到实际设备上。
(3)针对特定问题的解决方法:除了比较通用的方法外,我们还可以针对一些特殊问题找到一些特定的方法。 这种尝试往往在可扩展性和延伸性方面较差,但在提高个别问题的准确性方面却非常有效。
QUILT 这种方法针对的是具有多个分类任务的量子分类器,这些分类器的准确率往往很低。 QUILT通过建立量子分类器的集成在一定程度上弥补了该领域的不足。 Quilt 背后的一个关键思想是集成较小的分类器模型,而不是使用单个大型分类器模型。 此类决策可确保将量子错误的影响降至最低。 该方法将分类器分为可以对所有类别进行分类的核心分类器和可以提高每个类别准确率的OneVsALL分类器。 通过一个核心分类器和多个OneVsAll分类器的集成解决了该问题。
QUILT 在二元任务中的性能与现有分类器相当,但随着类别的增加,QUILT 在四元和八元任务中分别提供了 22% 和 46% 的改进。
B.提高效率
我们将讨论的另一个方向是提高VQA的效率,同时确保其准确性不受影响。研究该方向的原因是量子机器目前的资源较少,就NISQ而言,用较少的资源执行相同或更多的任务将是有价值的。
(1)剪枝:在NISQ背景下,有限的量子资源限制了VQA的深度。通过适当的剪枝方法,移除对模型影响不大的电路可以以很小的精度代价有效地压缩所需的资源,从而使进一步增加模型的深度成为可能。
On-chip QNN 在此背景下,作者观察到,在绝大多数情况下,小梯度在量子噪声下往往具有较大的相对变化甚至错误的方向,因此通常不需要进行如此小的梯度计算。 通过只计算可靠性高的梯度,剔除小的梯度,可以压缩模型所需的资源,保持甚至提高精度。
In-situ gradient 的计算训练引擎由三部分组成: 1. 通过参数移位的 Jacobian 计算 2. 下游梯度反向传播。 3.梯度计算。 最后,我们可以得到每个参数的梯度。
作者使用5台真实量子机在5个分类任务上进行了广泛的实验,结果比固定剪枝的结果稍强。由此可见,剪枝并不影响模型的准确率,2类和4类图像的分类任务准确率分别达到90%和60%以上。概率梯度剪枝比未剪枝的QNN准确性提高了7%。是时间和节省的百分比 ,提高了效率。 该方法只能应用于QNN,具有一定的局限性,可以在真机上实现。
CompVQC 针对NISQ设备噪声大、资源有限等问题,CompVQC提出了一种基于ADMM的量子神经网络剪枝压缩方法。
该方法分为3个阶段。第一个阶段是准备,从QNN剪枝开始,这为量子场景中的剪枝提供了基础;作者提出:量子门不仅在参数/权重为0时可以被剪枝。然后是QNN量化,需要替换一些特殊的值,使其参数/权重变为0,以减少深度。最后,我们需要为每个门建立一个压缩级查找表(LUT)。第二阶段是压缩,将带约束的非突变问题转化为无约束凸问题。利用ADMM构造压缩级LUTReconstruction,实现QNN压缩。最后,作者开发了一个逻辑量子电路,将上述压缩后的VQC输入转换为编译器映射成一个固定的量子设备。
从实验结果来看,CompVQC减少了电路深度(几乎超过2.5%),实现了约2.5倍的加速,而精度降低(±1%)可以忽略不计。该方法局限于VQC任务,扩展性较差。然而,该方法在不同量子机上的结果是相似的,这证明它不依赖于硬件。
剪枝总结:剪枝是NISQ环境下非常有效的节约资源和提高效率的方法。 On-chip QNN 和 CompVQC 的模型效率都得到了极大的提升。 此外,通过正确的剪枝方法去除模型中一些适得其反的部分,可以进一步提高模型的准确率。 但是,就普适性而言,这种做法往往是 Device dependent,因为模型的不同部分在不同的量子设备下可能具有不同的功能。
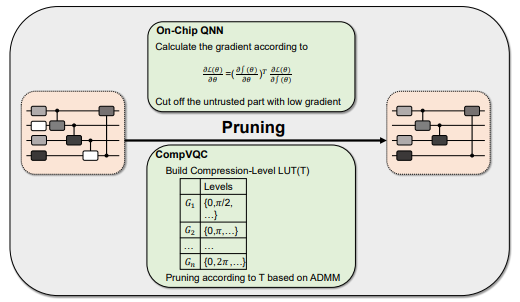
图4:两种不同的剪枝方式:(1)根据不同的梯度进行剪枝。(2)建立以压缩级查找表为基础的查找表,并基于ADMM进行剪枝。
(2)优化映射方法:由于需要将逻辑量子位映射到物理量子位,该操作不是一一对应的,往往需要将逻辑量子位中的复杂门转换为多个基本门。因此,量子比特映射需要一定的策略来降低错误率,加快量子程序的运行速度。
ML-QCP 本文将QCP描述为一个两层优化问题,并提出了一个基于机器学习(ML)的新框架。该方法使用基于策略的深度强化学习(DRL)算法求解底层组合优化问题。该方法克服了传统启发式方法和精确方法的缺点,同时保证了最优性与运行时的权衡。在该方法中,低层为组合问题,通过深度强化学习(deep reinforcement learning, DRL)来解决,高层为离散搜索问题,通过进化算法来解决。与现有的其他方法相比,根据不同的任务,该方法所需的交换门数量有所减少,最大可达90%以上。优化映射到机器上的电路,通过减少基门数量来降低消耗,提高性能,使正常运行时间减少40%。然而,这种方法可能并不适用于大规模电路,并且有一定的局限性。
HA 在本文中,提出了一种考虑硬件拓扑和校准数据的映射转换算法,以提高整体输出状态保真度并减少总执行时间。 该方法基于SABER算法。 通过定义适当的启发式函数,使用迭代的方法来确保所有电路得到适当的映射。 特别是,除了选择插入 SWAP 门之外,如果拓扑允许,此方法还会插入 Bridge 门。
作者使用ibmq almaden和ibmq tokyo将该算法与目前最先进的算法在额外门数方面进行了比较。将HA算法与SABRE算法相结合,得到最优输出。与原始电路相比,门数平均减少30%,效果优于单独使用SABRE算法。作者声称这种方法可以在IBM以外的机器上使用,因此它不依赖于硬件。HA算法只考虑了包括门错误和执行时间在内的校准数据。然而,可以包括其他物理约束,例如串扰误差,以解决互连之间的串扰耦合。
优化映射方法总结:从ML-QCP和HA两个例子来看,更有效的映射方法无疑会大大降低资源的消耗,提高模型的效率。同时,更少的基本门也意味着更少的噪声,这也可以提供精度的提高。由于在模型部署过程中进行了逻辑电路到物理电路的转换,改进后的映射方法可能是在门级最接近基础的映射方法,该方法具有通用性,通常与硬件无关。(如图4所示)
C.脉冲电平控制
现有的量子算法基本上都是以门为基本元件,但这种方式的电路构造与量子器件的底层拓扑不兼容。 因为在这种情况下我们需要编译器将其编译成物理量子位上的控制信号,如图5所示。所以在脉冲级电路的分解和调谐方面还有很多改进空间。
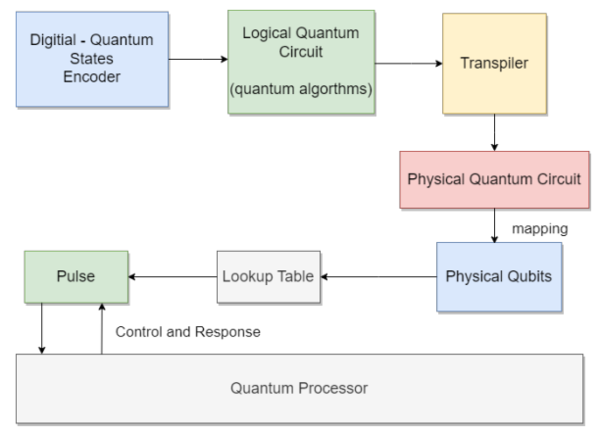
图5:量子计算编译工作流。
PAN 这是第一次在NISQ机器上演示nativepulse ansatz的可行性。这避免了门编译器可能创建的冗余,绕过了现有脉冲发生器优化(如QOC)存在的严重限制,并提供了更大的自由度。PAN首先提取NISQ计算机的配置信息,包括量子比特频率信息以及本地门和本地脉冲之间的映射关系。接下来,根据这些信息构建本地脉冲ansatz。Ansatz具有两种不同类型的层,一种由所有量子比特上的单量子比特主脉冲组成,而另一种由所有连接上的双量子比特主脉冲组成,并且两种类型的层在训练期间依次插入。在构建ansatz时,需要考虑将纠缠的量子比特设置为对应的NISQ机的拓扑结构,以节省量子比特映射的消耗。特别地,PAN提出了一种增量扩展脉冲电路的方法来限制优化器所持有的参数数量,以保证优化器的效率。Ansatz构建完成后,需要进一步剪枝以去除冗余参数。结果表明,PAN与全构型相互作用的效果相当,与真振幅Ansatz的对比证明PAN在保持Ansatz性能的同时,可以将持续时间缩短73.6%。从上述性能来看,脉冲电平操作在很多方面确实优于一般门电平操作,因为暂停电平更适合量子器件的特性,可以提供更大的训练自由度。与门级相比,该方向的研究较少,因此在模型构建方面可用的参考文献较少,这可能是尝试的难点。
4.相关工作
在量子计算领域,已经有很多现有的工作总结了更好地设计 VQAs 的方法。
[48]讨论了QML的错误问题,重点讨论了如何处理QML的噪声感知问题。然而,[48]中讨论的QML改进方法相对于我们的改进方法比较简单。除噪声抑制外,本文还对其他方向的VQA改进方法进行了总结和讨论,如剪枝、映射方法和更好的电路。研究了特殊问题的非一般方法。在门电平之外,脉冲电平也是一个重要的研究方向。
[49]和[50]的主要研究对象是QML,分别综述了QML中的不同算法及其应用。它们的内容仅限于QML,但有更多的细节。本文讨论了包括QML在内的VQA,并详细介绍了如何为VQA设计一个好的ansatz。
5.结论
变分量子算法是将量子计算应用于NISQ环境的一种重要方法。然而,VQA仍然面临许多困难,需要进一步改进。文中总结了现有的VQA改进方法,并分别在门级和脉冲级提出了不同的改进方向。在门级,首先将细分方法分为提高精度和提高效率两大类,并对不同细分方法进行了总结和评价;本文还讨论了电路级以外的脉冲级工作。脉冲电平是一个相对较新的方向,但由于其特点,在电路的脉冲电平分解和调谐方面还有很多需要改进的地方。在本文所描述的方法中,有些计算成本很高,而另一些则依赖于量子,虽然它们在环境中表现良好,但不适合大规模量子应用。尽管有很多技术,但我认为如何开发一种计算成本低廉且可以在真实机器上使用大规模量子算法实现的方法仍然是一个悬而未决的问题。
原文链接:https://arxiv.org/pdf/2212.04913.pdf
---煤油灯科技victorlamp.com翻译整理---
