不平衡的类别使“准确性”失去了作用,这是机器学习中一个令人惊讶的常见问题(特别是在分类中),发生在每个类别中观察比例不相称的数据集中。
标准精度不再可靠地衡量性能,这使得模型训练更加棘手。
1.上采样少数类
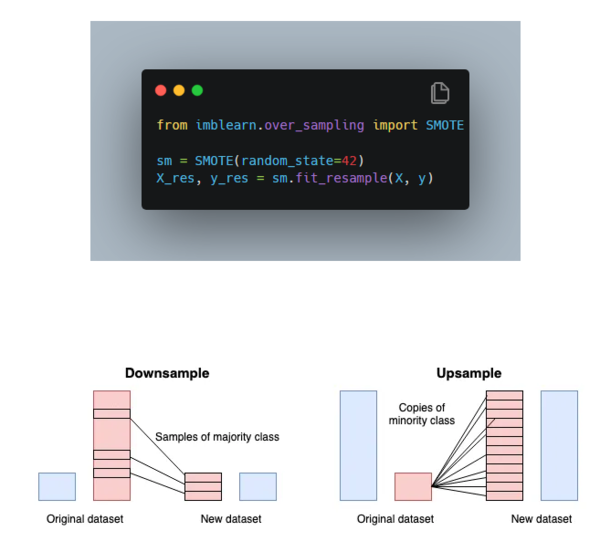
上采样少数类是指在二元分类问题中对代表性不足的类进行过采样以平衡类分布的技术。
上采样背后的想法是随机复制少数类别的示例,以增加其在数据集中的代表性并使类别分布更加均衡,这可以通过减少对多数类的偏见并帮助模型从少数类的更多示例中学习来提高机器学习模型的性能
用例示例:
- 欺诈检测:在欺诈检测问题中,欺诈实例在数据集中非常罕见,向上抽样少数类(欺诈实例)可以帮助提高模型识别此类案例的能力。
- 客户流失:在客户流失预测问题中,对少数群体(已经流失的客户)进行上抽样可以帮助提高模型识别风险客户的能力。
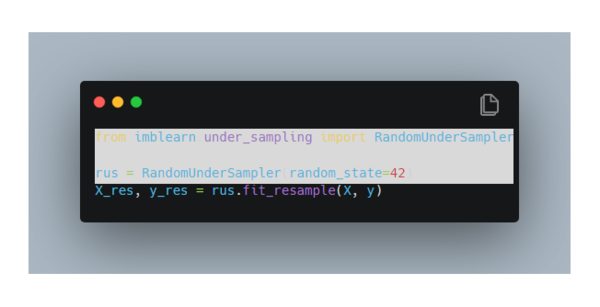
2.下采样多数类
3.改变你的绩效指标
到目前为止,我们已经研究了两种通过对数据集重新采样来解决不平衡类别的方法。接下来,我们将研究使用其他性能指标来评估模型。
阿尔伯特·爱因斯坦曾经说过:“如果你以爬树的能力来评判一条鱼,它会终其一生都认为自己是愚蠢的。” 这句话强调了选择正确评估指标的重要性。
其他要考虑的性能指标是confusion_matrix、precision、recall和f1-score。
4.使用基于树的算法
我们要考虑的最后一个策略是使用基于树的算法,决策树通常在不平衡数据集上表现良好,因为它们的层次结构允许它们从两个类别中学习信号。
在现代应用机器学习中,树集成(随机森林、梯度提升树等)几乎总是优于单一决策树。
概括:
本文介绍了机器学习中的不平衡类问题及其处理方法,当数据集在每个类别中的观测值比例不成比例时,就会出现类别不平衡,这可能会导致标准准确度测量失败。
文章概述了两种处理不平衡类的方法:
对数据集重新采样:对少数类进行上采样(从少数类中随机复制示例以增加其代表性)和对多数类进行下采样(从多数类中随机删除示例以减少其代表性)。
使用替代性能指标,例如精度、召回率和 F1 分数。
使用基于树的算法,例如随机森林或梯度提升树,它们通常在不平衡数据集上表现良好。
参考链接:https://medium.com/@sayahfares19/how-to-handle-imbalanced-classes-in-machine-learning-a7a42bcb54c2
