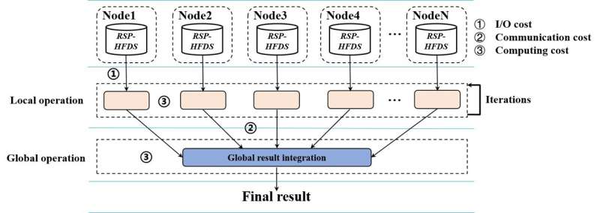
如今,各行各业产生的“大数据”数量之庞大,甚至已经开始压倒为筛选所有信息而开发的极其高效的计算技术。但一个基于随机抽样的新计算框架似乎最终将大数据不断增长的通信、内存和能源成本控制在更易于管理的范围内。
这一篇描述该框架的论文发表在《大数据挖掘与分析》《Big Data Mining and Analytics》杂志上。
近年来,社交网络、商业交易、物联网、金融、医疗保健等领域产生的数据量呈爆炸式增长,这个所谓的大数据时代提供了令人难以置信的统计能力,可以发现模式并提供以前无法想象的见解,但正在产生的大数据量正开始触及计算极限。
在计算机集群或云计算中,复杂算法的可伸缩性开始在大约1TB的数据(或一万亿字节)时步履蹒跚。例如,纽约证券交易所每天产生大约1TB的交易数据,而Facebook用户在同一时间内产生500TB的交易数据。
分布式计算在这种大数据的存储、处理和分析中起着至关重要的作用。这个框架部署了一个“分而治之”的策略,以有效和快速地对其进行分类,这涉及到将一个大数据文件划分为许多称为“数据块文件”的小文件。
这些数据块以分布式的方式存储在计算机集群的许多节点上,然后,这些块中的每一个都被并行处理,而不是按顺序处理,从根本上加快了处理时间。然后,这些局部节点的结果被反馈到中心位置并重新集成,产生全局结果。
这种分治操作由分布式文件系统管理,而分布式文件系统又由编程模型管理。文件系统将大数据文件进行划分,编程模型将算法划分为多个部分,然后这些部分可以以分布式的方式在数据块上运行。
由谷歌开发的MapReduce是用于运行在集群上和跨云的分布式计算的最广泛使用的编程模型,这个名字来源于它的两个基本操作。对节点中的数据块执行Map操作,生成本地结果。这是在多个节点上并行执行的,以大大加快处理时间,然后Reduce操作将所有这些局部结果整理为全局结果。
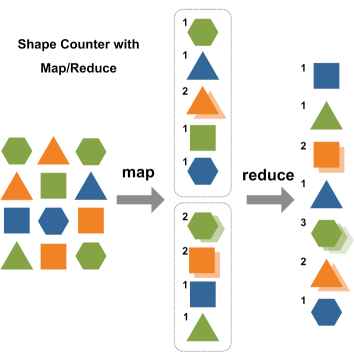
后一个阶段涉及到将本地结果传输到执行Reduce操作的其他主节点或中心节点,所有这些数据变换在通信流量和内存方面都是非常昂贵的。
“这种巨大的沟通成本在一定程度上是可控的,”论文的第一作者、深圳大学计算机科学与软件工程学院的计算机科学家Xudong Sun说。“如果所需的任务只涉及一对Map和Reduce操作,比如在大量网页上计算一个单词的出现频率,那么MapReduce即使是在一个庞大的大数据文件上,也可以在数千个节点上高效运行。”
“但是,如果所需的任务涉及Map和Reduce对的一系列迭代,那么由于大量的通信成本以及随之而来的内存和计算成本,MapReduce会变得非常缓慢,”他补充道。
因此,研究人员开发了一种新的分布式计算框架,他们称之为Non-MapReduce,通过减少这些通信和内存成本来提高集群计算在大数据上的可伸缩性。
为了做到这一点,他们依赖于一种新的数据表示模型,称为随机样本分区或RSP。这涉及到对大数据文件的分布式数据块进行随机采样,而不是对所有分布式数据块进行处理。当分析一个大数据文件时,随机选择一组RSP数据块进行处理,然后在全局层面进行集成,以产生处理整个数据文件的结果的近似值。
在这种情况下,该技术的工作方式与统计分析的工作方式大致相同,随机抽样被用来描述总体的属性。因此,Non-MapReduce的RSP方法是所谓的“近似计算”的一种,这是一种新兴的计算范式,用于实现更高的能源效率,只提供近似而不是精确的结果。
近似计算在以下情况下是有用的:计算成本低的粗略准确结果足以完成手头的任务,并且优于试图交付完全准确结果的计算成本高的工作。
非mapreduce计算框架将为一系列任务带来相当大的好处,例如快速采样多个随机样本用于集成机器学习;直接在局部随机样本上执行一系列算法,而不需要节点之间的数据通信;放宽大数据的挖掘和清理。此外,该框架在云计算中节省了大量的能源。
该团队现在希望将他们的Non-MapReduce框架应用于一些主要的大数据平台,并将其用于实际应用。最终,他们希望用它来解决分析分布在多个数据中心的超大数据的应用问题。
参考链接:https://techxplore.com/news/2023-02-alternate-framework-big.html
