专用硬件使人工智能(AI)模型能够以更快的速度运行,并处理更大、更复杂的应用程序。从2015年开始,包括Habana、Graphcore、Cerebras和SambaNova在内的一些公司就投资这一趋势。2016年5月,谷歌推出了用于推理的张量处理单元(TPU)新版本,亚马逊网络服务(AWS)于2019年底推出Inferentia,2020年底推出了Trainium。
预计到2025年AI半导体市场将达到767亿美元,年复合增长率为28.2%。这一增长背后的驱动力是数据中心,数据中心一直在促进AI硬件初创企业和超大规模企业的创新。事实上,自2015年以来,专注于数据中心专用AI硬件的初创企业已经筹集了超过25亿美元的资金。
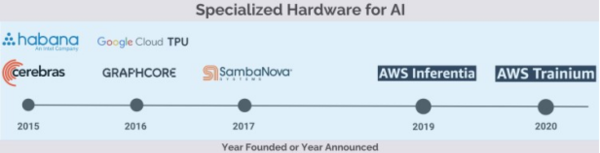
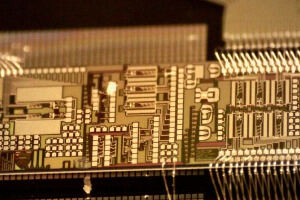
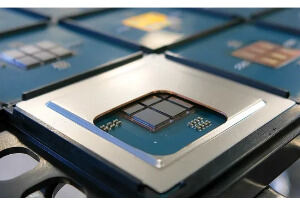
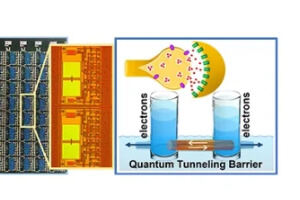
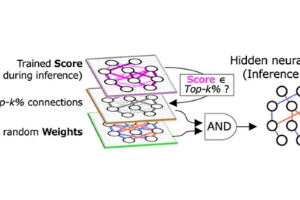
图1:AI专用硬件的代表性样本。
在一份被广泛引用的2018年报告中,OpenAI记录了自2012年以来最大规模的AI训练中计算量的指数级增长。在同一时间段内,观察到的倍增周期为3.4个月,比摩尔定律观察到的2年倍增周期短得多。作者推测,专注于开发专用AI芯片的各种硬件初创公司将在不久的将来推动这一趋势,新硬件将在随后的几年里带来FLOPS/Watt和FLOPS/$的显著增加。
以下,我们首先重新回顾一些关于AI硬件的假设。几年前,业界对AI硬件加速器产生了期望,我们重新审视这些假设,并确定哪些仍然适用于今天。
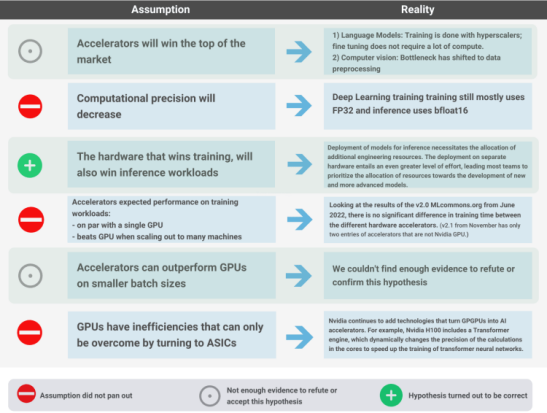
图2:AI硬件——假设与现实。
目前唯一有效的假设是,训练作为一个控制点,用于训练的硬件也收集了大部分推理工作负载。因此,训练继续得到大量的研究关注、投资和关注。AI团队继续开发新的更大的模型,同时研究更有效的工具和技术。
行业参与者正在进行推理工作负载的大部分研究和开发。KDnuggets的一项调查显示,实际部署到生产中的模型比例相对较低,调查受访者的平均比例不到40%,大多数人报告的部署率不到20%。优化和简化推理需要工程和数据科学工作,以便在不牺牲准确性的情况下提高软件性能。当试图使用与训练阶段不同的硬件时,这个过程变得更加复杂。虽然有工具可以促进这一进程,但它需要高度的关注和努力。大多数团队宁愿使用相同的硬件进行训练和推理,而不是使用不同的硬件进行推理,并专注于开发更好的模型。
AI模型继续变大
自从OpenAI的2018年报告以来,我们已经看到越来越大的模型,特别是针对NLP和自然语言应用的模型。专业加速器对于促进AI创新很重要,但它们还不够。型号和浮点运算的增长速度超过了内存和带宽。大型模型的兴起加强了对简单灵活的分布式计算框架的需求。
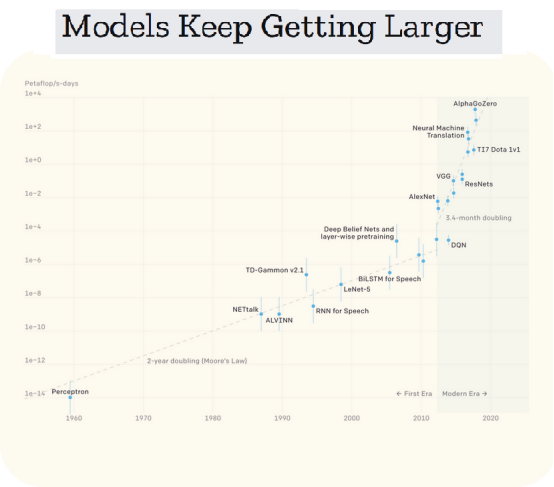
图3:AI模型继续变大。
正如加州大学伯克利分校的Ion Stoica几年前指出的:“…为了实现这一承诺,我们需要克服这些应用程序的需求与我们的硬件能力之间快速增长的差距所带来的巨大挑战。为了弥合这一差距,我们认为除了分发这些应用程序之外别无选择。”
生成性AI和基础模型令人兴奋
生成式AI(Generative AI)有能力创造全新内容,而不是简单地分析或回应预先存在的数据。这些模型能够生成文本、图像、博客文章、程序代码、诗歌、艺术品等等。生成式AI为许多需要内容的新业务和应用打开了大门。例如,在客户显著增长后,Jasper在2022年底筹集了一大笔资金。
生成式AI公司依赖于基础模型——这些模型基于广泛的数据进行训练,然后适应下游任务和应用。例如,那些专注于文本应用程序的人可能使用外部模型或者构建他们自己的语言模型(接收文本和输出文本的大型模型)。
一些公司可能会决定在现有基础模型的基础上进行构建,并根据特定需求和使用情形对其进行定制,而其他公司可能会选择创建自己的基础模型,原因是希望获得更好的控制、数据隐私和合规性,以及快速实现所需功能的能力。这与使用外部基础模型形成对比,后者通常只提供API访问,可能会带来数据传输/共享以及添加必要功能的速度方面的问题。
决定构建自己的基础模型的生成型AI公司将在经济效率的激励下,转型为提供AI机架规模系统的AI硬件加速器公司,这些系统结合了硬件和软件,以降低总拥有成本。
重新关注数据任务
机器学习工程师和其他数据专业人士普遍认为,对数据进行优先排序比只关注建模更有效。这得到了多年调查的支持,调查表明数据团队经常将大部分时间花在数据获取、清理和扩充上。2021年,吴恩达(Andrew Ng)创造了以数据为中心的AI这一术语——通过清理、扩充和增强数据集来提高ML模型准确性的技术和工具,现已成为从业者和研究人员的工作例程。
目前唯一有效的假设是,用于训练的硬件也收集了大多数推理工作负载。
为了实现以数据为中心的方法,团队必须在训练前彻底准备好他们的数据。这一过程称为预处理,涉及各种任务,如清理、重复数据删除、去噪和异常检测,以及可视化以优化用于训练的数据。虽然预处理是整个训练过程的重要部分,但与训练本身相比,它在计算需求上可能有所不同。为了优化端到端的ML流水线,有必要考虑数据预处理和训练速度,以便最大化资源效率。随着训练的模型越来越普遍,并且被不同的个体微调,管道中预处理阶段的重要性只会增加。
分散定制模型的出现
如前所述,一些团队选择开发他们自己的定制基础模型,原因包括增强控制、数据隐私和遵从性,以及快速添加必要特性的能力。
“如果只有API访问,那是不够的。这取决于一个公司想要投资多少技术,他们拥有多少数据,以及他们是否愿意将数据提供给一个API或其他人。我不认为会有一个像GPT一样的模式来统治所有人,这将归结为组织结构的动态变化,以及信任、成本等因素。”(引自斯坦福大学的Percy Liang谈分散定制模式的可能崛起)
另一类应用程序也需要定制模型。尽管大模型训练的趋势继续主导着围绕AI,但越来越多的企业发现有必要训练和部署更多(更小)的机器学习模型——有时数量会达到数百或数千个。最近Anyscale博客帖子列出了常见的场景,包括每个地理区域、每个传感器/设备或每个客户/产品对定制模型的需求。与提供个性化推荐或输出的集中式模型不同,这些模型是不同的,并且是单独训练的(最好是并行的)。
与大型集中式模型相比,这些分散式定制模型需要不同的硬件规格。在许多小模型的环境中,每个模型的训练需要较少的资源(由于训练的并行化),这些资源彼此之间不通信。虽然由于数量原因,较小的模型可能需要更多的计算资源,但它们需要的横向扩展能力较少。
结束语
最近,采用AI的高级超级计算技术引起了大量的关注。英伟达和微软宣布合作开发Quantum-2,这是一个基于云的AI应用超级计算平台。特斯拉还透露了其Dojo超级计算机的计划,该计算机利用专有芯片,旨在不久的将来为企业客户提供接入服务。Cerebras发布了Andromeda则是一台AI超级计算机,拥有1350万个内核,能够提供超过1 exaflop的AI算力。Jasper使用大型语言模型,拥有超过85,000名客户,并与Cerebras建立合作伙伴关系,以进一步增强性能并优化其下一组模型。
AI也越来越多地被用于设计硬件。随着AI工作负载的持续增长,芯片设计人员面临着越来越大的压力,需要创新和提高计算平台的性能。设计过程受益于AI的一种方式是使用AI工具,这些工具可以优化耗时的任务,让设计师专注于更具创造性的工作。这不仅提高了效率,还推动了该领域的进一步创新。
大模型的训练长期依赖英伟达GPU和谷歌TPUs,这让新的硬件加速器面临着一个重大障碍,因为支持它们的公司不具备开发可与CUDA或XLA相媲美的软件堆栈的资源。另一种解决方案是开发扩展到加速器指令集的开源软件堆栈。这一领域的一个显著进步是PyTorch 2.0和Triton软件栈的出现,旨在使非Nvidia后端的实现越来越更容易。希望这个开源软件栈能够成熟,并最终为大型模型的训练提供一个可行的CUDA替代方案。
最后,我们研究了服务器专用硬件的使用。然而,值得注意的是,边缘计算正在成为计算领域的变革趋势。传统模式通常依赖于集中的高容量计算和存储资源,而边缘计算涉及在网络外围处理数据,而不是将数据发送到中心位置。这种方法可以在许多情况下提供更低的延迟和更高的安全性。
原文链接: