今天的复杂SoC正在接近(在某些情况下已经超过)单个硅晶片可以制造的物理极限,而且大的芯片尺寸会产生更大问题。一个根本原因是,目前不可能打印出比芯片制造光刻阶段所用蓝图更大的芯片,即光掩模。因为技术限制,穿过光掩模将蓝图复制到硅晶片上的光束不能印刷大于约850平方毫米的芯片。
如果不将设计分解成多个管芯(或多个小芯片),工程师将无法设计出一些尖端的SoC。但是,以尖端技术在单个大管芯上生产单片SoC的经济性正变得(或者可能已经变得)令人望而却步。
大的单片电路更容易产生不可修复的缺陷,更小的芯片则导致更低的产量和更高的总拥有成本。在基于小芯片的设计中,每个小芯片都更小,因此需要丢弃的不可回收芯片的硅(芯片)量更少,从而降低了成本。最新光刻节点的成本越来越高的趋势正在进一步加剧,AMD估计使用基于Epyc处理器的小芯片可以降低40%以上的成本。
当SoC被分成小芯片时,设计变得更加模块化。第一个优点是,这可以允许以最佳光刻技术制造不同的小芯片。例如,许多射频(RF)电路在尖端逻辑处理技术中表现不佳,如果将这些电路设计在一个小芯片上,就可以使用密度较低但更合适的工艺技术,从而获得更佳性能。另一个例子是分立的大SRAM,从计算逻辑晶体管到不同芯片的存储器(如大型系统高速缓存),可以优化每个芯片的工艺,从而提高整体性能指标,如功耗、功耗、工作频率。
人们甚至可以想象使用不同工艺技术来构建SoC。更模块化的设计也有利于重用,行业“圣杯”是从不同的IP/小芯片提供商处采购整个小芯片,并将它们缝合在一起以创建定制的SoC。如今,设计师可从不同的供应商处采购IP,而实现这一愿景依然面临诸多挑战。
首先是还没有一个标准来描述不同的小芯片如何相互通信。2022年,通用小芯片互连标准(UCIe)1.0点燃了业界D2D(die-to-die)互连标准化的热情。虽然D2D很早就引起了人们的兴趣,但这将是一个漫长的旅程。
基于小芯片设计的最后一个优势是尤其适用3D集成SoC。随着3D小芯片的集成,现在有了第三维度来利用和“路由”信号,从而可能缩短逻辑之间的距离。3D集成显然也可以实现更高的面积密度。随着最新一代工艺技术中光刻技术发展速度的放缓,3D集成可能成为继续发展的一个重要方面。当集成3D并使用第三维布线时,逻辑之间的潜在更小距离也可以转化为多种优势,如减少延迟和功率(较小的电容)。
小芯片设计的挑战
虽然基于小芯片的设计有许多优势,但在构建这些复杂的设计时也存在许多挑战。
首先,对于集成到单个封装中的每个额外的小芯片,存在导致封装工艺中缺陷的风险,从而导致非功能性封装和封装级别的良率损失。因此,虽然制造单个小芯片的成本随着小芯片的减小而降低,但是将它们封装在一起的成本却增加了。为了低成本,基于单个芯片的设计可能仍然是最经济的。
今天的D2D接口是多个小芯片设计中D2D通信的主力,与片上标准导线相比,在硅上占据更大面积,导致了“面积税(area tax)”。
今天的D2D接口不像单个芯片上的常规导线那样密集。对于跨接不同小芯片的信号,它需要首先被路由到D2D接口PHY,被驱动离开管芯,到达另一个管芯的D2D接口PHY,并且最终路由回管芯上的导线。这里列出了一些局限性,在连接管芯之间的材料(衬底材料,或硅“桥”)上可以印刷更密集的导线、可以制造更小和更密集的焊料凸块(在使用焊料进行D2D连接的技术(例如,英特尔Foveros),以及该区域内是否正好有额外D2D PHY逻辑。
跨多个小芯片进行设计和优化显然比构建单芯片更加困难和复杂。电子设计自动化(EDA)供应商正在积极开发工具来帮助划分、设计、分析2D和3D集成的多小芯片设计。针对这些设计流程,已经发布了一些工具,比如Cadence 3D-IC、Synopsys 3DIC编译器。
正如前面提到的,对于D2D通信,还没有一个成熟的标准。迄今为止,多小芯片设计工作仅限于从IP到SoC产品。UCIe 1.0定义了通用PHY层,以及通过D2D接口承载PCIe和CXL的协议层。但是,如果您需要承载其他协议,该规范基本上将定义留给了实现者。为了拥有能够完全互操作的小芯片生态系统,需要进行更多的标准化以承载非PCIe和非CXL的其他协议(例如AMBA协议)。
小芯片D2D接口
业界已经有许多现存的、相互竞争的D2D接口。下表显示了目前市场上的一些主要D2D接口。
比较D2D接口时,设计人员会使用几种常见的指标:
- 数据速率:单个数据I/O的数据速率。
- 成球间距(pitch):芯片上D2D PHY的相邻数据I/o之间的间距。
- 功率效率:向另一个芯片传输1位数据的功率。常见的度量是pJ/bit。
- 边缘密度:数据速率和凸点间距的综合指标。一个常见的指标是Tbps/mm,这意味着对于1mm的芯片边缘,可以封装多少个I/o(以及数据速率是多少)。
- 面密度:数据速率和凸起间距的综合指标。一个常见的指标是Tbps/mm2,这意味着对于1mm2芯片面积,可以封装多少个I/o(以及数据速率是多少)。
小芯片集成方法
可以使用多种方法集成小芯片。英特尔和TSMC拥有相似的竞争技术来满足不同的集成需求。一些主要方法类别包括:
(1)标准/多芯片封装
(2)2.5D硅内插器
(3)2.5D硅“桥”
(4)3D键合
(5)3D混合键合
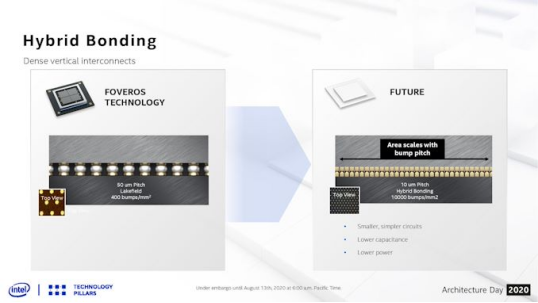
焊接和混合焊接小芯片集成方法比较(2020年英特尔架构日)
每种小芯片集成方法使用不同的技术和制造流程,导致不同的属性。但是,一个关键对比指标是D2D接口的凸点间距,它决定了能封装的D2D接口的布线密集度,并且间接影响到D2D接口的带宽。作为参考,一些D2D技术的凸块间距的顺序为:
标准封装:100微米
2.5D高级封装(例如英特尔EMIB):50um
3D(焊料)焊接(例如英特尔Foveros):50微米
3D混合结合(例如英特尔Foveros Direct):<=10um
标准/多芯片封装
标准封装是理解起来最简单的集成方法。多个管芯被简单地放置在单个封装衬底上,并通过衬底中的走线连接在一起。这有时也被称为多芯片模块(MCMs)。不涉及先进的封装技术。
2.5D集成方法
2.5D集成方法仍然在2维中集成管芯。名称“2.5D”意在表达这些先进的封装方法与传统的2D集成方法(标准)相比,可以实现更高的信号密度/多芯片封装)。
硅中介层(silicon interposer)是位于芯片和封装基板之间的一块硅。由于该层由硅制成,因此可以使用先进的硅制造工艺来制造,并实现密集的凸块间距。然而,类似于制造任何其他硅管芯,为了将信号从硅管芯的顶侧传递到底侧,需要在硅中制造硅通孔(tsv)。这个额外的一块硅(中介层)和硅通孔会增加解决方案的成本。
2.5D硅桥(2.5D silicon bridge)封装指的是在(非硅)中介层或基板内嵌入较小的“桥”状硅片以充当D2D互连的集成方法。这种方法的一个例子是英特尔嵌入式多芯片互连桥(EMIB)技术。
3D键合
3D集成方法真正以三维方式堆叠芯片,一个在另一个之上。更传统的3D集成方法使用焊料凸点将两个芯片键合在一起。使用焊料凸块来键合管芯在密度上有局限性,并影响在3D D2D互连中能够实现的最终凸块间距和信号密度。英特尔Foveros是3D键合技术的一个例子。
3D混合键合(互连;HBI)
3D混合键合也是真正的3D集成。它不使用焊料微凸块来键合两个芯片。相反,每个管芯的互连暴露在管芯表面上,并且直接键合在一起(没有焊料)。这种技术去除了焊料凸点,这是凸点间距和互连密度的限制因素之一。结果,混合键合可以实现小得多的凸块间距。英特尔Foveros Direct是3D混合键合的一个例子,支持凹凸间距<10微米。
小芯片SoC示例
英特尔和AMD都在其最新的服务器和客户端CPU中采用了基于小芯片的设计。
服务器CPU方面,AMD的第三代EPYC(Milan)处理器由8个CPU小芯片和1个I/O小芯片组成,以2D方法集成。这个具有3D V-Cache的AMD Milan-X处理器还在每个计算芯片的顶部集成了一个3D SRAM高速缓存芯片。
英特尔Lakefield混合CPU是首款采用英特尔Foveros 3D集成技术的SoC,而带有3D V-Cache的AMD Milan-X处理器是3D集成的另一案例(由TSMC制造)。英特尔即将推出的Sapphire Rapids Xeon服务器CPU也是基于小芯片的设计,由4个小芯片组成,使用EMIB以2.5D连接。
GPU方面,英特尔Ponte Vecchio是基于小芯片设计的极端高性能计算例子之一,每个SoC包含多达40多个芯片。
结论
基于小芯片的SoC设计已经成为许多高端市场的主流,如服务器CPU、HPC GPUs和高端客户端CPU。基于小芯片的设计提供了许多优势,如潜在的低成本、克服最大管芯尺寸(光罩尺寸)、更密集、更模块化、更多可重复使用。但它们也带来了许多挑战,如更高的设计复杂性、封装缺陷导致的良率降低,以及许多专有协议和竞争标准。正在积聚动力的UCIe就是其中之一,但要通过混合和匹配来自不同供应商和代工厂的小芯片来构建SOC,实现这样的愿景将是一个漫长的旅程。
原文链接:
https://www.verilogpro.com/how-chiplets-assemble-into-the-most-advanced-socs/
