摘要
区块链和去中心化存储网络等举措正在推动去中心化 Web3 取代当前架构。 Web3 的核心是网络资源共享服务,它允许任何人出售闲置网络容量以换取奖励。 这些服务需要一种建立信任的方法,因为各方可能是恶意的。 这可以通过信誉系统来实现。
在本文中,我们提出了在 Web3 信誉计算中使用深度强化学习的案例。 更具体地说,我们提出了一种模型,该模型允许为用户高度个性化地分散计算分数。
索引词—信誉系统、深度强化学习、区块链、Web3、资源共享服务
I. 引言
在过去的十年中,人们越来越多地呼吁去中心化的 Web3,旨在解决当前中心化基础设施的缺点,包括单点故障、审查和数据隐私。
去中心化 Web3 的一个重要方面是能够将任务外包给备用资源,从而创建网络资源共享 (NRS) 服务。 这是必不可少的,因为不应盲目信任中央服务器(例如云)。 NRS 服务可大致分为存储、计算或带宽共享服务。 服务也可以针对所有这些,就像分散式内容分发网络的情况一样。
在去中心化网络中共享网络资源并不是一个新概念,但 Web3 计划的独特之处在于它们与区块链的集成以创建激励层。 经典的对等 (P2P) 系统存在许多问题,从长远来看使它们变得无用,包括搭便车、由于流失造成的不稳定和安全漏洞 [1]。 通过以加密货币奖励的形式为已完成的工作提供公平交换,基于区块链的 NRS 服务增加了激励、安全性和稳健性。
NRS 服务的一个突出例子是 Filecoin [2],一个去中心化的存储市场。 区块链用作激励层,允许客户和卖家在公共分类账上创建存储交易并相应地奖励存储节点。 由于区块链上的存储效率非常低,数据存储在本地存储节点上。
虽然区块链可用于为链上交易建立信任,但实际的 NRS 服务是在链下提供的,并直接发生在两方之间。 这意味着我们不能仅仅依靠诚实的大多数网络来保证安全。 一个简单的例子是承诺提供服务但无法完成服务的提供者节点。
虽然它不会获得额外的奖励,但客户可能会遇到额外的负面后果。 由于网络中的任何节点都可能是恶意的,因此每笔交易都存在风险。
为了区分诚实方和恶意方,需要一个信誉系统。 通常,信誉系统是一种为网络中的节点生成分数的机制,表示对可能的积极体验的信任。信誉系统聚合了许多指标并遵循评分机制来产生分数。 信誉系统的一个常见用例是在电子商务中,其中使用交易反馈在买卖双方之间建立信任。 然而,这些类型的信誉系统依赖于中心化的基础设施,因此不适合 Web3 应用程序。
P2P 研究提出了许多分布式信任和信誉系统 [3],但由于其复杂性和安全漏洞,这些最终没有得到大规模采用。尽管这些系统使用了一系列公共和私人指标,但据我们所知,没有一个系统包含区块链数据。
II. WEB3 信誉系统要求
目前,NRS 服务要么不使用信誉系统,要么依赖集中式服务。 这些不仅是单点故障,而且它们还缺乏透明度和控制使用哪些指标和评分功能。 例如,第 3 方 Filecoin Dashboard Storage.Codefi在计算信誉评分时更强调存储故障而不是要价,这可能无法代表所有用户偏好和他们的风险厌恶程度。
相反,Web3 服务需要一个去中心化的信誉系统。 由于去中心化服务和区块链的紧密结合,Web3 信誉系统应该使用链上数据来导出用于计算信誉分数的指标。 此外,系统应该是准确的、快速收敛的、安全的和轻量级的。
最后,声誉评分是高度主观的指标。 根据个人喜好和经验,一个节点对卖家声誉的看法可能与其他节点不同。 事实上,单个卖家作为存储节点可能会被视为信誉良好,但在其他服务中却并非如此。 因此,需要高度个性化的信誉服务,它可以根据个人偏好配置文件进行自适应。
III. 基于人工智能的声誉
在这项工作中,我们建议使用人工智能 (AI) - 特别是深度强化学习 (DRL) - 来协助计算个性化声誉分数。 这满足了第 II 节中描述的要求,为 Web3 服务创建了去中心化的信誉解决方案。 使用人工智能使我们能够考虑范围广泛的指标来生产。
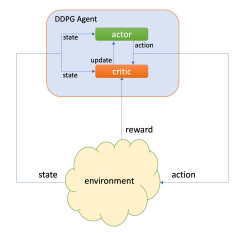
图 1. 我们的 DDPG 算法概述。
信誉计算包括两部分:收集信息和计算分数。 我们提出的解决方案直接使用区块链数据作为输入,因为大多数 NRS 服务交易都存储在链上,并且可以从过去的交易中推断出很多。 信誉系统的用户还提交个人偏好配置文件,其中可能包括对例如 不同权重的成本节约或安全性。
第二部分,即分数的计算,由我们的 DRL 算法负责,该算法从过去的经验中学习以创建评分函数。 我们提出的具体 DRL 算法是 Deep Deterministic Policy Gradients (DDPG) [4]。 DDPG 与其他算法相比的主要优势在于它能够输出近似连续的动作。 由于我们的应用程序应该具有广泛的可能输出,因此其他 DRL 算法将不符合条件。 如图 1 所示,该算法将环境信息作为输入状态,之后 agent 内部的 actor 输出一个动作。 这个动作一开始是随机的,但随着时间的推移随着训练变得更聪明,因为评论家会根据输出动作的奖励收到反馈。 这样,评论家不断更新角色。
使用用户的个人偏好配置文件,我们的模型生成个性化的声誉评分函数,然后用户将其与区块链数据一起使用来计算分数。虽然训练模型可能是计算密集型的,但在获得模型权重时的实际分数计算是轻量级的。 训练模型最初是使用历史区块链数据完成的,之后会根据使用数据不断更新。
IV. FILECOIN 示例
我们现在说明我们的模型如何在去中心化存储市场(如 Filecoin)上运作。 我们代理的输入状态包括从区块链交易推断的节点信息(我们想要给谁打分),以及用户的虚拟余额。 区块链推断数据的示例包括平均交易时间、可用存储大小、失败的交易以及自加入网络以来的时间。 同时,需要用户的偏好配置文件以评估动作。最初,模型需要根据从链中提取的历史数据进行训练,以变得准确。
每个输入周期,DDGP 算法都会根据输入状态输出一个动作(从 0 到 100 的信誉分数)。 在我们的示例中,不良输出的后果可能是由于错误的推荐而导致利润损失,以及未能与诚实的交易对手达成交易。 评估行动对于向我们的模型提供反馈以供其学习至关重要。
生成输出分数后,将其映射到 sinc 函数,该函数表示与节点进行交易的概率 P。 如果分数超过 95,则 P 为 1,如果分数低于 30,则 P 为 0。动作的准确性(以及奖励)取决于 P 与用户决策 D 之间的距离。在我们的初始训练中,D 是通过从节点信息推断偏好配置文件获得的,而该偏好可以从用户反馈中获得。 当 P 和 D 都低于或高于 0.5 时,奖励将为正,并且它们越接近,奖励就会增加。 奖励被添加到将被转发到下一个状态的虚拟余额中。 经过足够的训练后,模型将学习用户偏好并优化这种平衡。
V.讨论
我们已经描述了如何使用 DRL 模型来创建个性化的声誉评分系统。 虽然当函数已经被模型训练时计算分数是相当轻量级的,但实际的训练阶段可能是计算密集型的。 因此,一个悬而未决的问题仍然是这种培训将如何在实践中进行。 一个完全分布式的场景会让每个节点运行自己的 DRL 算法,但这对所有节点来说可能并不可行,尤其是移动用户,因为他们的设备可能资源相对匮乏并且有电池限制。 此外,这会产生大量冗余工作,因为许多用户将具有相似的偏好配置文件,因此具有相似的功能。
一种更可行的架构将允许网络中的节点外包算法的训练,同时在本地计算分数。 他们将提交他们的偏好配置文件,获取匹配函数,并在查询区块链的输入数据后在本地计算分数。 我们计划在未来的工作中进一步探索这些可能性以及所提出模型的性能。
