据调查,美国每34秒就有一人死于心血管疾病,全球每年约有 1790 万人死于心血管疾病。从这个意义上量化它是非常可怕的,这也更清楚地表明了心血管疾病的严重程度。
找到应对这一疾病的解决方法之前,首先我们需要完整地了解心血管疾病。我们已经计算出心脏病的定量影响。那么,造成这个数字的基本原理是什么?它的影响变量是什么?根本原因是什么?
当然,影响该数字的风险因素包括一个人的吸烟记录、高血压、高胆固醇等。但是,当将这个数字归结为确定为什么它如此之高时,归结为这些疾病未被发现的频率。这就是心脏病死亡率在百万以内的根本原因。
与许多其他复杂情况一样,直到它达到晚期,你才可能意识到它的存在,因为早期阶段通常没有任何明显的症状引起人们对身体健康程度产生怀疑。
这就是为什么心脏病被称为“沉默的杀手”——因为它们随着时间的推移悄无声息地发展,当症状出现时,通常已经来不及预防严重的并发症或死亡。
因此,根据信息,减少该数字可以落入两条路径之一;在疾病的最后阶段治愈它,或者在能够治疗它的时候及早诊断它。
前者的问题在于解决方案背后的复杂性——由于造成的严重损害,几乎不可能逆转心脏缺乏泵血能力的情况。
但是,更早地诊断出这种疾病是朝着简化心脏病导致的高死亡率迈出的一步,这样我们就可以在能够“轻松”做到的时候管理和解决这种情况。
我们需要采取行动避免可预防的死亡率。
现状——正在做什么?
目前,科学家们一直在探索一系列解决方案(包括筛查项目、先进的成像技术、生物标志物、可穿戴设备和远程医疗)来测试心脏病的危险因素。但是,目前最大的焦点之一在人工智能领域。
目前,我们已经确定了一些可能影响心脏病患者的风险因素,包括:
- 年龄
- 性别
- 家史
- 抽烟
- 高血压
- 高胆固醇
- 糖尿病
- 肥胖
- 缺乏运动
- 不健康的饮食
一段时间后,在这些风险因素的状态及其与心脏病的相关性之间建立联系或确定模式可以帮助我们。因此,如果某人有高龄、高血压和吸烟史,你可以预测他们有患心脏病的风险,这允许在他们的生活方式中采取更多预防措施来避免或及早发现疾病。
人类可以手动完成此操作,但这是一个耗时且劳动密集型的过程。此外,人工分析容易出现错误和偏差,这会影响结果的准确性和可靠性。
所以,技术是我们的下一个赌注。
我们可以利用人工智能快速准确地分析大量数据,并识别人类分析师可能不明显的模式和趋势。这是通过支持向量机来实现的。
支持向量机 (SVM) 是一种可用于分类和回归分析问题的机器学习算法。
他们通过创建一个边界(也称为“超平面”)来分隔高维空间中不同类别的数据点。超平面的目标是最大化不同类别的数据点之间的间隔,以便不可见的数据可以以相同的方式进行分类。
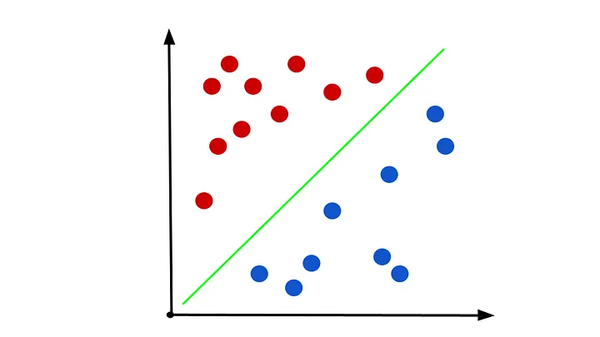
支持向量机的可视化表示
如果技术术语没有意义,我们可以将 SVM 想象成一个试图制定良好防守策略的足球教练。教练需要制定一个比赛计划,有效地防御对方球队的进攻策略,所以他会在场上相应地区分不同类型的球员。
支持向量机是非常常见的。我敢肯定,我们已经习惯了我们的邮件软件预测哪些邮件是写给你的收件箱的,哪些是垃圾邮件——而SVM负责这一切。
在诊断预测的背景下,它们在一定程度上也相当强大。它们是一个强大的工具,因为数据是复杂和高维的,而且它的准确性很强。
但是,即使人工智能技术已经取得了显著的进步,我们的人工智能模型能够有效分析的数据量仍然是有限的。不幸的是,这一限制远远小于在现实场景中进行准确预测所需的数据量。
这种限制导致解决方案在实际应用中效率低下。
利用量子支持向量机
克服问题和有效解决方案之间这一障碍的关键是量子支持向量机。
量子 + 支持向量机 = QSVM
QSVM 是一种量子机器学习算法,使用量子力学原理来执行分类和回归任务。
他们背后的基本思想是,他们使用量子计算机以更有效的方式执行我们使用 SVM 算法执行的计算。因此,QSVM 正在解决我们的效率挑战,同时保持我们正在做的事情的当前状态。
接下来,让我们分解一下量子支持向量机的工作原理,以及我们如何使用该算法更早地预测心脏病。
数据准备
当然,我们已经发现,在进行预测之前,我们需要分析大量数据。所以,我们的第一步是将数据准备成量子计算机可以理解的方式,因为目前我们正在处理经典数据。
它表示为:
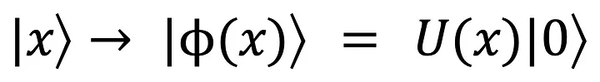
在这里,|x ⟩表示一个经典的输入数据向量,它通过将酉算子 U(x)|0 ⟩应用到其初始量子态 |0 ⟩ 来转换为量子态 | Φ (x) ⟩ 。
在没有复杂性的情况下,通过量子特征映射将心脏病风险因素的过滤数据(因此在没有任何偏差或重复的情况下清除最相关的因素)转换为量子态,这个特征映射是一个酉操作,通过应用量子门序列将经典数据映射到量子态。
这个正在讨论的“特征映射”可以通过各种量子电路实现,但最常见的是量子傅里叶变换或振幅编码。
这两种技术的最终目标是将经典输入映射成一种可以被量子算法处理的方式,但它们的路径彼此不同:
量子傅里叶变换 (QFT):这种量子电路将经典数据转换为具有周期性的量子态,这有助于解决某些需要周期函数的分类问题。并且,这是通过使用一系列 Hadamard 和受控相位门来操纵一组量子位的状态来完成的。
振幅编码:该量子电路通过使用输入数据的二进制表示将经典数据编码为量子态的振幅,为其提供振幅的量子表示,因为在量子力学中,量子系统的状态由波函数描述. 它允许量子态表示比经典数据大得多的数据空间,这对于某些类型的分类问题很有用,例如涉及高维数据的问题。
QSVM 中量子特征图的选择取决于数据的性质和要解决的具体问题,这些只是最常见的特征图。无论如何,电路背后的意图是完全相同的,即将我们的风险因素的经典输入数据转化为量子态。
量子核计算
一旦我们的数据准备就绪并准备就绪,我们就可以继续下一步。
现在,我们计算一个矩阵——一个数字数组,描述每对输入数据点在其量子特征表示中的相似程度。而且,这是通过量子核计算完成的。
这个矩阵的结果可以帮助我们分类;目前有心脏病还是健康的心脏?形式上,我们为分类声明的两个类别称为“类”,因为有两个类,所以这是一个二元分类问题。
我们专门寻找的矩阵类型称为核矩阵,它描述了与输入数据点对应的量子特征向量之间的成对内积。
简而言之,这意味着计算量子态向量的数学运算,以获得这两个数据点在其量子特征表示中的相似性度量。该相似性值可以帮助我们形成超平面,因此我们可以正确地将数据分类到其二元分类中。
因此,假设我们通过振幅编码对数据进行了预处理。电路的量子核函数定义为:
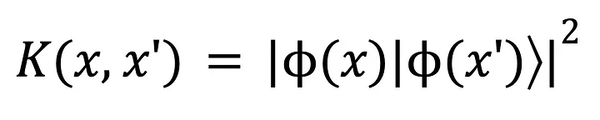
这里,|φ(x)⟩和|φ(x')⟩分别是输入数据点x和x'对应的量子态,⟨φ(x)| 和 ⟨ϕ(x')| 是它们的共轭转置状态。
为了确定一组输入数据点的量子核矩阵,我们可以使用量子电路将振幅编码电路应用于所有数据点对,然后再测量它们的量子态之间的重叠——这可以通过量子相位估计。
该算法估计酉变换矩阵的特征值 — U(x, x') = U(x)† U(x') — 对应于量子核函数。并且,一旦获得了估计的特征值,我们就可以使用它们来计算将计算内积的量子核矩阵。
它可以表示为……
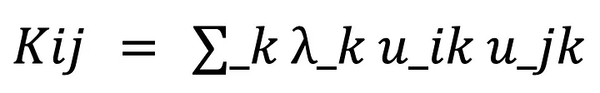
其中 λ_k 和 u_k 是矩阵 U(x, x') 的特征值和特征向量,u_ik 和 u_jk 是它们对应的第 k 个特征态的分量。
在这个计算中发生的所有事情都是通过对所有 k 的特征值和对应的特征向量项的乘积求和来计算核值 Kij。这相当于取特征向量矩阵的第 i 列和第 j 列之间的内积,并由相应的特征值加权。
一旦该步骤完成,就应该形成一个超平面——它为健康心脏和心脏病感染心脏的数据点创建一个分隔空间。
量子 SVM 训练
转到该算法最重要的部分,即计算机的训练。
就像人类一样,我们的机器需要在掌握一项任务之前学习它。而且,在这种情况下,确保我们的量子计算机在如何预测某人有患心脏病风险方面接受过全面培训非常重要。
此步骤的目标是优化我们电路的参数以获得最佳分类结果。这通常通过QAOA或VQE等优化算法来完成。
无论哪种方式,这些算法都用于最小化成本函数——这是衡量模型准确性及其与训练数据拟合程度的指标。
在数学上,它表示为……
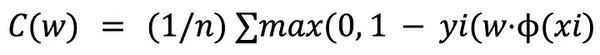
其中:
- w = 权重向量
- b = 偏置项
- xi = 训练输入向量
- yi = 相应的输出标签
- λ = 正则化参数
在整个过程中,量子电路内的所有潜在参数值都通过哈密顿矩阵表示。因此,通过这里,优化算法通过找到哈密顿量的基态来工作,它对应于系统的最小能量状态。
无论哪种方式,量子电路都会迭代修改模型的参数以找到成本函数的最小值。并且,这些参数涉及上式中的参数,包括:权重向量、偏置项和核参数。最后,优化算法试图通过找到这些参数的最优值来最小化成本函数。
这通常是算法中最耗时的部分,但对于电路来说,熟悉所有数据点也是至关重要的,这样才能自信地做出正确的分析。
测量与预测
接下来是算法的最后一步。
现在,我们将努力从前面步骤中准备和操纵的量子态获得经典输出。那么,还记得我们将经典状态“映射”到量子状态吗?我们基本上是通过将现有的量子态映射到它的经典态来扭转这种局面。
这是通过将量子态投射到经典态上的测量来完成的——而且,这个结果可以是与量子态振幅相对应的任何可能的经典态。
一旦我们的模型经过全面训练,为了在新的输入数据点上获得类标签,应用训练阶段的相同步骤,首先使用量子特征图将输入数据编码为量子态,然后将量子使用与训练中相同的过程计算内核。因此,当一个新的输入到达这个阶段时,它将经过上述过程,然后再被测量到这个问题的两个类别中。
无论如何,测量过程是 QSVM 算法中的关键步骤,因为它可以从量子态中提取经典信息——这是人类将用来进一步交流结果的信息。
测量可以在数学上表示为在给定量子态 |ψ⟩ 的情况下获得特定经典态 |i⟩ 的概率:
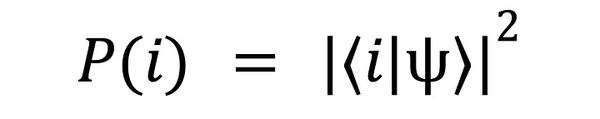
在这里,|i⟩ 表示可以通过测量获得的一种可能的经典输出状态,并且 ⟨i| 表示 |i⟩ 的相应共轭转置。并且,符号 ⟨i|ψ⟩ 表示经典状态 |i⟩ 和量子态 |ψ⟩ 之间的内积。
并且,⟨i|ψ⟩的绝对值平方表示在测量量子态|ψ⟩时获得经典输出态|i⟩的概率。
总而言之,你终于收到了可以用来判断某人是否有患心脏病风险的经典输出。
量子优势?
理论上,与经典 SVM 相比,QSVM 有可能提供指数级的加速,因为它们利用了量子计算机。量子计算机并行执行某些计算的能力可以为用户提供“量子优势”,从而提高现有解决方案的效率。
量子支持向量机具有这种加速的主要领域是在内核计算步骤中。在经典 SVM 中,核矩阵必须显式计算,这意味着核函数应用于所有数据点对。这为更大的数据集创建了一个耗时的步骤。
相反,QSVM 可以使用量子算法并行计算内核矩阵,并且它是使用量子电路隐式计算的。这些步骤之间的这种差异允许更快和更节省内存的过程。
限制
但是,与此解决方案相关的局限性不容忽视,因为距离部署到常规使用还有很长的时间。
退相干是头号风险。量子计算机容易受到噪声的影响,这意味着量子比特由于其外部环境经常会干扰和扰乱现有的量子态而对计算敏感。这对于疾病预测等任务来说会有问题,因为您需要人类可以盲目信任的准确结果。
除了退相干性之外,QSVM 还需要大量的量子比特,而且由于我们知道它们很敏感,所以拥有更多的量子比特在产生准确结果方面并不是决定性的,这将很难管理。当今可用的当前量子计算机可能难以实现量子位之间的连接。
长期影响
但是,随着量子计算机的不断发展,所有这些限制都在得到解决。当我们在构建量子计算机时达到不存在量子比特数和噪声等问题的地步时,利用 QSVM 预测早期心脏病的长期影响可能会非常显着。
我们已经确定,心脏病的早期检测和准确诊断有助于预防“沉默的杀手”和相关的严重健康并发症。
通过完全开发的 QSVM,早期干预最终可以挽救生命——帮助减少现状(全球 1790 万人),这样我们就不会看到我们周围的人死于无声杀手。
