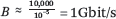量子计算机的运行原理与传统计算机截然不同,它有望解决各种在经典计算机上似乎永远难以解决的重要问题。利用自然界的量子基础,与经典计算机相比,在量子计算机上解决某些问题的时间随着问题的规模增长得更慢,这被称为量子加速。超越量子霸权(证明量子计算机在人工问题上优于经典计算机),一个重要的问题是找到有意义的应用程序(学术或商业利益),这些应用程序可以在量子计算机上比在经典计算机上更快地解决。我们称之为实用的量子优势,或者简称为量子实用性。
有许多难题被认为可以从量子加速中获益:从密码分析、化学和材料科学,到优化、大数据、机器学习、数据库搜索、药物设计和蛋白质折叠、流体动力学和天气预报。但是,在实践中,这些应用中哪些真正提供了潜在的量子优势呢?为此,我们不能仅依靠渐近加速,还必须考虑所涉及的常数。我们对量子计算机的前景持乐观态度,我们确定了量子实用性的明确指导方针,并用它们来分类量子计算的许多拟议应用中哪些有希望,哪些需要重大的算法改进才能变得实用和相关。
为了建立可靠的指导方针,或者为量子计算机所需的加速设定下限,我们对量子计算过于乐观,而对经典计算过于悲观。尽管我们的假设过于乐观,但我们的分析表明,如果没有显著的算法改进,广泛的经常被引用的应用不太可能产生实际的量子优势。我们比较了NVIDIA A100 GPU中使用的单个经典芯片的性能,该芯片可容纳约540亿个晶体管,并对未来几十年可能可用的假设量子计算机进行了乐观的假设,该假设具有10,000个纠错逻辑量子位,逻辑运算的10μs门时间,同时在所有量子位上执行门操作的能力以及容错双量子位门的全对全连接。
I / O带宽。我们首先考虑了限制量子计算机与经典世界交互的基本I/O瓶颈,它决定了数据输入和输出带宽的界限。量子随机存取存储器(QRAM)的可扩展实现需要容错纠错实现,而带宽则从根本上受到单位时间内可以执行的量子门操作或测量的数量的限制。我们假设每个输入位只有一个门操作。对于我们乐观的未来量子计算机来说,由此产生的速率比现有的经典芯片小10000倍(见表1)。我们立即看到,任何受限于访问经典数据的问题,如数据库中的搜索问题,都将由经典计算机更快地解决。类似地,在线性代数问题中,当必须从经典数据中加载矩阵或读取完整的解向量时,潜在的指数量子加速消失。一般来说,量子计算机将适用于小数据上的“大计算”问题,而不是大数据问题。
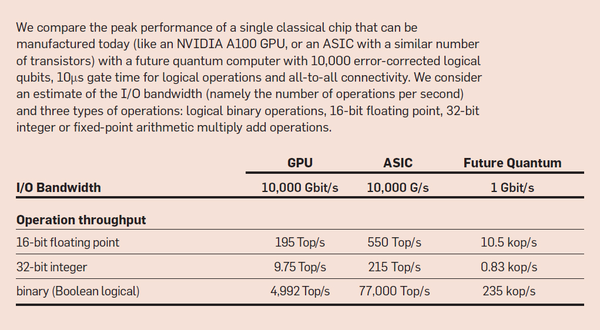
表 1. 性能比较。
交叉规模。随着量子加速,在量子计算机上所需的操作将逐渐少于经典计算机。然而,由于量子计算机的高复杂度和较慢的门操作,量子计算机上的每个操作都会比对应的经典操作慢。正如附图所示,经典计算机在处理小问题时总是更快,量子优势超越了依赖于问题的交叉规模,其中量子加速带来的增益克服了量子计算机的不断减速。要产生真正的实际影响,交叉时间必须很短,不超过数周。与计算中的任何运行时间估计一样,常量在确定应用程序的效用方面很重要。
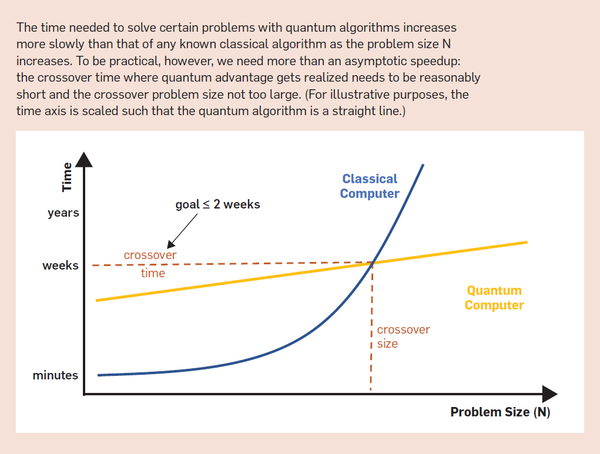
图:量子加速。
计算性能。为了模拟性能,本文采用经典并行计算中的工作深度模型来确定经典硅基计算的上界,并对量子计算进行扩展。在该模型中,所做的工作是操作的总数,适用于经典执行和量子执行。在表1中,我们提供了使用三种类型的操作的具体例子:逻辑操作、16位浮点和32位整数或用于数值建模的定点算术操作。对于量子成本,我们只考虑在我们的估计中最昂贵的部分,再次惠及量子计算机;对于算术运算,我们只计算乘法的主要开销,假设加法是免费的。此外,对于浮点数乘法,我们只考虑尾数乘法的开销(fp16中为10位)。忽略了量子算法由于可逆计算而产生的所有进一步开销,以及映射到具有有限量子比特连通性的特定硬件架构的显著成本。
经典计算和量子计算的交叉时间。为了估计交叉时间的下限,我们认为虽然经典计算机和量子计算机都必须评估描述问题的相同函数(通常称为 oracles),但由于量子加速,量子计算机需要更少的评估。许多量子加速提议的根源在于二次量子加速,包括著名的Grover 算法。对于这样的算法,在量子计算机上需要X次函数调用的问题需要二次调用,即在经典计算机上需要X2X^2 次调用。为了克服量子计算机和经典计算机之间巨大的恒定性能差异(表1显示的差异超过101010^{10} 倍),许多函数调用X≫1010X\gg10^{10} ;量子加速需要101010^{10} 才能提供实际优势。在表2中,我们估计函数复杂性的上限,这将导致10610^6 秒的交叉时间,或大约两周。
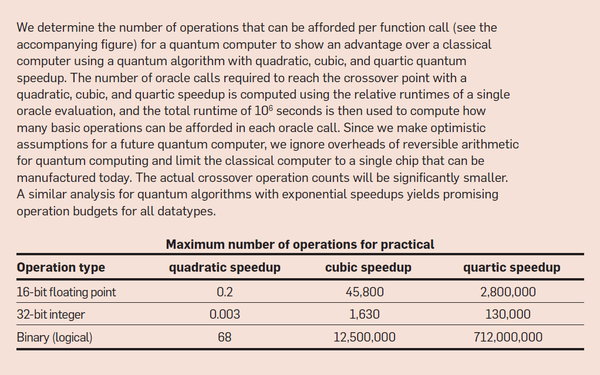
表 2. 具有二次、三次和四次加速的量子算法的交叉操作计数。
我们看到,使用二次加速,即使是单个浮点或整数操作也会导致几个月的交叉时间。此外,在我们期望的两周的交叉时间内,最多可以提供68个二进制逻辑运算,这对于任何重要的应用程序来说都太低了。请记住,这些估计对于经典计算(当今的单个经典芯片)是悲观的,而对于量子计算(仅考虑尾数的乘法并假设所有到所有的量子比特连接)过于乐观,我们得出明确的结论,二次加速不足以实现实际的量子优势。在数千或数百万个操作可能可行的情况下,三次或四次加速的数字看起来更好,我们得出的结论与Babbush等人类似,至少需要三次或四次加速才能获得实际的量子优势。
由于我们对量子计算过于乐观的假设,即使量子技术取得多个数量级的重大进步,这些结论仍然有效。
实用和不实用的应用。我们现在可以利用这些考虑来讨论几类应用,在这些应用中,我们的基本边界划出了量子实用性的界限。最可能实现实际量子优势的问题是那些具有指数级量子加速的问题。这包括模拟量子系统的化学问题,材料科学和量子物理,以及使用Shor算法的密码分析。高度结构化问题的线性方程组的解也有指数级的加速,但如果矩阵必须从内存中加载,而不是根据有限的数据或完整解的知识计算(而不是通过对解进行采样获得一些有限的信息),则上面讨论的I/O限制将限制其实用性,并抵消这一优势。
同样重要的是,我们在应用程序的迷宫中识别出可能的死胡同。大量具有二次量子加速的问题领域,例如许多当前的机器学习训练方法,使用 Grover 算法加速药物设计和蛋白质折叠,通过量子行走加速 Monte Carlo 模拟,以及更传统的科学计算模拟,包括解决方案许多非线性方程系统,例如湍流状态下的流体动力学、天气和气候模拟,在可预见的未来将无法通过当前的量子算法实现量子优势。我们还得出结论,已识别的 I/O 限制限制了量子计算在大数据问题、非结构化线性系统和基于Grover算法的数据库搜索的性能,因此在这些情况下不太可能获得加速。此外,Aaronson等人指出,非结构化黑盒算法的量子加速比限制在O(N4)O(N^4) 以内。这意味着任何实现更高加速比的算法都必须利用其所解决问题的结构。
这些考虑有助于在寻找量子应用时将炒作与实用性区分开来,并可以指导算法的开发。具体来说,我们的分析表明,社区有必要关注超二次加速,理想情况下是指数加速,并且在推导算法以最好地利用量子计算时需要仔细考虑 I/O 瓶颈。因此,量子实用性最有希望的候选者是具有指数加速的小数据问题。这种情况的具体例子是化学和材料科学中的量子问题,我们认为这是最有前途的应用。我们建议使用精确的需求模型在我们的粗略指南表明潜在的实用量子优势的情况下,获得更可靠和现实(不太乐观)的估计。
研究方法
在这里,我们提供了有关如何获得前面提到的数字的更多详细信息。我们将我们的量子计算机与单个微处理器芯片(如 NVIDIA A100 GPU 中使用的芯片)进行比较。A100 芯片的尺寸约为 850mm2850mm^2 ,采用台积电的 7 纳米 N7 硅工艺制造。A100 表明,这样的芯片可以容纳大约 542 亿个晶体管,并且可以以大约 0.7ns 的周期时间运行。
确定峰值操作吞吐量。在表1中,我们提供了使用三种类型运算的具体示例:用于数值建模的逻辑运算、16 位浮点数和 32 位整数算术运算。其他数据类型也可以使用我们的方法建模。
经典的 NVIDIA A100。根据其数据表,NVIDIA 的 A100 GPU 是一种 SIMT 风格的冯诺依曼加载存储架构,通过张量核心提供每秒 312 万亿次操作 (Top/s) 和半精度浮点 (fp16),通过正常处理提供 78Top/s管道。NVIDIA 假设加法和乘法运算的比例为 50/50,因此我们将数字除以二,得到 195Top/s fp16 性能。数据表指出 32 位整数运算为 19.5Top/s,再次假设加法和乘法的 50/50 混合,导致有效的 9.75Top/s。在有限的指令集下,二进制张量的核心性能为4,992Top/s。
经典专用 ASIC。我们的主要分析假设我们使用类似技术构建专用 ASIC。如果我们要用专用电路填充 A100 的等效芯片空间,我们将使用现有的执行单元,其大小通常以等效门 (GE) 来衡量。一个具有加法和乘法功能的 16 位浮点单元 (FPU) 大约需要 7kGE,一个 32 位整数单元需要 18kGE,我们假设 50GE 用于简单的二进制运算。所有单元都包含操作数缓冲寄存器并支持一组可编程指令。我们注意到简单的加法或乘法电路会便宜得多。如果我们假设晶体管与栅极的比率为 10 13并且总芯片面积的 50% 用于具有所需缓冲的数据流 ASIC 的控制逻辑,我们可以容纳 54.2 B /(7 k • 10 • 2) = 387 k fp16 单元。同样,我们可以在我们假设的芯片上安装 54.2 B (18 k • 10 • 2) = 151 k int32,或 54.2 B /(50 • 10 • 2) = 54.2M bin2 单元。假设循环时间为 0.7ns,对于具有 A100 技术和预算的专用 ASIC,这将导致总运行率为 0.55 fp16、0.22 int32 和 77.4 bin Pop/s。因此,ASIC 可使可编程电路的原始加速提高约 2 倍至 15 倍。因此,在经典的硅上,二进制、int32和fp16类型的性能范围大约在1013和1016 op/s之间。
分析表明,如果没有显著的算法改进,大量经常被引用的应用不太可能产生实际的量子优势。
假设的未来量子计算机。为了确定量子计算机上N位乘法的成本,我们从 Gidney中选择受控加法器,并使用N个单位位受控加法器实现乘法,每个加法器需要 2 NCCZ 魔法状态。这些状态是在物理芯片上实现的所谓“魔法状态工厂”中产生的。虽然生成的乘法器完全是顺序的,但我们发现这种结构允许将更多的单元放置在一个芯片上,而不是低深度加法器和/或部分乘积的树状减少,因为 CCZ 状态的数量较少(因此需要更少的魔法状态工厂),并且工作量子位的数量更少。生成的乘法器具有 CCZ 深度和 2 N 2的计数,使用 5 N – 1 个量子位(2 N输入,2 N – 1 输出,N辅助用于加法)。
为了计算由CCZ工厂引起的空间开销,我们首先使用Gidney和Fowler的分析来计算每个工厂的物理量子比特数,当目标电路(程序)使用≈108的CCZ魔法态,物理门误差为10−310^{-3} 时。我们通过将物理空间开销除以2d22d^2 来近似逻辑量子比特方面的开销,其中我们选择纠错码距离d=2⋅312d=2\cdot31^2 与用于第二级蒸馏的距离相同因此,我们将Gidney和Fowler的每个工厂的147,904个物理量子比特(详细信息请参考Gidney和Fowler的辅助电子表格(字段B40))除以2d2=2⋅3122d^2=2\cdot31^2 ,得到每个工厂77个逻辑量子比特的等效空间。
对于fp16浮点数的10位尾数的乘法器,我们需要2⋅102=200CCZ2\cdot10^2=200CCZ 状态和5⋅10=505\cdot10=50 量子比特。由于每个工厂需要5.5个周期,我们可以对CCZ状态的生产进行流水线,我们假设每个乘法单位有5.5个工厂,这样乘数平均不会等待magic state的生产。因此,每个乘法器需要200个周期,5N+5.5⋅77=50+5.5⋅77=473.55N+5.5\cdot77=50+5.5\cdot77=473.5 个量子比特。总共有10,000个逻辑量子比特,我们可以在我们假设的量子芯片上实现21个10位乘法器。在循环时间为10μs, 200周期的延迟下,得到最终速率小于105cycle/s/(200cycle/op)⋅21=10.5kop/s10^5cycle/s/(200cycle/op)\cdot21=10.5kop/s 10510^5。对于int32 (N=32),计算结果是等价的。对于二进制,我们假设不需要辅助的(二进制)加法器(Toffoli门)有两个输入和一个输出量子比特。结果总结在表1中。
关于并行性的说明。我们假设 oracle 在经典计算机和量子计算机上大规模并行执行(即深度为 1 的 oracle)。如果oracle不承认这种并行化,例如,如果depth = work在最坏情况下,那么比较将更有利于量子计算机。通过允许经典计算机每个周期只执行一个操作,可以对这种场景进行建模。在2GHz的时钟频率下,这意味着fp16在GPU上的速度会减慢约100,000倍。在这种极其不现实的算法最坏情况下,oracle仍然必须由仅数千个fp16操作组成,并具有二次加速比。然而,我们注意到,在实践中,大多数oracle的深度较低,跨单个芯片的并行化是可以实现的,这是我们假设的。
确定每个 oracle 调用的最大操作计数。在表2中,我们列出了可以在10610^6 秒(两周多一点)的运行时间内实现量子加速的某种类型的操作的最大数量。单个经典芯片在10610^6 秒内可以执行的经典操作的最大数量为:0.55 fp16, 0.22 int32和77.4 bin Zop。类似地,假设一个量子芯片的速率为表1中的7、4、2和350 Gop。
我们现在假设所有的计算都在量子计算机上的oracle调用中使用,我们忽略量子计算机上的所有其他成本。我们首先对算法进行建模,对于较小的常数k,可以提供多项式XkX^k 加速比。例如,对于Grover的算法,是k + 2。很明显,对于任何k>1k>1 ,量子计算机都是渐进快的(在oracle查询的数量上)。然而,我们感兴趣的是找到oracle复杂性(即评估它所需的操作数),对于这种复杂性,量子计算机在106秒的时间窗口内比经典计算机更快。
假设评估单个 oracle 调用所需的操作数为M,所需的调用数为N。它需要经典计算机时间Tc=Nk⋅M⋅tcTc=Nk\cdot M\cdot tc ,而量子计算机解决相同的问题时间Tq=Nk⋅M⋅tqTq=Nk\cdot M\cdot tq 其中t c和t q分别表示在经典计算机和量子计算机上评估操作的时间。通过要求量子计算机比经典计算机更快地解决问题,在10610^6 秒内,我们发现

这允许我们计算每个 oracle 评估的最大基本操作数,这样量子计算机仍然可以实现实际加速:
确定 I/O 带宽。我们使用 NVIDIA A100 数据表中指定的 I/O 带宽用于我们的经典芯片或量子计算机,我们假设每一位 I/O 需要一个量子门。使用所有 10,000 个量子位进行读/写,这会产生 I/O 带宽的估计值