摘要
提供免费书籍、音乐、游戏、电影等的免费内容网站已在网络上存在多年。 虽然人们普遍认为此类网站可能不同于提供相同内容类型的优质网站,但文献中缺乏支持这种观点的分析。 特别是,目前尚不清楚这些网站是否与高级网站一样安全。在本文中,我们着手通过分析和量化来调查免费内容和付费网站之间的异同,包括它们的风险状况。为进行此分析,我们汇集了一份包含 834 个提供书籍、游戏、电影、音乐和软件的免费内容网站以及 728 个提供相同类型内容的付费网站的列表。 然后,我们提供域、内容和风险级别分析,检查和对比网站的域名、创建时间、SSL 证书、HTTP 请求、页面大小、平均加载时间和内容类型。 对于风险分析,我们在网站和组件级别考虑并检查这些网站的恶意性。 在其他有趣的发现中,我们表明免费内容网站往往广泛分布在 TLD 中,并且表现出更多动态,新注册域呈上升趋势。 此外,免费内容网站使用过期证书的可能性高 4.5 倍,在网站级别恶意的可能性高 19 倍,在组件级别恶意的可能性高 2.64 倍。 受到两种类型网站之间明显差异的鼓舞,我们探索了免费内容风险网站的风险建模的自动化和泛化,表明一种简单的基于机器学习的技术可以产生 86.81% 的识别准确率。
关键词:免费内容网站; 网络安全; 网络挖掘
1. 简介
网站根据其货币化选项分为两大类:免费内容和付费网站。 免费内容网站免费提供内容,通常靠广告收入和用户捐赠 [1, 2, 3, 4] 维持生计,而付费网站则通过收费提供服务,例如订阅或按使用付费 模型[5]。 优质网站确保了非常高水平的服务质量,这是由于精心设计的网站通过专门的工程和运营工作得到良好维护 [6]。 相比之下,免费内容网站被认为对服务质量缺乏如此高的期望,并且通常是用户驱动的 [7]。
对功能和安全质量、用户驱动的内容以及第三方广告在免费内容平台上的广泛利用带来了各种风险 [8、9、10、11]。 例如,可以利用这些网站上的广告来泄露数据和信息,甚至可以在用户设备上分发和执行恶意脚本 [12、13]。此外,免费内容网站缺乏严格的维护操作规则会带来各种风险:免费内容网站中使用的 Web 框架很少更新,允许利用未修补的旧漏洞并使用户面临不同程度的风险 [14]。
然而,撇开未经检验的假设和广泛未经证实的信念不谈,免费内容网站是否与提供相同类型内容的付费网站不同? 免费内容网站与付费网站在结构、内容和安全性属性方面是否不同? 这些网站是否给用户带来了隐性成本,超过了明显的好处,即免费? 为了回答这些问题,我们对精心组装的数据集进行了系统分析,该数据集管理了 834 个免费内容网站和 728 个付费网站。 我们的研究结合了领域和内容级别的分析,以及跨各个维度的安全分析。 对于域级分析,我们检查域名系统功能、创建时间和 SSL(安全套接字层)功能作为意图的度量。 对于内容级分析,我们检查了 HTTP(超文本传输协议)请求、页面大小、加载时间和内容类型,所有这些都衡量网站的复杂性。 对于安全分析,我们使用两个主要的现成工具 VirusTotal API [15] 和 Sucuri API [16] 检查网站和组件级别的检测和漏洞。
我们的分析得出结论,免费内容和提供相同类型内容的优质网站之间存在显著、根本和内在的差异。在其他有趣的发现中,我们报告称,免费内容网站仅广泛分布在顶级域名(TLD)中,尽管使用了常见的二级域名(SLD)。此外,它们经常更改域,可能会被列入黑名单,并且更经常与无效的SSL证书相关联。就内容而言,免费内容网站往往需要更少的HTTP请求才能获得更小的请求页面大小,尽管由于广泛使用了更多脚本对象的重定向,因此需要大量的加载时间。从风险角度来看,我们发现免费内容网站在页面级别(38%对2%)和文件级别(45%对17%)的恶意可能性分别是优质网站的19倍和2.64倍。
我们利用这些分析中的见解,通过对免费内容网站的风险进行建模来概括和推断。为此,我们使用纯性能指标来定义风险。此外,我们能够以非常高的准确率(超过86%)对风险网站进行分组。
贡献和调查结果。本文从域名、内容和安全三个维度对相同内容类型的免费和优质网站进行了深入的比较分析。通过功能丰富的分析,我们构建了一种基于机器学习的方法,以高精度对免费内容网站的风险进行评分。在下文中,我们详细阐述了我们的贡献。
1.免费内容网站治理(§3)。我们列出了1500多个提供相同类型内容的免费内容和优质网站。这些网站是从谷歌、DuckDuckGo和必应搜索引擎的顶级搜索结果中获得的。然后对网站进行爬网以获取其内容,包括脚本、图像、HTML、CSS等。
2.域级分析(§4.1)。为了检查免费内容网站的域级功能,我们分析了三个方面:它们的TLD(顶级域)、SSL证书和创建日期。因此,我们发现免费内容网站的数量显著增加,而新建的优质网站则有所减少。此外,我们在免费内容网站中观察到的域名动态比在高级网站中更频繁。近三分之一的免费内容网站使用无效或不匹配的SSL证书运营。
3.内容级别分析(§4.2)。为了检查内容级别的功能,我们分析了三个方面:HTTP请求、页面大小和平均加载时间。在其他发现中,我们观察到优质网站包含的图片明显更多,其平均大小是免费内容网站大小的三倍。然而,有趣的是,我们发现,由于各种固有的设计选择,加载时间似乎是可比的,包括使用脚本和重定向来传递广告,这在免费内容网站中更为普遍。
4.免费内容网站风险分析(§5.1)。我们利用两种流行的现成工具VirusTotal和Sucuri来评估与免费内容网站相关的安全风险。我们的分析表明,免费内容网站比优质网站更容易与恶意4联系在一起。然而,发现被检测为恶意的高级网站非常有趣,需要进一步探索。
5.风险建模(§5.2)。性能和安全指标分析都突出了免费内容和优质网站之间的显著差异。此外,他们的风险状况也大不相同。受其特征差异的启发,我们构建了一个简单的机器学习算法,该算法利用易于获得的领域和内容级别的特征来预测网站的风险。我们报告了对免费内容网站风险建模的86.81%的准确率。
2.相关工作
本文中与我们的贡献最相关的工作分为两大分支:网站分析和恶意网络内容分析。在下文中,我们概述了两个方向上的一些努力。
2.1网站分析
网站在内容和使用方面不断发展,同时其组成部分的复杂性和丰富性也在增加。然而,随着这种演变,由于这些组件之间的相互作用,出现了各种安全风险[17,18,19,20]。文献中尚未探索的安全方面之一是网站证书的有效性[21]。为了解决这个问题,Chung等人[21]提出了对web PKI(公钥基础设施)中证书的深入分析,表明web PKI中的绝大多数证书都是无效的。他们的研究还调查了无效证书的来源,得出的结论是,这些证书主要由最终用户设备生成,并定期重新生成新的自签名证书。
Libert等人[22]评估了一百万个流行网站采用的侵犯隐私的做法,例如数据泄露。他们得出的结论是,大约十分之九的网站在未经用户同意的情况下与第三方服务共享用户数据。使用类似的数据集,Lavrovs等人[23]对Alexa排名前百万的网站的安全性进行了全面的评估,结果显示29.1%的HTTPS请求具有不正确的TLS(传输层安全)配置,而HTTP严格传输安全(HSTS)策略仅在17.5%的网站中实施。这些发现令人担忧,并表明这些热门网站所遵循的安全政策令人担忧。
Alsmadi等人在探索评估web应用程序安全缺陷的环境时,[24]为各种无效输入设计了一种基于组件的测试机制,并使用该机制来调查网站因此类输入而产生的行为,包括安全性。由于无效输入是攻击面的一致部分,因此通过消除这些输入(即拒绝无效输入)来加强在线服务和web应用程序的安全性。为此,他们提出了几种检测无效输入的方法,发现了许多SQL注入漏洞。
2.2.恶意网络内容
最近的研究表明,对手能够在网站的JavaScript、GIF或Redisection组件中嵌入恶意代码[25,26,27,28,29]。最终用户的安全在很大程度上取决于检测和防止此类恶意内容,这一点也得到了研究。为此,研究人员利用了网络应用程序的各种功能,包括URL(统一资源定位器)域组件、网页内容、HTTP标头和加载的脚本,并使用它们来检测恶意网络应用程序[30,31]。还表明,一个有前途的特征集是HTTP标头信息[22],其中McGahagan等人[32]利用其中672个特征构建了一个恶意网站检测系统。为了检验使用组件和内容(即文件和脚本)作为检测特征的可行性,作者对不同的网页内容特征进行了全面评估。这17个经过设计的新功能可以提高恶意网站的检测性能。
网站的一个关键但尚未探索的方面是部署在网站上的广告与其相关的恶意之间的相互作用。李等人[33]调查了各种恶意在线广告和营销方法,例如恶意软件传播[34,35,36,37,38]、点击欺诈等。他们的研究使用了与广告相关的网络痕迹的大规模数据集,显示了数百个排名靠前的网站中的恶意广告行为。为了检查恶意广告检测的有效性,Masri等人[39]评估了三种工具,VirusTotal、URLoid和TrendMicro,表明URLoid提供了最佳性能。
另一个已被探讨的突出威胁是在免费下载门户网站上分发恶意内容[40]。这样的门户可能被恶意用来向最终用户设备分发有害软件。Rivera等人[41]对使用免费下载门户获得的PUP(潜在不需要的程序)和恶意软件进行了系统分析,结果表明,平均8%至26%的下载内容是PUP或恶意的。
机器学习算法也被广泛用于有效检测恶意网站[42]。然而,它们受到两个关键挑战的影响,即特征选择和规避。为了解决特征选择问题,Singh和Goyal在他们的分析中主张将特征选择与开销性能和准确性相结合[43]。另一个问题是,逃避检测通常与固有特征有关,包括重定向和隐藏iFrame的使用。在该领域,Liu和Lee[44]提出了一种基于网页截图的有效卷积神经网络恶意内容检测方法。
这项工作。在这项工作中,我们探索并评估了免费内容网站与优质网站的恶意。我们的研究结果显示,免费内容网站中恶意内容的比例呈令人担忧的增长趋势。为了积极解决这一问题,我们通过易于获取的性能特征对与这些网站相关的风险进行了建模,并根据基本事实确定了高达86.81%的风险网站。
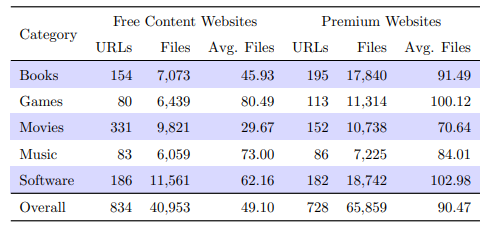
表1:收集的数据集概述。收集的URL与五个不同的类别相关联,属于免费内容和高级网站。总的来说,为了本研究的目的,共有1562个网站被抓取。
3.数据集概述
在下文中,我们强调了创建数据集时所遵循的方法,包括初始选择和相关标准、手动注释、爬网和扩充。
网站选择。我们编制了一份1562个免费内容和优质网站的列表,用于进行我们的测量。在选择网站时,各种约束条件进行表示。特别是,以下标准用于选择我们的网站:
(1)受欢迎程度:每个网站都必须是网络上最受欢迎的网站之一。考虑到这些网站可能不一定是最受欢迎的网站,我们使用搜索引擎的结果来估计它们的受欢迎程度。如果一个网站出现在至少一个常用搜索引擎(谷歌、DuckDuckGo和必应)的搜索结果中,那么它就被认为是受欢迎的。
(2) 平衡表示:在组成我们的整体数据集时,我们确保我们的数据集按类别平衡。为此,我们扩展了我们的查询,直到我们在免费和优质网站的类别之间实现接近平衡的表示。
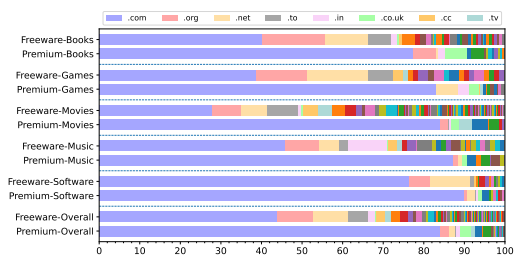
图1:免费与优质网站的TLD分布。与优质网站相比,免费内容网站更多地分布在顶级域名中。
在最初选择独特的网站纳入我们的数据集后,我们通过手动检查并标记每个网站为优质或免费内容网站。然后,根据网站主要提供的内容类型,每个网站也被手动分类为五组之一:书籍、游戏、电影、音乐或软件。
网站爬网。为了了解免费内容网站的相关风险,我们使用PyWebCopy[45]对每个网站的内容(即文件)进行了爬网,PyWebCopy是一个用于克隆网站并下载其相关文件的python包。
获得的文件随后用于风险分析和建模,因为它们反映了所提供服务的行为。然后,我们的数据集增加了分类为两大类的各种属性,即域级属性(TLD、域创建信息、SSL证书信息)和内容级属性(HTTP请求信息、页面大小、加载时间和内容类型)。
高级特性。表1显示了收集的数据集的分布情况。请注意,从高级网站抓取的平均文件明显大于免费内容网站的平均文件。
4. 网站分析
为了了解免费内容和付费网站之间的根本区别,我们进行了两种类型的分析:域级分析和内容级分析。 域是网站的门户,它们包含丰富的信息,可用于了解其意图。 用内容级特征补充域级特征可以提高对网站意图的可见性。 在下文中,我们提供了基于这两个功能组的分析结果。
4.1. 域级分析
域级分析为我们提供了一个高层次和有趣的视图,并将网站理解为跨越所有者信息、创建日期和使用的 TLD 的基础设施。 我们进行此类分析以对比免费和付费网站的相关域。
顶级域分析。TLD是分级域名系统中最高级别的域名,其次是SLD(二级域名); 在 example.com 中,example 是 SLD,而 com 是 TLD。 最近,随着新通用 TLD (gTLD) 的引入,TLD 的数量显着增加,尽管“.com”、“.net”、“.org”和“.edu”仍然是最突出的 [46]。 在这项工作中,我们调查了 TLD 中免费内容和付费网站的分布情况,如图 1 所示。
我们发现“.com”是最突出的 TLD 域,分别有 44% 和 84% 的免费内容和付费网站使用“.com”。 然而,有趣的是,我们发现我们数据集中付费网站使用的唯一 TLD 总数仅为 24 个,而免费内容网站中这个数字是 98 个域。 我们注意到,这种广泛分布可能是由主要浏览器和系统实施的恶意网站拦截机制触发的。 例如,Chrome 和 Firefox 在使用安全浏览服务 [47] 时依赖用户报告来收集和阻止恶意网站。 为了逃避封锁,免费内容网站改变了他们的域名定期命名。 然而,免费内容运营商维护相同的 SLD 并将其网站迁移到其他 TLD 以保留现有用户,其中一些运营商更改其 TLD 以逃避封锁。
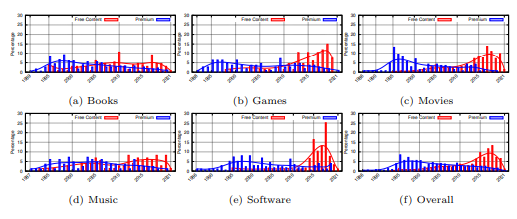
图 2:免费网站和付费网站之间的域名创建年份比较。 通过比较各种内容类型的趋势,我们观察到与付费网站相比,免费内容域创建的显着上升趋势。
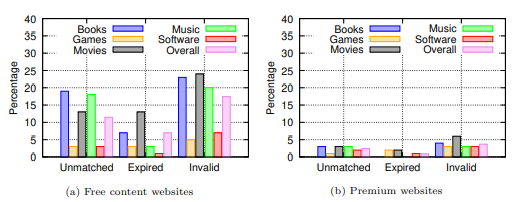
图 3:SSL 证书分析结果。 我们观察到,将近 36% 的免费内容网站的 SSL 证书存在问题,而付费网站中这一比例为 7%。
域名创建。 我们检查了网站创建日期,我们观察到新创建的免费内容网站数量呈上升趋势,而新创建的付费网站数量却在下降,如图 2 所示。这种增长趋势,尤其是在 2015-2021 年,促使我们审视和了解与使用在线免费内容网站相关的风险。 为了进一步支持这一点,我们从 TLD 分析中发现免费内容网站往往会定期更改其域名,以避免内容被阻止或列入黑名单。
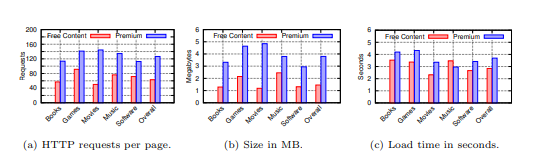
图 4:免费内容和付费网站之间的页面相关比较(平均统计数据)。 尽管页面大小不同,但免费内容和付费网站的平均页面加载时间相当,这表明影响时间的除了大小之外还有其他原因。
SSL 证书分析。 HTTP 将网站内容(例如 HTML)从 Web 服务器传输到用户浏览器。 但是,此协议并不安全,传输的数据可能会暴露给未经授权的访问。 因此,大多数网站已转向使用安全版本的 HTTP (HTTPS),它实施加密机制来保护传输的内容。 我们的分析发现,36% 的免费内容网站的 HTTPS 无效,而付费网站只有 7%。 此外,我们发现 26% 的免费内容网站仍然允许 HTTP(不安全)访问,而 0% 的付费网站允许 HTTP 访问。 SSL 证书是一种数字身份验证方法,可验证网站的身份并为 HTTPS 提供服务器和客户端计算机之间的加密连接。 SSL 证书是网站的重要组成部分,用于保护用户数据并保护他们免受网络钓鱼等攻击。
在这项工作中,我们调查了免费内容和付费网站的 SSL 证书的有效性。 具体而言,我们研究了三个方面:(i) 证书中不匹配的主机名,(ii) 过期的证书,以及 (iii) 无效/伪造的证书。 图 3 显示,总共有 36% 的免费内容网站的证书存在问题(即 11.5% 的名称不匹配、7% 的过期和 17.5% 的证书无效),而总数只有 7% 的免费内容网站相关 SSL 证书存在问题的高级网站。 这在“电影”、“书籍”和“音乐”类别中更为明显。 如图所示,免费内容网站更有可能存在 SSL 证书问题。这可能是因为免费内容运营商不更新 SSL 证书,不愿增加运营成本。 尽管如此,这种做法会导致有关用户信息和数据隐私的潜在风险。
要点:通过领域层面的分析,我们发现(i)免费内容网站较新,并且近年来增长显着,而优质网站的增长正在下降,每年推出的网站较少,(ii ) 免费内容网站在 TLD 中分布更多,因为它们更改域以避免恶意网站阻止机制,(iii) 免费内容网站更有可能拥有无效或过期的 SSL 证书。 这些发现补充了我们关于使用免费内容网站的安全性以及与之相关的风险的分析。
4.2. 内容级分析
为了深入了解免费内容和付费网站的内容级特征,我们分析了两种类型网站中提取的文件。 在此分析中,我们关注四个特征:HTTP 请求数、页面大小、页面加载时间和内容类型。
HTTP 请求。 客户端发出 HTTP 请求以请求访问服务器上的资源(例如 HTML 文件、CSS、图像),它们每页的数量表示所请求页面的复杂性。 图 4a 显示了对免费内容和付费网站发出的平均 HTTP 请求数。 我们观察到,与访问免费内容网站相比,客户会发起几乎两倍于访问优质网站的请求。 鉴于高级网站页面的尺寸更大,这是完全可以预料的。 然而,我们观察到付费网站的平均页面大小是免费内容网站的 3 倍,而 HTTP 请求的数量仅多出 2 倍,这表明访问免费内容页面需要更多的 HTTP 请求来获取相同的数据量。 这可能是重定向的结果,其中每个重定向都会触发一个或多个独立的 HTTP 请求并消耗更多时间进行加载,如后文所示。
平均页面大小。 根据 HTTP Archive [48] 的页面权重报告,排名前一百万的网站的平均页面大小约为 2.07 MB。 属于任一类别的平均页面大小有多大? 为了回答这个问题,我们检查了免费内容和付费网站的平均页面大小,结果如图 4b 所示。 我们观察到免费内容网站遵循 HTTP Achieve [48] 报告的页面大小的正态分布,而付费网站的平均主页大小为 3.9MB,是免费内容页面平均大小的三倍。 一个可能的解释可能是免费内容网站依赖于将用户重定向到其他网站的内容或广告网站,而不是在免费内容页面主体中包含和呈现内容,正如我们稍后演示的那样。
平均页面加载时间。 我们将页面加载时间定义为页面完全加载和测量以了解网站复杂性的其他方面所花费的时间。 图 4c 显示了使用 SolarWinds Pingdom API(应用程序编程接口)[49] 计算的免费内容和收费网站的平均页面加载时间。 虽然付费网站的平均大小是免费内容页面平均大小的三倍,但我们注意到平均加载时间在它们之间具有可比性,表明影响加载时间的因素超出了大小,即性能下降和重定向的广泛使用。
内容类型。 页面大小似乎并不能完全解释网站的复杂性和加载时间,这需要对网站的内容进行更深入的分析。 内容类型是网站内容在组件级别(即文件)的另一个统计特征。 这些组件包括图像(GIF、PNG、JPEG)、JavaScript、文本、HTML、CSS、XHR 和重定向。我们发现图像是最常见的组件,其次是 JavaScript,而重定向内容是这些组件中最不常见的。图 5 显示了免费内容和付费网站中不同组件的平均分布 (%)。 总体而言,优质网站的图片比免费内容网站多 15%。 然而,我们注意到重定向在免费内容网站中的广泛使用,因为它通常是一种投放广告和误导过滤算法的方法。 我们发现,与收费页面相比,免费内容的重定向(四舍五入)比率为 6(软件)、7(音乐)、3(电影)、1(游戏)、1(书籍)。 总的来说,免费内容网站的重定向次数是付费网站的两倍,并且有两倍的 HTML、1.5 倍的 CSS 和 1.23 倍的 JavaScript。
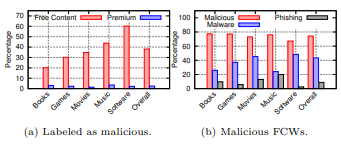
图 6:免费内容和收费网站的潜在恶意
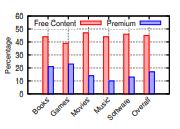
图 7:VirusTotal 检测到的恶意文件:免费内容与付费内容。
要点:我们的内容级别分析揭示了免费内容和付费网站之间的主要区别。 我们发现了以下内容。 (i) 优质网站的请求数量几乎是免费内容网站的两倍,平均页面大小是免费内容网站的三倍。 (ii) 尽管如此,免费内容和付费网站的平均主页加载时间相当。 (iii) 内容类型方面,免费内容网站具有更高比例的重定向组件,因为它们是投放广告的主要方法。
5. 恶意分析
到目前为止,我们进行的分析考虑了免费内容和付费网站的性能和非安全特征,这突出了导致直接和间接成本的明显差异。 衡量免费内容网站成本的最重要和最明显的指标之一是了解其安全性和相关风险。 在本节中,我们将进行此分析,重点关注威胁指标,例如 URL、文件和相关漏洞的恶意性 (§5.1)。 为了自动发现此类风险,我们还报告了基于机器学习的工具的结果,该工具根据从风险分析 (§5.2) 获得的特征显示网站的风险边界。
5.1. 风险评估 研究这两个服务网站的恶意性和漏洞,避免检查它们如何潜在地影响用户体验、安全和保障,这一点很重要。 受此启发,我们使用多个指标来定义网站的风险,即:(i) 包含恶意软件,(ii) 运行恶意脚本,(iii) 利用用户设备的资源,或 (iv) 包含漏洞、过时的软件版本,或 未打补丁的框架。
为了在不重新发明轮子的情况下评估每种类型网站的风险,我们利用两个公共 API:VirusTotal [15] 和 Sucuri [16] 进行有害行为分析。 VirusTotal 是一项在线服务,聚合了 70 多个扫描引擎的扫描结果,可用于扫描文件和 URL 等。 另一方面,Sucuri 是一项针对多种已知恶意软件、病毒、黑名单、漏洞、过时框架和恶意代码测试网站的服务。
恶意 URL 检测和注释。 使用 VirusTotal API,我们提取了与网站 URL 相关的恶意活动,如图 6 所示。我们注意到免费内容和付费网站之间在恶意方面存在明显差异。 特别是,图 6a 显示 38% 的免费内容网站被 VirusTotal 认为是恶意的,而只有 2% 的付费网站被认为是恶意的。 这些检测到的网站中有相当数量 (≈74%) 被标记为恶意网站(图 6b),这是一个旨在促进诈骗、攻击和欺诈的网站。 我们还注意到,很大一部分免费内容 URL 被检测为恶意,从 20%(“图书”网站)到 60%(“软件”网站)不等。 相比之下,优质网站的检测率非常低,只有 1% 到 4%。
恶意文件检测和格式分析。 为了了解给定服务(即内容提供者)的行为,必须分析服务托管的可执行脚本的行为特征。这些脚本作为文件转发给最终用户,包括图像、JavaScript 代码、HTML 等格式,并且通常在用户的设备。 分析脚本和网站文件至关重要,因为最近的研究 [50、51、52、53] 表明,除了滥用最终用户设备的资源外,还可以利用此类内容,导致信息和数据泄露。 为了了解免费内容网站的风险,我们利用 VirusTotal API 进行恶意文件识别。 相比之下,图 7 显示了 VirusTotal API 在免费内容和收费网站中检测到的恶意文件的百分比。 虽然与高级网站相关并被标记为恶意的 URL 数量仅为 2%,但其被标记为恶意的文件数量为 17%。
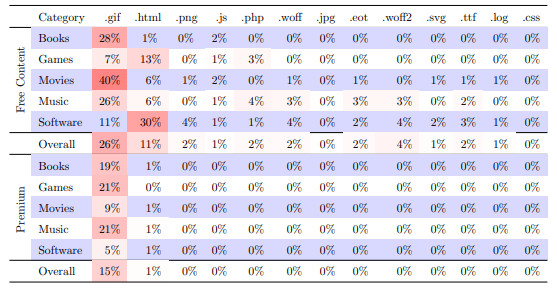
表 2:免费内容和付费网站中不同文件格式的恶意文件分布。 我们观察到,在这两种情况下,很大一部分“.gif”文件都被标记为恶意,尽管免费内容几乎是恶意文件的两倍(百分比)。
我们注意到这一趋势总体上持续存在,尽管被放大了:45% 的免费内容网站的文件被标记为恶意(相比之下,付费网站的这一比例为 17%)。 为了更好地理解这一观察结果,我们调查了恶意文件格式的分布,比较结果如表 2 所示。
根据表 2,我们报告大多数恶意文件具有“.gif”和“.html”格式。 这是 (i) '.gif ' 和 '.html' 文件的结果包含恶意嵌入式脚本,或 (ii) VirusTotal 引擎通常将“.gif”文件视为恶意内容(即潜在的误报)。 值得注意的是,我们手动检查了“.gif”文件,发现大多数带有恶意标签的“.gif”文件都是与广告相关的内容。
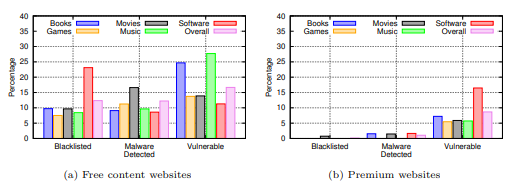
图 8:评估免费内容和付费网站的恶意性。 我们显示标记为黑名单、恶意软件和易受攻击的网站的百分比。
网站漏洞和黑名单。 为了分析潜在的可利用漏洞和黑名单,我们利用 Sucuri API [16] 获取两种类型服务的域活动信息。 结果,我们发现 12% 的免费内容网站被检测为包含恶意软件,而只有 1% 的付费内容网站被检测到,如图 8 所示。此外,我们发现免费“电影”网站的恶意软件检测百分比最高 (16.67%),如图 8a 所示。
我们还扫描了网站的漏洞,发现免费的“图书”和“音乐”网站总体上漏洞最多。 尽管付费网站的报告率较低,但仍有 17% 的“软件”被标记为易受攻击,这一比例高于免费内容网站 (12%),这非常令人惊讶。 据 Sucuri 报道,很大一部分合法“软件”网站漏洞是由于框架版本过时造成的,这在“软件”服务网站中很常见。
在黑名单方面,图 8a 显示 12% 的免费内容网站被 Sucuri 扫描引擎列入黑名单,包括 Google、McAfee、19 Yandex、Norton、ESET 和 AVAST 引擎。 我们观察到,“软件”免费内容网站的黑名单 URL 比例 (23.12%) 明显高于其他类别,其他类别的黑名单率最高为 12%。 这种行为的一个原因是这些网站经常使用不同的 TLD 更改其域名。
要点:为了评估与免费内容网站相关的风险,我们利用 VirusTotal 和 Sucuri API 来分析这两种服务类型的域和文件的恶意性。 我们的分析显示了免费内容网站中令人担忧的趋势,包括 (i) 免费内容网站更有可能与域级别的恶意相关联(38% 的免费内容网站),以及 (ii) 它们更有可能是 与文件级别的恶意相关(其中 45%)。 这些趋势不仅限于导致高黑名单的恶意行为,还包括可能使访问者遭受泄漏攻击的可利用漏洞。 我们的分析还表明,17% 的免费内容网站容易受到攻击。
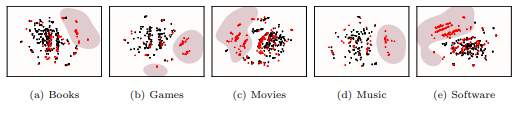
图 9:无风险和风险网站的决策边界。 有风险的网站是具有潜在恶意的网站。 请注意,可以使用支持向量机来表征(即确定)这种恶意行为。
5.2. 风险建模
到目前为止,我们提供的见解很有趣,尽管我们还有一个关键问题:这些见解中有多少可以推广到相同人群和类型的地点以进行风险评估? 为了回答这个问题,我们报告了我们使用简单的机器学习算法识别风险网站的努力。
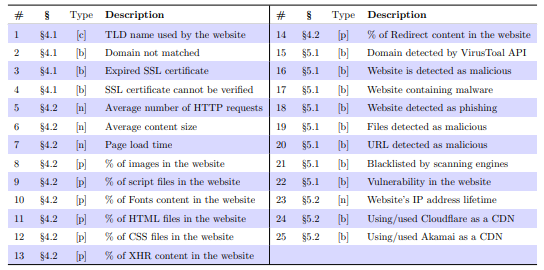
表 3:网站特征描述。 这些特征是从三个来源提取的,(i) 网站的内容,(ii) 网站的公开信息,(iii) 网站的 SSL 证书信息。 我们包括从 VirusTotal 和 Sucuri API 中提取的特征,用于风险表征和潜在检测 (D)。 org:特征的起源,[c]:分类特征,[b]:布尔特征(T/F),[n]:数值特征,[p]:百分比特征。
有风险的网站。 如果与以下任何一项相关联,我们分析中的网站将被视为有风险:
(1) 恶意域。 与负责恶意活动的 URL 相关联的网站被认为是有风险的 [54]。
(2) 恶意文件。 访问网站时,会在主机上执行多个脚本。 因此,我们将任何带有恶意文件 [55] 的网站,无论其 VirusTotal 标签如何,都视为有风险的网站。
(3) 列入黑名单的网址。 列入黑名单的原因可能是 (i) 大量用户报告,或 (ii) 网站之前的恶意行为(例如,诈骗攻击)。 因此,我们认为所有列入黑名单的网站都是有风险的 [54]。
(4) 易受攻击的网站。 由于潜在的可利用性,被 Sucuri 识别为易受攻击的网站被认为是有风险的。
我们注意到风险建模不仅限于免费内容网站。 我们还将具有上述方面中的一个或多个的任何免费内容和付费网站视为有风险的网站,否则为无风险网站。
网站功能。 为了对与每项服务相关的风险进行建模,并且在相关文献 [34、54、56、57] 中很常见,我们利用上述提取的特征作为表示。 特别是,表 3 显示了我们用来表示每个在线服务的潜在特征的超集,包括 SSL 证书、页面大小、加载时间、TLD 和网站内容特征。此外,我们还包括使用 SecurityTrails [58] 提取的另外三个功能:(i) 服务 IP 地址的生命周期,(ii) 网站是否正在使用或以前使用 Cloudflare 作为内容分发网络 (CDN),以及 (iii) 网站是否正在使用或以前使用 Akamai Tech 作为 CDN。
保留数据。 表 3 中 VirusTotal 和 Sucuri (#15–#25) 获得的数据被保留,仅用于模型验证。 这使我们能够利用不需要访问第三方信息的易于获取的网站质量指标来模拟网站风险。 我们设想,与第三方风险数据相比,我们的轻量级模型会更实用,因为第三方标签是根据一段时间内积累的报告和昂贵的分析来确定的。 仅依靠 VirusTotal 等第三方工具来识别风险将排除大量网站,包括那些新创建的免费内容网站。
风险边界。 考虑到上述特征,我们将风险网站和无风险网站之间的边界可视化,如图 9 所示。特别是,我们使用 t 分布随机邻域嵌入 (t-SNE) 可视化技术 [59] 来绘制 网站。 然后,我们使用支持向量机估计风险边界,如图 9 中的红色阴影区域所示。根据验证,我们发现风险最高的网站聚集在一起,因为它们共享不同的网站特征。 我们的模型能够以 86.81% 的准确率识别有风险的网站,尽管存在一些限制(例如,我们的样本网站中存在潜在的误报)。
要点:我们使用 17 种通用和文件相关功能的表示来满足对免费内容网站进行轻量级风险建模的需求。我们的建模被证明是有效的,产生了 86.81% 的准确率。
6. 结论和未来工作
免费内容网站是当今网络构成中一个有趣的元素,与提供相同内容的其他网站相比,它们的特征没有得到严格分析或理解。 本文首次对此类网站在不同领域和内容层面的维度及其风险状况进行了比较分析。 我们精选的数据集为探索这个未知领域提供了宝贵的资源,我们的发现揭示了免费内容网站与付费网站之间的根本区别。
我们认为,我们在本文中的分析只是对这一重要问题的“初步了解”,需要进一步的探索和行动。 例如,我们的领域和内容级别的分析只关注易于获取的元数据特征,而没有考虑深度特征,例如语言、网络拓扑信息、区域信息、深层内容类型和组织 属性(例如,在 SSL 证书的情况下;签名机构和托管基础设施)。 所有这些维度都可以更好地揭示此类网站的特征,并构成我们未来的工作。 最后,我们注意到我们的分析使用了这些网站的单个快照,而我们没有考虑它们特征的时间维度,这将是一个非常有趣但又具有挑战性的探索方面。
