摘要
高能物理学界正在研究在可编程门阵列(FPGAs)上部署基于机器学习的解决方案的可行性,以改善物理敏感度并满足数据处理延迟限制。在本文中,我们介绍了一种新颖的端到端过程,利用一种称为符号回归(SR)的机器学习技术。它在方程空间中搜索以发现近似数据集的代数关系。我们使用PySR(一种基于进化算法的软件,用于揭示这些表达式)并扩展了hls4ml的功能(一种用于在FPGA中进行机器学习推断的软件包),以支持PySR生成的表达式,用于资源受限的生产环境。深度学习模型通常通过固定网络大小来优化顶级指标,因为庞大的超参数空间阻碍了广泛的神经结构搜索。相反,SR选择一组在帕累托前沿上的模型,可以直接优化性能与资源之间的平衡。通过嵌入符号形式,我们的实现可以大大减少执行关键任务所需的计算资源。我们在物理基准测试上验证了我们的过程:在CERN大型强子对撞机模拟的质子-质子碰撞中产生的喷注的多类别分类,并且显示我们可以用一个推理模型近似一个具有仅5纳秒执行时间(减少了13倍)和超过90%的近似准确率的3层神经网络。
1 引言
符号回归(SR)是一种机器学习技术,旨在发现最适合数据集的数学表达式。SR的结果是一个分析方程,可以捕捉数据中的潜在模式和关系。由于这些方程是可解释的,SR可以提供有关自然科学的宝贵见解,包括高能物理学(HEP)。此外,通过允许在帕累托前沿上选择模型,SR能够优化性能与资源之间的平衡,使其成为其他机器学习方法的一个有希望的替代方案,特别是深度学习模型。在大型强子对撞机(LHC)实验中,这是一个关键的特性,该实验必须以40 MHz的速率处理质子-质子碰撞,并且每秒处理数十太字节的原始数据。这种极高的数据速率和当前缓冲系统的规模对于实时数据分类和边缘过滤(或触发系统)来说,约为1微秒。在这些条件下,需要在Field-Programmable Gate Arrays(FPGAs)等定制硬件上运行轻量级算法进行超低延迟推理。
在本论文中,我们扩展了hls4ml(高级合成用于机器学习)框架的功能,提供了对SR选择的方程的解析能力,并支持数学函数的高级合成(HLS)。我们的实现在一个物理基准测试中进行了验证,展示了这种方法解决高能物理学界面临的挑战的有效性和潜力。为了生成这些表达式,我们选择使用PySR(符号回归的开源软件工具),它采用进化算法。PySR提供了SR的全面实现,基于Julia构建,但可以从Python进行接口调用,使其易于访问和在包括高能物理学在内的广泛领域的从业人员使用。本文的其余部分结构如下:第2节介绍数据集和基准模型。第3节介绍我们的实现和结果。最后,第4节总结了这项工作,并提出了未来的方向建议。
2 基准测试和基准模型
为了展示符号回归的应用,我们选择了高能物理学领域的喷注识别问题。喷注是指一束出射粒子的狭窄锥体,识别产生这些具有相邻轨迹的粒子集束的原始粒子的过程称为喷注标记。在LHC实验中,喷注对于许多物理数据分析至关重要。本案例研究的数据是从在LHC高能碰撞中产生的夸克和胶子的衰变和强子化产生的模拟喷注中生成的。任务是将给定的喷注标记为来自夸克(q)、胶子(g)、W玻色子(W)、Z玻色子(Z)或顶夸克(t)中的哪一种。该数据集可从Zenodo Pierini等人(2020)公开获取。为构建一组16个受物理启发的专家特征,我们实施了各种喷注重组算法和子结构工具,这些特征包括(∑zlogz, Cβ=0,1,2^1, Cβ=1,2^2, Dβ=1,2^2, D(α,β)=(1,1), (1,2)^2, Mβ=1,2^2, Nβ=1,2^2, mmMDT, Multiplicity)。关于这些变量的描述可参考文献Coleman等人(2018)。我们使用反-kT算法Cacciari等人(2008),其中距离参数为R=0.8,对所有喷注进行聚类。对重建的喷注pT施加一个截断,以排除极端事件进行分析。
基准模型的架构采用了文献Duarte等人(2018)中的架构,它是一个全连接神经网络(NN),由三个隐藏层组成,分别包含64、32和32个节点,并使用ReLU激活函数。输入层以16个高级特征作为输入,输出层由五个节点组成,使用softmax激活函数,得到喷注来自五个类别的概率。选择这个架构是为了在保持模型轻量化的同时提供合理的性能(总体准确率75%,每类准确率90%)。模型使用QKeras进行训练,其中核权重、偏置和激活函数进行了量化,限制了固定精度,并在权重优化期间进行了约束,这称为量化感知训练(QAT)。这是必要的,因为仅进行后训练量化(无微调)会导致准确性降低。在第3节中介绍的基准模型针对每个考虑的精度进行了微调。用于评估的模型使用hls4ml转换为HLS固件。
3 实现和结果
为了在FPGA上部署发现的表达式,我们使用了hls4ml库。我们通过Xilinx HLS数学库对hls4ml进行了扩展,以支持表达式。为了进一步优化资源利用和降低延迟,我们添加了功能,使得可以使用查找表(LUTs)对数学函数进行近似。图1展示了基于查找表的函数与HLS数学库函数的比较。我们使用⟨B, I⟩表示固定点精度,其中B是分配的总位数或位宽,I是整数位数。
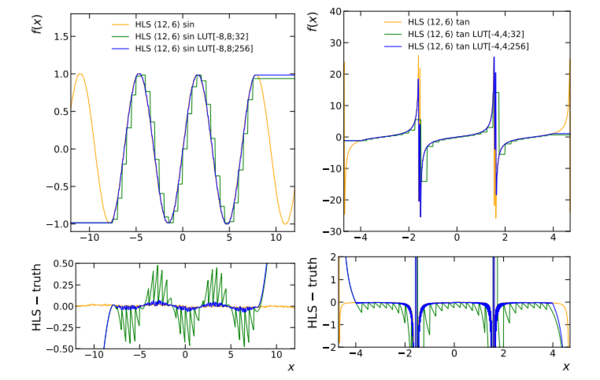
图1:在使用和不使用LUT的情况下,用HLS实现的正弦函数(左)和正切函数(右)的评估结果,精度为⟨12, 6⟩,即12位变量,其中6位为整数位。LUT的表示法为:[范围开始,范围结束;表格大小]。底部面板显示了函数与真实值之间的偏差情况。
在接下来的实验中,我们应用SR来拟合LHC喷注数据集,并展示其在FPGA部署环境中的资源效率。我们考虑了五个独立的代数表达式模型,作为16个高级输入特征的函数,表示为^y = s(x),其中s:R16→R5,输入经过标准化处理,输出^y对应于五个喷注类别中的一个的得分。通过标签器产生的最高分数来确定一个喷注所属的类别。
使用PySR软件包进行表达式搜索。它使用进化算法通过组合常量、变量和运算符(+、-、×、/、(⋅)2、sin(⋅)等)来构建符号表达式的树结构。搜索从一个随机组合开始,不需要对底层函数形式有先验知识,表达式根据指定的度量进行评估,最好的表达式可以进化到下一代,其中可以进行突变(选择一个节点进行更改)和交叉(交换两个解的子树)以探索更多的组合。PySR中有一个称为复杂性(c)的度量,默认情况下,每个常量、变量和运算符的复杂性设置为1。一个表达式的复杂性是其所有组成部分的复杂性之和。我们设置了模型选择策略,只要候选模型的损失最低且复杂性不超过我们选择的最大值cmax,就会被选中。在这种设置下,算法尝试解决以下优化问题,对于数据集{ (xi, yi) },其中每个输入xi∈R16,标签yi∈R5:
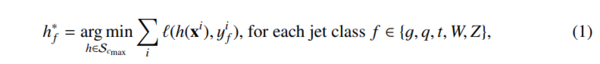
其中,Scmax是方程空间(即h:R16→R)的集合,其复杂性范围从1到cmax,并满足配置中指定的所有约束(运算符选择、函数嵌套等)。我们使用L2边界损失ℓ,定义如下:
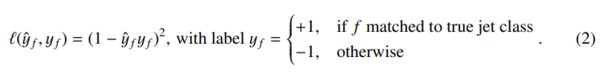
选择这种损失函数的原因是它的定义域为R2,适用于我们的设置,其中模型输出不受任何固定范围的限制。
SR的缺点是它是一个复杂的组合优化问题,无法充分利用基于梯度的优化方法的优势,因此在应用于高维数据集时效率较低。为了缓解这个挑战,PySR使用随机森林回归器评估每个输入特征的相对重要性。在下面的实验中,我们要求PySR从16个可用的输入中选择6个用于模型训练。
对于资源估计,每个模型都使用hls4ml转换为FPGA固件,然后使用Vivado HLS (2020.1) Xilinx (2020)进行综合,目标是Xilinx Virtex UltraScale+ VU9P FPGA,型号为'xcvu9p-flga2577-2-e'。所有结果都是在HLS编译步骤之后得出的。时钟频率设置为200 MHz(时钟周期为5 ns),这在LHC实时触发环境中是典型的设置 ATLAS Collaboration (2020, 2017); CMS Collaboration (2020a, b)。初始化间隔设置为1。在下面的研究中,我们监测准确性、延迟和资源使用情况(数字信号处理器,DSP,和查找表,LUT)以比较这些模型。
3.1 简单实现
我们首先研究具有单个数学函数类别的模型:多项式、三角函数、指数和对数。对于多项式模型,只考虑算术运算符:+、-和×。对于其他模型,分别添加了附加运算符:三角函数中添加了sin(⋅),指数中添加了Gauss(⋅)=exp(-(⋅)2),对数中添加了log(abs(⋅)。为简单起见,不允许函数嵌套(例如sin(sin(⋅))。默认情况下,每个运算符的复杂度为1。搜索分别重复进行cmax=20、40和80次,以观察模型大小对模型准确性和资源使用情况的影响。表1显示了具有cmax=20的三角函数模型的每个类别表达式。表2显示了所有模型中具有cmax=40的t标记器的表达式。准确度显示在图2中,FPGA资源使用和延迟显示在图3中。
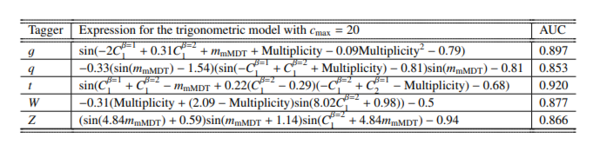
表1:使用PySR生成的具有cmax=20的三角函数模型的表达式。默认情况下,操作符复杂度设置为1。为了易读性,常数四舍五入到小数点后两位。报告接收器操作特性(ROC)曲线下的面积,即AUC。
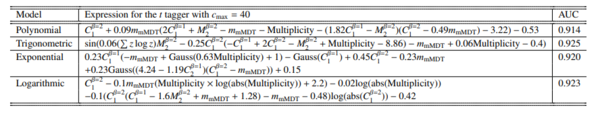
表2:使用PySR生成的具有cmax=40的不同模型中的t标记器的表达式。默认情况下,操作符复杂度设置为1。为了易读性,常数四舍五入到小数点后两位。
3.2 使用LUT进行函数逼近
基于第3.1节中的模型(多项式除外),我们使用查找表(LUT)逼近所有数学函数,并重新进行分析。在图2和图3中,这些模型对应于虚线。与基准相比,对于所有SR模型,资源使用量显著减少,特别是应用函数逼近的模型,有时可以实现几个数量级的改进。此外,与基准相比,SR模型需要显着较短的推理时间,同时准确度下降最小。特别地,在使用基于LUT的函数实现的指数和对数模型中,推理时间可以降低到1个时钟周期(5纳秒)的情况下,相比具有13个时钟周期(65纳秒)延迟的基准模型,减少了13倍,而相对准确度仍然在90%以上。图4比较了基准模型和三角函数模型的ROC曲线。
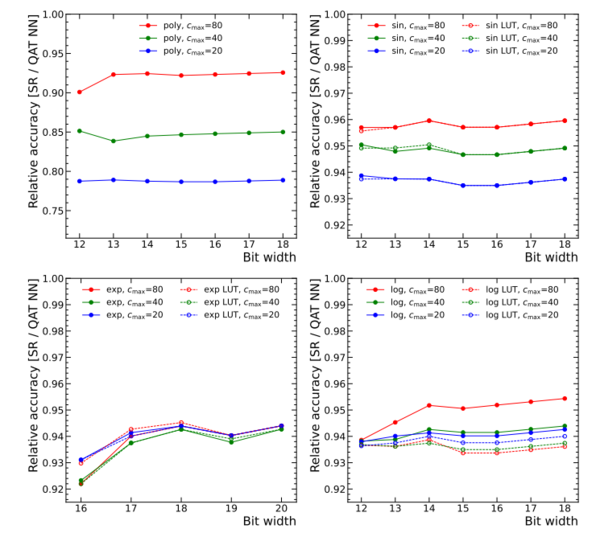
图2:相对准确度作为位宽的函数,对于多项式模型(左上)、三角函数模型(右上)、指数模型(左下)和对数模型(右下)。相对准确度是相对于基准QAT神经网络在相应精度上训练和实现的情况下进行评估的。指数模型的整数位数固定为I=12,其他模型的整数位数固定为I=6。
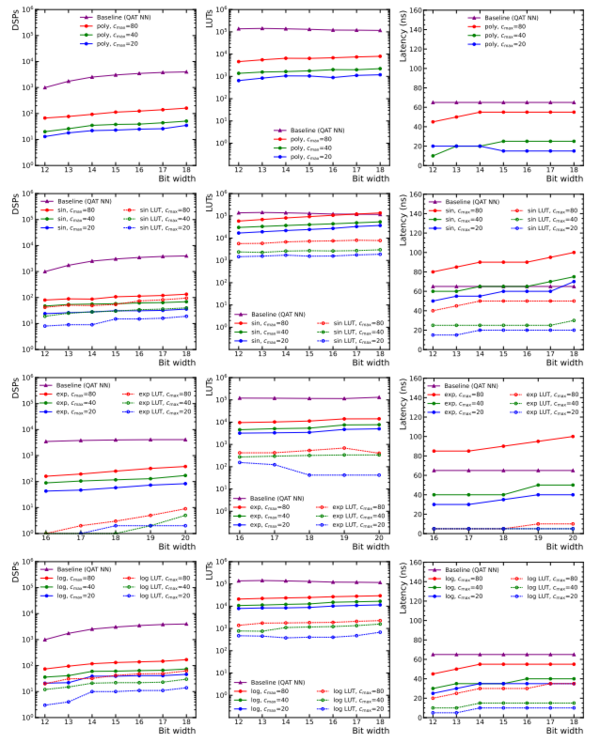
图3:DSP使用量(左)、LUT使用量(中)和延迟(右)作为位宽的函数。从上到下分别是:多项式模型、三角函数模型、指数模型和对数模型。为了比较,显示了在相应精度上训练和实现的基准QAT神经网络。资源使用量和延迟是通过在Xilinx VU9P FPGA上进行C综合得到的,器件型号为'xcvu9p-flga2577-2-e'。
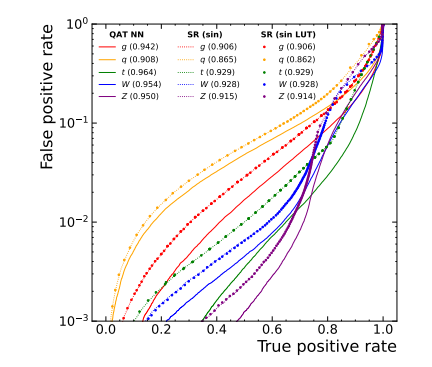
图4:使用精度⟨16, 6⟩实现的具有cmax=80的三角函数模型的ROC曲线,与基准QAT神经网络进行比较。括号中的数字对应于每个类别的AUC。
3.3 延迟感知训练
另一种方法是通过指导PySR以延迟感知的方式进行搜索来改善资源使用情况。默认情况下,PySR将每个操作符的复杂度都设置为1,以便它们在添加到表达式树时都受到相同的惩罚。然而,在FPGA部署中,这并不理想,因为例如,相比于在FPGA上评估的sin(⋅),操作符tan(⋅)通常需要更多的时钟周期。可以通过将操作符的复杂度设置为在FPGA上所需的相应时钟周期数,将这个时间成本纳入到表达式搜索中。需要注意的是,在使用LUT进行函数逼近的情况下,这种策略是无效的,因为每个索引操作只需要一个时钟周期。
我们展示了对于两种精度(⟨16, 6⟩和⟨18, 8⟩),使用cmax从20到80的延迟感知训练(LAT)。我们考虑以下操作符:+(1)、-(1)、×(1)、log(abs(⋅))(4)、sin(⋅)(8)、tan(⋅)(48)、cosh(⋅)(8)、sinh(⋅)(9)和exp(⋅)(3),其中括号中的数字对应于操作符的复杂度。为了简单起见,再次不允许函数嵌套。我们还限制了子树的总复杂度,以强制模型在帕累托前沿的不同部分探索解决方案。最终的表达式显示在表3中。模型的准确度、资源使用情况和延迟显示在图5中。与普通实现相比,LAT获得的SR模型使用的资源更少,延迟更小,而准确度相当。还可以实现最大延迟约束。我们添加了一个脚本来生成操作符复杂度,供从业者使用:https://github.com/AdrianAlan/hls4sr-configs。
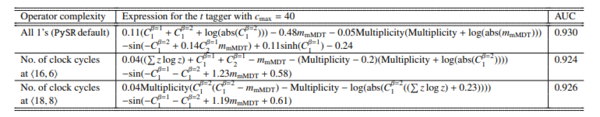
表 3: PySR生成的用于cmax=40的t标记器的表达式,使用LAT进行实现和未使用LAT进行实现。常数保留两位小数以提高可读性。
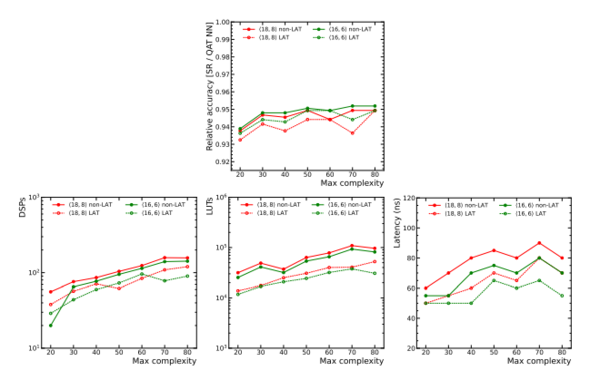
图5:相对准确度(顶部)、DSP使用量(左下)、LUT使用量(中下)和延迟(右下)作为cmax从20到80的函数,比较了来自普通实现(实线)和LAT(虚线)的模型。实现了两种精度设置:⟨16, 6⟩和⟨18, 8⟩。相对准确度是相对于基准模型进行评估的。资源使用量和延迟是通过在Xilinx VU9P FPGA上进行C综合得到的,器件型号为'xcvu9p-flga2577-2-e'。
4 总结与展望
在本文中,我们提出了一种新颖的方法,将符号回归(SR)应用于FPGA上进行快速机器学习推理。我们扩展了hls4ml包的功能,以支持PySR生成的符号表达式。我们在物理基准(LHC上的喷注标记)上展示了我们方法的有效性,并表明我们在FPGA上实现的SR能够显著减少执行关键任务所需的计算资源,成为深度学习模型的有希望的替代方案。在高能物理中利用SR提供了满足现代物理实验对灵敏度和延迟要求的宝贵解决方案。本研究的结果为未来的工作开辟了新的道路,包括进一步优化性能-资源权衡和探索在FPGA上应用SR的其他应用领域。
