语言模型,特别是 GPT-4 和 LLaMa 等大型语言模型 (LLM),在塑造数据管理的未来方面发挥着关键作用,特别是推动了一种称为矢量数据库的新型数据库的采用。
LLM正被用来从海量数据集中汲取洞察力,它们正在为我们存储、管理和检索数据的方式引入范式转变。本文是生成式 AI 系列的一部分,将探讨 LLM 和矢量数据库之间的关系,以及它们如何成为企业生成式 AI 堆栈的关键组件。
传统数据库的转变
关系数据库 (RDBMS) 等传统数据库长期以来一直为我们提供良好的服务,但在处理文本、图像和语音等非结构化数据方面存在局限性,这些数据构成了当今生成的数据的大部分。高效处理高维数据的需求正在导致向矢量数据库的重大转变,矢量数据库是一种旨在有效处理大型复杂数据类型的 NoSQL 数据库。
什么是矢量数据库?
矢量数据库专门用于存储和管理高维数据,例如矢量。矢量是一个数字数组,在生成式 AI 上下文中,它可以表示复杂的数据类型,例如文本、图像、语音甚至结构化数据。
矢量数据库具有高级索引和搜索算法,这使得它们对于相似性搜索特别有效,这是一种搜索与给定项目最相似的项目的技术。这是在生成 AI 中通过上下文数据增强提示的关键要求之一。
简而言之,向量是数值或变量的有序列表。此列表的元素称为向量的分量。
在一个简单的二维空间中,向量可以表示如下:
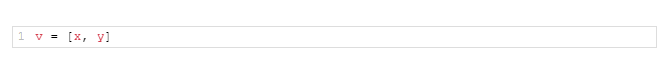
这里,“x”和“y”是向量“v”的分量。第一个分量“x”表示 x 坐标,第二个分量“y”表示二维笛卡尔坐标系中的 y 坐标。
我们可以很容易地将其扩展到三维空间:
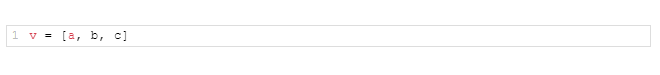
在这种情况下,“a”、“b”和“c”分别表示 x、y 和 z 坐标。
这个想法可以推广到 n 个分量的 n 维空间。
当在数据分析或机器学习的上下文中使用时,向量可以表示 n 维空间中的数据点,其中每个分量表示数据的特定特征或属性。
在自然语言处理中,向量可以表示一个词或一段文本。在这里,每个维度都可以对应于语言模型捕获的特定上下文或语义。
例如,单词“bank”在词嵌入模型中可能表示为一个 300 维的向量,每个维度捕获“bank”的含义或用法的某些方面。向量的维度帮助我们执行快速语义搜索,可以轻松区分短语“river bank”和“cash in the bank”。
LLM和矢量数据库的交集
与 GPT-4 一样,LLM 精通理解和生成类人文本,它们将文本转换为捕捉文本语义的高维向量(也称为嵌入)。这种转换使得对文本执行复杂的操作成为可能,例如查找相似的单词、句子或文档,这些是聊天机器人、推荐引擎等许多应用程序不可或缺的组成部分。
这些向量表示的性质需要一个高效的存储解决方案来处理索引和查询嵌入,这就是向量数据库的用武之地。它们存储这些高维向量并允许进行高效的相似性搜索,使其成为 LLM的理想选择基于应用程序。
矢量数据库可以测量两个矢量之间的距离,这定义了它们之间的关系。小距离表明高相关性,而较大的距离表明低相关性。
尽管传统的 NLP 模型依赖于诸如Word2Vec、全局词表示向量 ( GloVe ) 等技术,但像 GPT-3 这样的转换模型会创建上下文词嵌入。这意味着一个词的词嵌入可以根据使用它的上下文而改变。
每个 LLM 使用不同的机制来生成词嵌入/向量。例如,OpenAI 的text-embedding-ada-002模型旨在生成用于text-davinci-003和gpt-turbo-35模型变体的词嵌入。同样,Google 的 PaLM 2 使用embedding-gecko-001模型生成嵌入向量。
矢量数据库如何增强LLM的记忆力
正如上一篇文章中所讨论的,LLM在缺乏上下文时往往会产生幻觉。尽管上下文注入是提示增强的一个组成部分,但模型作为输入的标记大小有限,这意味着我们不能在提示中嵌入大量文本。
通过将以非结构化格式(如 PDF、MS Word 文档和其他格式)存储的数据编码为词嵌入并将它们存储在向量数据库中,我们可以执行语义搜索以检索提示所需的数据。由于查询向量数据库比将大型文档编码为词嵌入/向量要快得多,因此它显着加快了该过程。
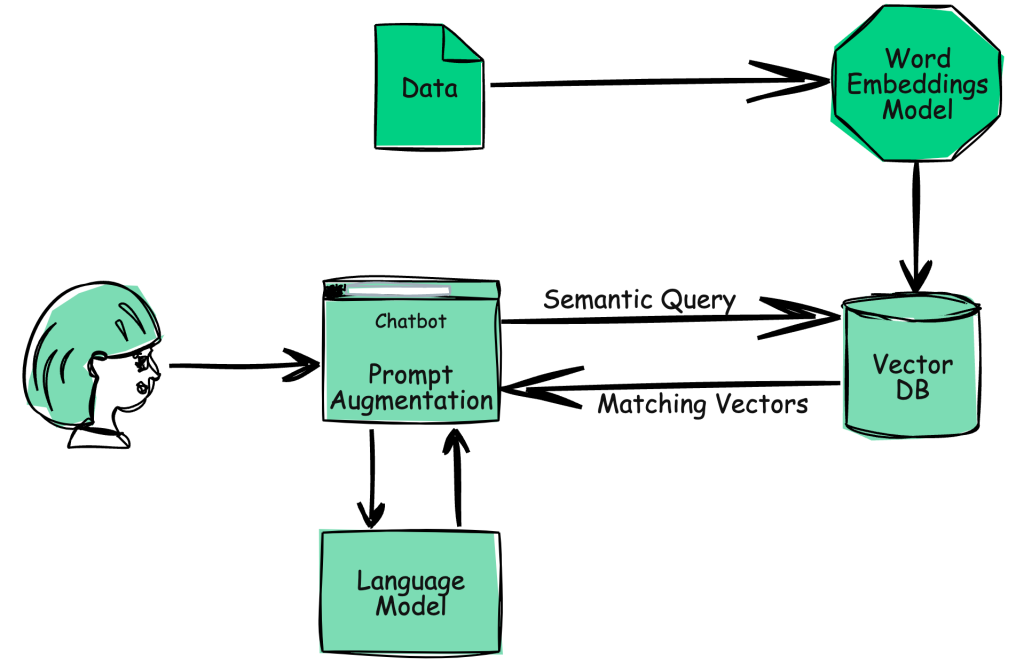
上图说明了使用矢量数据库进行上下文注入和提示增强所涉及的工作流程。
