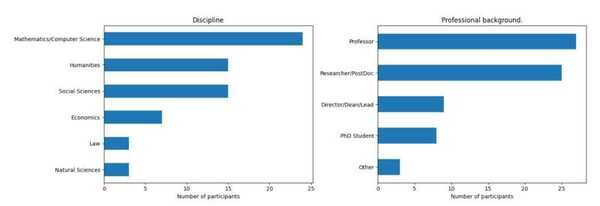
大型语言模型(LLMs),例如聊天机器人ChatGPT所使用的模型,具有革命性地改变科学系统的力量。这是亚历山大·冯·洪堡互联网与社会研究所(HIIG)进行的德尔菲研究的结论,该研究覆盖了72名专业从事人工智能和数字化研究的国际专家的广泛调查。
调查对象强调,科学实践的积极影响明显超过了消极的影响。同时,他们强调科学和政治的紧急任务是积极对抗LUM的可能误传,以保护科学研究的可信度。因此,他们呼吁通过积极的监管、透明度和新的伦理标准来使用生成AI。
研究论文《友还是敌?探究大型语言模型对科学系统的影响》现已在arXiv服务器上以预印本的形式发布。
根据专家的说法,语言模型在学术领域的文字表达方面具有最显著的正面影响。未来,大规模的语言模型将通过自动化写作和出版论文中的各种任务,提高研究流程的效率。同样,它们可以减轻科学家面临的日益繁重的行政报告和研究计划程序的负担,这些程序在最近几年中已经大幅增加。
因此,它们为批判性思考创造了额外的时间并开辟了新的创新途径,因为研究人员可以重新聚焦于他们的研究内容并有效地向更广泛的观众传达研究成果。
虽然承认不可否认的好处,但这项研究强调必须解决可能带来的负面后果。根据调查对象的说法,大型语言模型有可能生成与真正研究成果颇为相似的虚假科学声明,而这些虚假信息可能在公共辩论中得以传播,对社会产生负面影响并影响政策决策。同样的,大型语言模型中的错误训练数据可能会将各种种族主义和歧视性的刻板印象嵌入所生成的文本之中。
如果研究人员在日常工作中未经彻底验证就将LLM生成的内容纳入其中,那么这些错误可能会渗透到科学辩论中。
为了克服这些挑战,研究人员必须掌握新的技能。这些技能包括批判性地将LLM的结果置于背景中。在大语言模型的错误信息日益增多的情况下,研究人员需要利用自己的专业知识、权威性和声誉来推动客观公共话语的发展。他们主张更严格的法律规定、增加培训数据的透明度以及在利用生成式AI技术上培养负责任和道德的实践,以推动科学系统的发展。
调查的主要研究员Benedikt Fecher博士评论说:"这些结果表明,大型语言模型在科学研究中具有变革潜力。尽管它们带来的巨大好处超过了风险,但AI和数字化领域的专家意见显示,切实解决与错误信息和对科学的信任丧失有关的挑战非常重要。如果我们负责任地使用LLM,并遵守伦理指南,就可以最大程度地利用它们的积极影响,并将潜在的危害降至最低。"
