在发表于《机器智能研究》的一篇论文中,研究团队探讨了预训练模型是否可应用于多模态任务,并取得了重要进展。该论文综述了视觉语言预训练(VLP)领域中图像-文本和视频-文本预训练的最新进展和新领域。
为了让读者更加全面地了解VLP,研究人员首先回顾了其在五个方面的近期进展:特征提取、模型架构、预训练目标、预训练数据集和下游任务。然后,他们详细总结了具体的VLP模型。最后,他们讨论了VLP领域的新前沿。
让机器像人类一样做出反应一直是人工智能研究人员不懈追求的目标。为了让机器能够感知和思考,研究人员提出了一系列相关任务,如人脸识别、阅读理解和人机对话等,以训练和评估机器在特定方面的智能水平。具体而言,领域专家手动构建标准数据集,然后在其上训练和评估相关模型。
然而,由于相关技术的限制,通常需要使用大量标记数据进行培训,才能获得更好、更有能力的模型。基于Transformer结构的预训练模型的最近出现缓解了这个问题。它们通过自监督学习进行首次预训练,通常利用辅助任务(预训练目标)从大规模未标记数据中挖掘监督信号来训练模型,从而学习普适表示。
然后,他们可以通过在下游任务中仅使用一小部分手动标注数据进行微调,达到惊人的有效性。自然语言处理(NLP)领域中BERT的出现以来,各种预训练模型已经在单模态领域中涌现出来。大量的研究表明它们对于下游单模态任务是有益的,避免了从头开始训练一个新模型。
类似于单模态领域,多模态领域也存在标注数据质量不高的问题。一个自然的问题是上述预训练方法是否适用于多模态任务。研究者一直在探索和解决这个问题,并已经取得了重要的进展。
本文的研究重点是关于主流的视觉语言预训练(VLP),包括图像-文本和视频-文本预训练。VLP主要通过对大规模数据进行预训练来学习不同模态之间的语义对应关系。例如,在图像-文本预训练中,研究人员希望模型能够将文本中的“狗”与图像中“狗”的外观相对应起来。
在视频文本预训练中,他们期望模型能够将文本中的对象/行为映射到视频中的对象/行为。为了实现这一目标,VLP 对象和模型结构需要被巧妙地设计,以允许模型挖掘不同形式之间的关联。
为了让读者更好地了解VLP,研究人员首先全面回顾了其最新进展,并重点关注了五个重要方面:特征提取、模型架构、预训练目标、预训练数据集和下游任务。然后,他们详细总结了最先进的VLP模型的具体情况。最后,他们总结了论文,并对VLP的新领域展开广泛的讨论。
本文从五个方面回顾了VLP的最新进展。
首先,研究人员描述了VLP模型如何预处理和表示图像、视频和文本以获取相应特征,同时引入了不同的模型。
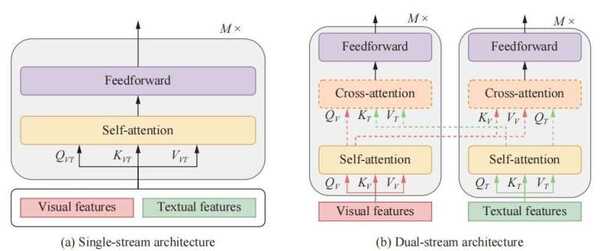
其次,他们从两个不同角度介绍了VLP模型的架构:一是从多模态融合的角度展示单流和双流的差异,另一个则是从整体架构设计的角度呈现编码器-仅有和编码器-解码器之间的区别。
第三部分,介绍了研究人员如何通过使用不同的预训练目标来预训练VLP模型,这对于学习通用的视觉语言表示是至关重要的。预训练目标总结为四个类别:填充、匹配、时间和特定类型。
第四,研究者将预训练数据集分为两个主要类别:图片-语言预训练和视频-语言预训练。并且他们提供了每个类别的代表性预训练数据集的详细信息。最后,他们介绍了VLP中下游任务的基本细节和目标。
然后,研究人员详细总结了具体的 SOTA VLP 模型。他们用表格展示了主流的图像文本 VLP 模型和主流的视频文本 VLP 模型的总结。之后,研究人员提出了 VLP 未来的发展方向。他们建议,基于现有的工作,VLP 可以从以下方面进一步发展:融合声学信息、知识和认知学习、快速调整、模型压缩和加速、跨领域预训练和先进的模型架构。研究人员希望他们的调查能帮助他人更好地理解 VLP,并激发新的工作来推进这一领域的发展。
