为什么人工智能系统在某些视觉任务上(如面部识别)能胜过人类,却在其他任务上(比如将一张宇航员的照片误认为铲子)犯下如此显著的错误?
就像人脑一样,人工智能系统依靠策略来处理和分类图像。而且,就像人脑一样,对于这些过程的确切性质我们了解甚少。布朗大学卡尼脑科学研究所的科学家们正在取得进展,近期发布的一篇论文有助于以研究人员称之为可理解且比以往模型更有用的方式解释计算机视觉。
“人类大脑和驱动人工智能系统的深度神经网络都被称为黑匣子,因为我们并不确切知道其中发生了什么。”布朗大学的认知、语言、心理科学和计算机科学教授Thomas Serre表示,“我们在Carney’s Center for Computational Brain Science开展的工作旨在理解和描述与学习、视觉以及各种事物相关的大脑机制,并凸显与人工智能系统之间的相似之处和差异。”
Serre说,深度神经网络使用学习算法来处理图像。它们通过训练大量的数据集(例如来自网络的超过一百万张图片,按照数千个物体类别进行组织的ImageNet)进行训练。他解释道,训练主要涉及将数据输入到人工智能系统中。
"我们不告诉AI系统如何处理图像,比如从图像中提取哪些信息以便能对其进行分类," Serre说道。"AI系统会自己发现一种策略。然后计算机科学家们在训练完成后评估所做的准确性,例如,该系统在区分一千个图像类别方面可能达到了90%的准确率。"
塞尔与布朗大学博士候选人托马斯·费尔和其他计算机科学家合作,开发了一种工具,让用户能够揭开深度神经网络这个黑匣子的盖子,揭示人工智能系统处理图像时所使用的策略类型。该项目名为CRAFT(Concept Recursive Activation FacTorization for Explainability),是与托卢兹人工与自然智能研究所合作的联合项目,费尔目前正在该研究所工作。该项目于本月在加拿大温哥华举行的IEEE/CVF计算机视觉与模式识别会议上进行了演示。
塞尔(Serre)分享了CRAFT如何展示人工智能“看”图像,并解释了理解计算机视觉系统与人类系统之间差异的重要性。
AI在处理图像时,CRAFT展示了哪些信息呢?
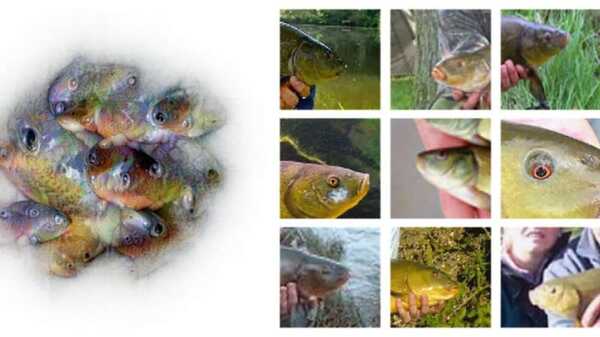
CRAFT为神经网络学习到的复杂且高维的视觉表征提供了一种解释,利用现代机器学习工具使其更加易于人类理解。这样就呈现出神经网络用于分类对象的关键视觉概念。以一种名为鳙鱼的淡水鱼为例,我们建立了一个网站,让人们可以浏览和可视化这些概念。通过使用该网站,人们可以看到AI系统对鳙鱼的概念包括一组鱼鳍、头部、尾部、眼球等。
这些概念也揭示了深度神经网络有时会捕捉到数据集中存在的偏见。举个例子,与鳙鱼相关的一个概念是一个白人男子的面孔,这是因为网络上有很多照片显示运动钓鱼者抱着看起来像鳙鱼的鱼类。(然而,系统仍然能够区分人和鱼。)另一个例子是,神经网络中与足球相关的主要概念是球场上的足球运动员的存在。这可能是因为大部分互联网上展示足球的图片都包括了个别的球员,而不仅仅是足球本身。
CRAFT方法与其他理解计算机视觉的方式有何不同?
一种解释人工智能视觉的方式是通过所谓的归因方法,这些方法使用热点图以识别对人工智能决策产生最大影响的图像区域。然而,这些方法主要关注图像中最显著的区域,揭示了模型的“注视点”,但未能解释该模型在这些区域中看到的“内容”。
Thomas Fel引入CRAFT所带来的改进在于不仅能够确定系统在拼凑图像时所使用的概念,或者说模型在这些区域中看到了什么,还能了解系统是如何对这些概念进行排序的。以tench(一种鱼)为例,鱼的躯干相对于整个tench概念的权重占比为60%。因此,我们可以了解到AI系统对这些子概念的权重是多少。换句话说,相较于将一个白人男性的图像分类为鱼,将只有tench躯干的图像分类为鱼更加可能发生。
CRAFT如何解释为什么人工智能视觉系统有时会犯下奇怪的错误呢?
在我们的论文中,我们使用CRAFT来解释一个经典的人工智能错误:当一个AI系统在ImageNet上训练时,将一个宇航员的图像错误地分类为铲子。下面是发生的情况:一个经典的归因方法生成的热图显示系统在图像的中间以铲子的形状查看。CRAFT方法突出显示了两个最具影响力的概念以及它们对应的位置,这推动了决策的形成。
CRAFT提出,神经网络做出决策是因为它识别出了在图像类别“铲子”中常见的“污垢”概念以及人们穿着滑雪裤在铲雪时通常穿着的概念。它本应该识别出正确的宇航员裤子的概念,但由于在训练过程中可能从未见过那种裤子的图像,所以系统无法建立起这种联系。
为什么深入了解计算机如何看待图像的细节如此重要呢?
首先,这有助于提高基于视觉的工具(如面部识别)的准确性和性能。它使得AI系统更加可信,因为我们可以理解其视觉策略的运用。同时,它还有助于增强其对抗网络攻击的安全性。举个例子,对抗性攻击的概念就是一个典型例证。事实上,我们可以对图像进行微小的变化,例如通过改变像素的强度,这对于人类几乎察觉不到,但却足以完全欺骗AI系统。
在一个极其重要的例子中,研究人员已经证明,只需在停止标志上添加几个特定图案的贴纸,他们就能够迷惑自动驾驶汽车,使其将其视为限速标志,导致它加速而不是减速停车。这将造成完全的混乱。因此,我们需要能够理解为什么以及如何对人工智能进行此类攻击,以便我们能够保护自己免受这些攻击。
人工智能视觉系统能够向我们展示关于人类视觉系统的哪些知识呢?
我们已经了解到,这些神经网络处理图像的方式与人脑根本不同——人脑不会把一张加了黑色贴纸的停车标识视作限速标志。然而,这些系统却非常精巧,有时甚至可以胜过人类,比如在面部识别任务中。我们实验室的许多工作就是比较这些系统的相似之处和不同之处。
每当我们能够发现人工智能系统的局限性时,我们就会转向神经科学,并询问:“在人类能够稳健高效地解决这个任务时,缺失在人工智能系统中的大脑机制是什么?”然后,我们会构建这种机制的机器学习抽象,并将其注入到神经网络的人工智能系统中。我们发现,一旦赋予人工智能系统人类大脑启发的机制,它们的表现会更好:它们更稳健,在学习上更高效,并且在较少的训练下更准确。
在神经科学方面,这项研究有助于我们更好地理解人类的大脑以及人类与人工智能系统之间的差异如何帮助人类。与人类大脑相比,我们可以更容易、更安全地验证我们的想法。理解大脑如何处理视觉信息是非常困难的。目前已经发展出了一些方法来理解神经元的工作和功能,而通过人工智能系统,我们现在可以测试这些理论,看看我们的想法是否正确。
这种协同作用双向互惠:神经科学为我们提供了改善人工智能的良好启示。然而,我们通过这些神经科学机制改善人工智能的事实,也是验证神经科学中所作出的发现,并确定普遍智能、视觉智能等关键机制的一种方式。
关于人工智能系统过于类人化的担忧我们听得很多。但对于视觉来说,这似乎是件好事,不是吗?
在许多情况下,我们发现将人工智能视觉系统与人类视觉系统相一致具有非常显著的益处:那些更加类似于人类的模型变得更加值得信赖、可靠,对抵抗攻击有更强的韧性,并且更不容易做出你不希望它们做出的行为。
这项研究的下一步是什么?
很有趣地观察AI系统对自然物体进行分类,然而我认为接下来的发展将是运用我们对AI和人类视觉的理解,帮助AI系统解决科学上一些人类目前难以解决的大问题,比如癌症诊断、化石识别或者太空探索。这将是非常激动人心的发展。
