2016年3月,全球见证了一场人类智慧与人工智能的历史性对决。计算机程序AlphaGo通过大量数据库的训练,最终在围棋这款被誉为计算无尽可能走法的复杂游戏中,战胜了人类对手,取得了胜利。
AI的持续进化所需的高质量数据的重要性不可否认。AI已经无缝地融入了医疗、金融和教育等行业,而它的进步在很大程度上依赖于可靠数据的可用性来进行学习。
数据通常以分布式组的形式存储,被称为表。为了使人工智能能够从这些表存储的数据中获取洞见,我们需要运用“连接”过程将这些不同的表合并成一个全面的表。由此产生的庞大表的规模在存储方面提出了挑战,而连接过程本身也可能非常耗时。甚至到现在,从表中快速且统一地对数据进行抽样的技术依然是数据科学中尚未解决的复杂难题。
在一项重大突破中,浦项科技大学人工智能研究所韩旭信教授领导的研究团队,与博士候选人金景民(融合信息技术工程系)合作,提出了一种全新的数据采样优化方法,用于跨多个表存储的数据。这一新技术成功地快速生成了结果。
该研究成果被发表在第42届ACM SIGMOD-SIGACT-SIGAI数据库系统原理研讨会(PODS 2023)的论文集中。这是个具有历史意义的时刻,因为这是韩国研究团队的论文首次在这一研讨会上呈现,而该研讨会迄今已有42年的历史。
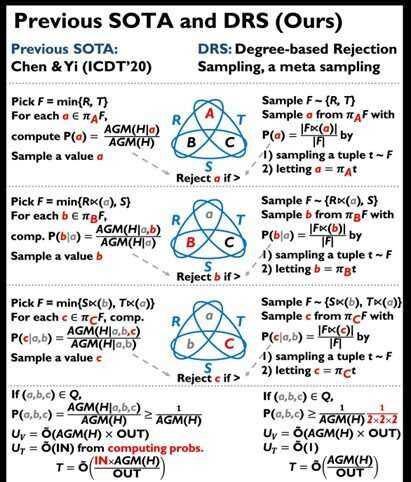
研究人员开创了一种称为基于度的拒绝抽样(DRS)的方法,属于元抽样范畴下的一种。传统方法要求预先计算样本空间中每个值的概率,然后才能直接提取任何值。相比之下,该团队提出的DRS方法从一个简单的概率分布的样本空间出发,该概率分布基于特定值的度,然后从这个样本空间中选取值。
团队令人信服地证明了至少一个样本空间的概率比通过传统方法计算的复杂概率更高,可以选择的任意随机值都是如此。这意味着通过拒绝抽样可以获得与传统方法类似的概率来获取值。这样,样本空间的提取概率仅仅被乘以一个常数值作为抽样值的概率,避免了复杂的概率计算,允许快速进行数据采样。
此外,团队还采用了一种被称为广义超树分解(GHDs)的技术来扩展这种方法,该方法在整合表格时的连接过程中以树形式分析查询。如果整个查询使用单一的连接算法进行处理,则可能会导致时间复杂度较高,尤其是当查询包含多个连接关系时。
使用GHD(Generalized Hierarchical Databases)可以对较小的子查询进行联接操作,而不是对整个查询进行操作,随后再将结果合并,从而降低时间复杂度。研究团队将GHD与DRS(Domain-Relational Schema)结合起来,以增强后者,在某些情况下可以保证比原始DRS更低的复杂度。
领导着这项研究的韩旭信教授对这种创新方法充满希望,他表示:“这种技术可以普遍应用于所有查询,无论数据结构形成树状展示层级关系,还是形成循环描绘循环关系。它承诺在机器学习的数据采样过程中显著提高速度和准确性。”
