并不是你在社交媒体上与之意见不合的每个人都是机器人,但确实存在各种形式的社交媒体操纵来传播虚假叙述。
2019年,全球互联网上的不良行为成本保守估计为780亿美元。与此同时,虚假信息策略不断演变:追踪它们一直是一种被动的事情,恶意行为者总是抢占先机。
数据科学威廉与玛丽学院助理教授亚历山大·恩瓦拉以打击这些滥用行为为目标。他与印第安纳大学社交媒体观察所的同事最近在《EPJ数据科学》上发表了一篇论文,介绍了一种名为BLOC的通用语言框架,用于建模社交媒体行为。
这个框架背后的主要思想不是针对特定行为,而是提供一种能够描述行为的语言。
自动化机器人模仿人类行为的能力随着时间的推移变得更加复杂。不真实的协调行为代表另一种常见的欺骗,这种欺骗通过可能在个体账户级别看起来不可疑的行动来体现,但实际上是涉及多个账户的策略的一部分。
然而,并不是所有的自动化或协调行为都是恶意的。BLOC不对“好”的或“坏”的行为进行分类,但它为研究人员提供了一种描述社交媒体行为的语言,基于这种语言,可以更容易地识别出潜在的恶意行为。
一种用户友好的工具来调查可疑账户行为正在威廉与玛丽学院开发中。威廉与玛丽学院本科生领导的DisinfoLab的技术总监伊恩·麦克唐纳德正在构建一个基于BLOC的网站,供研究人员、记者和公众使用。
检测自动化和协调行为的过程,恩瓦拉解释说,首先从特定时间段内的某个社交媒体账户中对帖子进行抽样,并使用特定的字母表编码信息。
BLOC代表“在线行为语言”,它依赖于行为和内容字母表,以一种可以轻松适应不同社交媒体平台的方式来表示用户行为。
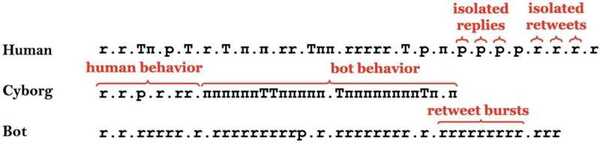
例如,像“TpπR”这样的字符串表示了四个用户行为的序列:具体包括发布帖子、回复非朋友然后回复自己以及转发朋友的消息。
使用内容字母表,相同的行为集合可以被描述为“(t)(EEH)(UM)(m)”,如果用户的帖子分别包含文本、两张图片和一个哈希标签、一个链接和一个朋友提及和一个非朋友提及。
然后将得到的BLOC字符串分词成代表不同行为的词汇。一旦我们有了这些词汇,我们建立所谓的向量,即这些词汇的数学表示。因此,我们会有各种BLOC单词,然后是用户表达该单词或行为的次数。
一旦得到向量,数据会通过一个经过训练的机器学习算法进行处理,该算法能够识别出不同类型的用户之间的区别模式(例如,机器和人类)。
人类和机器人行为处于频谱的两个相反极端:在中间,有在这两者之间摇摆的“半机器人”账户。
我们创建了捕捉机器和人类行为的模型,然后我们找出未知账户更接近于人类还是机器的情况。
使用BLOC框架不仅有助于侦测机器人,能够与当前的侦测方法相媲美甚至超越它们;它还可以识别出类似人类账户之间的相似性。恩瓦拉指出,BLOC还被应用于检测协调的不真实账户。
相似性是一个非常有用的度量标准。如果两个账户几乎在做同样的事情,你可以使用BLOC来调查他们的行为,看看他们是否由同一个人控制,然后进一步调查他们的行为。
BLOC目前是独一无二的,可以解决不同形式的操纵,并且在平台改变使得流行的侦测工具变得过时的情况下仍将保持活力。
而且,如果出现一种我们想研究的新行为形式,我们不需要从零开始。我们可以使用BLOC来研究这种行为,并可能检测到它。
