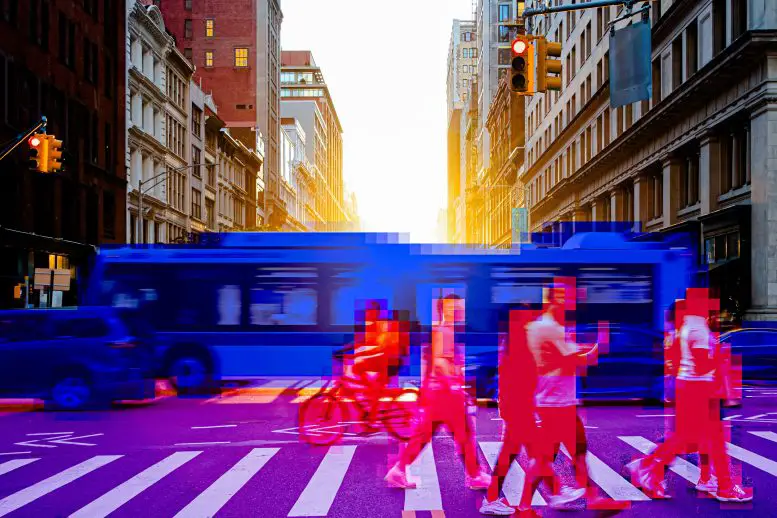
一种新的人工智能系统可以提高视频流媒体中的图像质量,或者帮助自动驾驶车辆实时识别道路危险。麻省理工学院和麻省理工-IBM沃森人工智能实验室的研究人员推出了EfficientViT,一种计算机视觉模型,可以加快高分辨率图像的实时语义分割,优化适用于硬件有限的设备,例如自动驾驶车辆。
自动驾驶车辆必须快速准确地识别遇到的物体,从停放在街角的运货卡车到冲向交叉口的自行车骑手。为了做到这一点,车辆可能使用一种强大的计算机视觉模型来对这个场景中的每个像素进行分类,以便在低质量图像中不会失去视线。但是,这个被称为语义分割的任务很复杂,并且在图像分辨率较高时需要大量计算。
来自麻省理工学院、麻省理工-IBM沃森人工智能实验室和其他地方的研究人员开发出了一种更高效的计算机视觉模型,极大地减少了这个任务的计算复杂性。他们的模型可以在具有有限硬件资源的设备上实时准确地执行语义分割,例如让自动驾驶车辆做出瞬间决策的车载计算机。
优化实时处理
最新的语义分割模型直接学习图像中每对像素之间的相互作用,因此随着图像分辨率的增加,计算量呈二次增长。因此,虽然这些模型准确性很高,但在传感器或手机等边缘设备上实时处理高分辨率图像时速度太慢。
麻省理工学院的研究人员为语义分割模型设计了一个新的构建模块,它具有与这些最新模型相同的功能,但计算复杂性仅为线性,并具有高效的硬件操作。
结果是,当部署在移动设备上时,这个新的高分辨率计算机视觉模型的性能比先前的模型提高了多达九倍。重要的是,这个新的模型系列展示了与这些替代方案相同或更好的准确性。
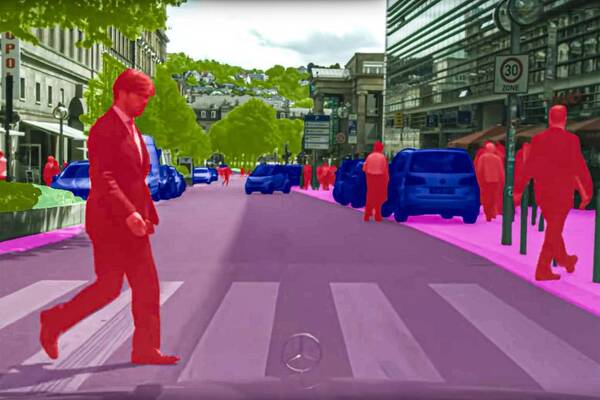
对解决方案作更深入的剖析
这种技术不仅可以帮助自动驾驶车辆实时做出决策,还可以提高其他高分辨率计算机视觉任务的效率,比如医学图像分割。
麻省理工学院工程与计算机科学系(EECS)的副教授、麻省理工学院-IBM沃森人工智能实验室成员、这项新模型的论文的高级作者韩松说:“虽然研究人员长期以来一直在使用传统的视觉变换器,并取得了惊人的结果,但我们希望人们也能注意到这些模型的效率方面。我们的研究表明,通过大幅减少计算量,可以使实时图像分割在设备上本地进行。”
该论文的主要作者是韩材,他是EECS的研究生;李俊岩,是浙江大学的本科生;胡牧燕,是清华大学的本科生;甘创,是麻省理工学院-IBM沃森人工智能实验室的首席研究员。这项研究将在国际计算机视觉会议上进行展示。
简化的解决方案
对于一个可能有数百万个像素的高分辨率图像中的每个像素进行分类是一项困难的任务对于机器学习模型来说。一种强大的新型模型,称为视觉变换器,最近已经得到了有效的应用。
变压器最初是为自然语言处理开发的。在这个语境下,它将句子中的每个单词编码为一个标记,然后生成一个注意力图,它捕捉到每个标记与其他标记的关系。这个注意力图有助于模型在做出预测时理解上下文。
使用相同的概念,视觉变换器将图像切分成像素块,并将每个小块编码成一个标记,然后生成一个注意力图。在生成这个注意力图时,模型使用一个相似度函数,直接学习每对像素之间的交互。通过这种方式,模型开发出了被称为全局感受野的特性,这意味着它可以访问图像的所有相关部分。
由于高分辨率图像可能包含数百万个像素,分成数千个块,注意力图很快就会变得巨大。因此,随着图像分辨率的增加,计算量呈二次增长。
在他们的新模型系列EfficientViT中,麻省理工学院的研究人员使用了一种更简单的机制来构建注意力图——用线性相似性函数替换非线性相似性函数。通过这样做,他们可以重新安排操作顺序,减少总计算量,而不改变功能并丧失全局感受野。通过他们的模型,用于预测的计算量随着图像分辨率的增加呈线性增长。
但是不存在免费的午餐。线性注意力只能捕捉到图像的全局上下文,而丧失了局部信息,这会使准确性降。
为了弥补这种准确性的损失,研究人员在他们的模型中包含了两个额外的组件,每个组件只需要很小的计算量。
其中一个元素帮助模型捕捉局部特征的相互作用,缓和线性函数在提取局部信息方面的局限性。第二个元素是一个能够实现多尺度学习的模块,可以帮助模型识别大型和小型物体。关键的部分在于我们需要在性能和效率之间仔细平衡。
他们设计了EfficientViT的硬件友好体系结构,使其更容易在不同类型的设备上运行,例如虚拟现实头盔或自动驾驶车辆上的边缘计算机。他们的模型还可以应用于其他计算机视觉任务,如图像分类。
简化语义分割
当他们在用于语义分割的数据集上测试他们的模型时,他们发现它在Nvidia显卡上的速度比其他流行的视觉变换器模型快了高达9倍,而准确性相同或更好。
现在,我们可以获得两全其美的效果,减少计算量,使其运行速度足够快,可以在移动设备和云设备上运行。
基于这些结果,研究人员希望将这种技术应用于加速生成式机器学习模型,如用于生成新图像的模型。他们还希望继续扩大EfficientViT在其他视觉任务中的应用。
韩松教授的团队开发的高效变压器模型如今已经成为各种计算机视觉任务的前沿技术的支柱。他们的研究不仅展示了变压器的效率和能力,还揭示了它们在增强视频游戏图像质量等实际应用中的巨大潜力。
模型压缩和轻量级模型设计是高效人工智能计算的关键研究课题,特别是在大型基础模型的背景下。韩松教授的团队在压缩和加速现代深度学习模型方面取得了显著进展,特别是视觉变压器。甲骨文云基础设施一直在支持他的团队推动这项具有影响力的研究,以实现高效和环保的人工智能。
