研究人员通过使用1400多个图形处理器(GPUs)和开创性的算法技术,模拟了谷歌的53位量子比特Sycamore电路,从而在量子计算领域取得了重大突破。
他们高效的张量网络方法和巧妙的“前k个”采样方法极大地降低了精确模拟所需的内存和计算量。这些策略已在较小的测试电路上得到了验证,可能会塑造量子研究的未来,突破经典系统模拟能力的极限。
模拟谷歌的量子电路
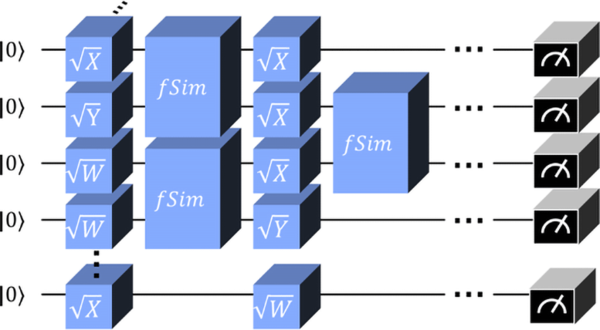
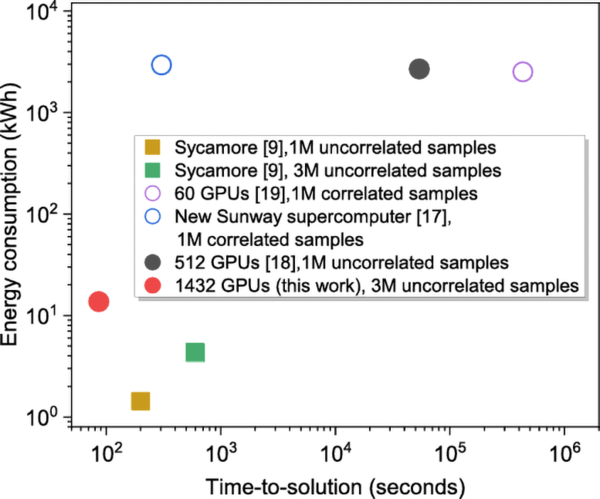
一个研究团队在量子计算领域取得了重大突破,成功模拟了谷歌53位量子比特、20层的Sycamore量子电路。这是使用1432个NVIDIA A100图形处理器和高度优化的并行算法实现的,为在经典硬件上模拟量子系统开辟了新途径。
张量网络算法的创新
这一成就的核心在于先进的张量网络收缩技术,该技术能够有效估算量子电路的输出概率。为了使模拟成为可能,研究人员采用切片策略,将整个张量网络分解成更小、更易管理的部分。这大大降低了内存需求,同时保持了计算效率,使得用相对较少的资源模拟大型量子电路成为可能。
团队还采用了一种“前k名”采样方法,从模拟输出中选择最可能的位字符串。通过仅关注这些高概率结果,他们改进了线性交叉熵基准(XEB)——这是衡量模拟与预期量子行为匹配程度的关键指标。这不仅提高了模拟的准确性,还降低了计算负载,使流程更快、更具可扩展性。
用小电路进行验证
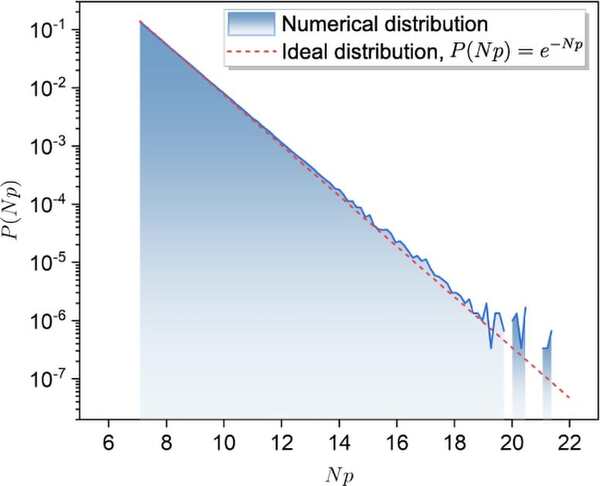
为了验证他们的算法,研究人员对较小规模的随机电路进行了数值实验,包括一个30位量子比特、14层门电路。实验结果表明,对于不同张量收缩子网络规模,该算法得出的XEB(交叉熵基准)值与理论预测值高度一致。前k值方法提高了XEB值,与理论预测值紧密吻合,从而证实了该算法的准确性和高效性。
优化张量收缩性能
该研究还强调了优化张量收缩资源需求的策略。通过优化张量指标的顺序并最小化GPU间的通信,团队在计算效率方面取得了显著提升。基于复杂度估算,该策略还表明,增加内存容量(如80GB、640GB和5120GB)可以显著降低计算时间复杂度。每个计算节点采用8×80 GB的内存配置,实现了高性能计算。
量子模拟的未来
这一突破不仅为多量子比特量子计算机的经典模拟建立了新的基准,还为未来的量子计算研究引入了创新的工具和方法。通过不断改进算法和优化计算资源,研究人员有望在模拟具有更多量子比特的更大规模量子电路方面取得实质性进展。这项工作在量子计算领域取得了重大进展,为量子技术的持续开发提供了宝贵见解。
参考文献:《超越枫糖树:利用1432个GPU实现量子随机电路采样速度提升7倍》,作者:赵先和、钟汉森、潘峰、陈子涵、付蓉、苏中令、谢晓彤、赵朝星、张攀、欧阳万里、陆朝阳、潘建伟、陈明城,发表于《国家科学评论》,2024年9月12日。DOI:10.1093/nsr/nwae317
