摘要
Bigtable是一个分布式存储系统,用于管理结构化数据,其设计可扩展到非常大的规模:跨越数千台商品服务器的PB级数据。谷歌的许多项目将数据存储在Bigtable中,包括web索引、谷歌地球和谷歌金融。这些应用程序在数据大小(URL、网页、卫星图像)和延迟要求(后端批量处理、实时数据服务)方面对Bigtable提出了非常不同的需求。尽管有这些需求有各种差异,Bigtable已经成功地为所有这些Google产品提供了灵活、高性能的解决方案。在本文中,我们描述了Bigtable提供的简单数据模型,它为客户提供了对数据布局和格式的动态控制,并描述了Bigtable的设计和实现。
1. 介绍
在过去两年半的时间里,我们在谷歌设计、实施和部署了一个分布式存储系统,用于管理结构化数据,名为Bigtable。Bigtable设计用于可靠地扩展到数PB的数据和数千台机器。Bigtable实现了几个目标:广泛的适用性、可扩展性、高性能和高可用性。Bigtable被60多个Google产品和项目使用,包括Google Analytics、Google Finance、Orkut、个性化搜索、Writely和Google Earth。这些产品将Bigtable用于各种苛刻的工作负载,从面向吞吐量的批处理作业到向最终用户提供对延迟敏感的数据服务。这些产品使用的Bigtable集群跨越了广泛的配置,从少数服务器到数千台服务器,并存储多达数百TB的数据。
在许多方面,Bigtable类似于数据库:它与数据库共享许多实现策略。并行数据库[14]和主存数据库[13]已经实现了可伸缩性和高性能,但Bigtable提供了一个与此类系统不同的接口。Bigtable不支持完整的关系数据模型;相反,它为客户端提供了一个简单的数据模型,支持对数据布局和格式的动态控制,并允许客户端对底层存储中表示的数据的位置属性进行推理。使用可以是任意字符串的行和列名对数据进行索引。Bigtable还将数据视为未解释的字符串,尽管客户端通常将各种形式的结构化和半结构化数据序列化到这些字符串中。客户端可以通过仔细选择模式来控制数据的位置。最后,Bigtable模式参数允许客户端动态控制是从内存还是从磁盘提供数据。
第2节更详细地描述了数据模型,第3节概述了客户端API。第4节简要描述了Bigtable所依赖的底层Google基础设施。第5节描述了Bigtable实现的基本原理,第6节描述了我们为提高Bigtable性能所做的一些改进。第7节提供了Bigtable性能的度量。我们在第8节中描述了Google如何使用Bigtable的几个例子,并在第9节中讨论了我们在设计和支持Bigtable时学到的一些经验教训。最后,第10节描述了相关工作,第11节给出了我们的结论。
2. 数据模型
Bigtable是一个稀疏的、分布式的、持久的多维排序映射。映射由行键、列键和时间戳索引;映射中的每个值都是一个未解释的字节数组。
(行:string,列:string,时间:int64)→ string
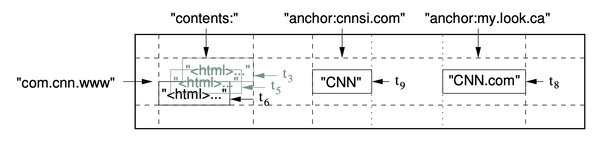
图1:存储网页的示例表的一部分。行名称是一个反向URL。“内容”列族包含页面内容,“锚点”列族包含引用页面的任何锚定的文本。CNN的主页被体育画报和MY-look主页引用,因此该行包含名为anchor:cnnsi.com和anchor:MY.look.ca的列。每个锚单元有一个版本;“内容”列有三个版本,分别为时间戳t3、t5和t6
在研究了一个类似bigtable的系统的各种潜在用途之后,我们确定了这个数据模型。作为推动我们的一些设计决策的一个具体例子,假设我们想要保存一个可供许多不同项目使用的大量网页和相关信息的副本;让我们把这个特殊的表称为Webtable。在Webtable中,我们将URL用作行键,将web页面的各个特性作列名,并在获取的web页面内容存储在时间戳下的contents:column单元中,如图1所示。
行
表中的行键是任意字符串(目前最大为64KB,但对于大多数用户来说,10-100字节是一个典型的大小)。在单行键下读取或写入的每一个数据都是原子的(无论该行中读取或写入的不同列的数量如何),这是一种设计决策,使客户端更容易在同一行出现并发更新时推断系统的行为。
Bigtable按行键按字典顺序维护数据。表的行范围是动态分区的。每行范围称为tablet,它是分布和负载平衡的单位。因此,短行范围的读取是有效的,通常只需要与少量机器进行通信。客户端可以通过选择其行键来利用此属性,以便为数据访问获得良好的局部性。例如,在Webtable中,通过反转URL的master名组件,将同一域中的页面分组到连续行中。例如,我们将maps.google.com/index.html的数据存储在键com.google.maps/index.html下。将来自同一域的页面彼此相邻地存储可以使某些master和域分析更加高效。
列族
列键被分组到称为列族的集合中,这些集合构成访问控制的基本单元。一个列族中存储的所有数据通常都是相同类型的(我们一起压缩同一列族中的数据)。必须先创建列族,然后才能在该族中的任何列键下存储数据;创建族后,可以使用族中的任何列键。我们的目的是使表中不同列族的数量少(最多数百个),并且族在操作过程中很少发生变化。相反,一个表可能有无限多的列。
列键使用以下语法命名:family:qualifier。列族名称必须可打印字符组成,但限定符qualifier可以是任意字符串。Webtable的一个示例列族是language,它存储编写网页时使用的语言。我们在语言族中只使用一个列键,它存储每个网页的语言ID;该族中的每个列键表示一个锚定,如图1所示。限定符是引用站点的名称;单元格内容是链接文本。
访问控制、磁盘和内存记帐、权限管理都是在列族级别执行的。在我们的Webtable示例中,这些访问控制允许我们管理几种不同类型的应用程序:一些添加新的基础数据,一些读取基础数据并创建派生列族,还有一些只允许查看现有数据(出于隐私原因,甚至可能不查看所有现有族)。
时间戳
Bigtable中的每个单元格可以包含相同数据的多个版本;这些版本通过时间戳进行索引。Bigtable时间戳是64位整数。它们可以由Bigtable分配,在这种情况下,它们以微秒表示“实时”,也可以由客户端显式分配应用。
需要避免冲突的应用程序必须自己生成唯一的时间戳。单元格的不同版本以递减的时间戳顺序存储,以便可以首先读取最新版本。
为了使版本化数据的管理不那么繁重,对于每列族我们支持两个设置,这些设置告诉Bigtable自动对单元格版本如何进行垃圾收集:客户端可以指定只保留单元格的最后n个版本,或者只保留足够新的版本(例如,只保留在过去七天内写入的值)。
在我们的Webtable示例中,我们将存储在contents:列中的已爬网页面的时间戳设置为这些页面版本实际被爬网的时间。上面描述的垃圾收集机制允许我们只保留每个页面的最新三个版本。
3. API
Bigtable API提供用于创建和删除表和列族的函数。它还提供了更改集群、表和列族元数据(如访问控制权限)的功能。
客户端应用程序可以写入或删除Bigtable中的值,从单个行中查找值,或者迭代表中的数据子集。图2显示了使用ROGRAMION抽象来执行一系列更新的C++代码。(为了简短起见,省略了不相关的细节。)调用Apply对Webtable执行原子更新:它向www.cnn.com添加一个锚,并删除另一个锚。
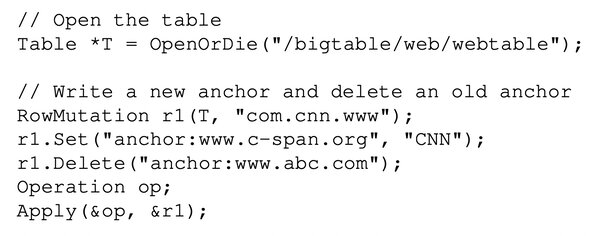
图2:写入Bigtable。
图3显示C++代码,它使用扫描仪抽象来迭代特定行中的所有锚。客户端可以迭代多个列族,并且有几种机制限制扫描产生的行、列和时间戳。例如,我们可以将上述扫描限制为仅生成列与正则表达式anchor:*.cnn.com匹配的锚,或仅生成时间戳在当前时间10天内的锚。
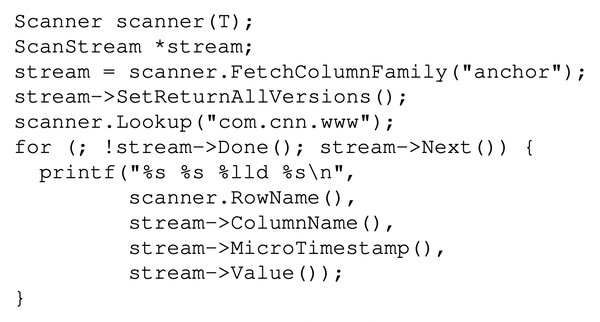
图3:从Bigtable读取数据。
Bigtable支持其他一些功能,允许用户以更复杂的方式操作数据。首先,Bigtable支持单行事务,可用于对存储在单行键下的数据执行原子读-修改-写序列。Bigtable目前不支持跨行键的常规事务,尽管它提供了一个在客户端跨行键批处理写入的接口。其次,Bigtable允许将单元格用作整数计数器。最后,Bigtable支持在服务器的地址空间中执行客户端提供的脚本。这些脚本是用谷歌为处理数据而开发的一种称为Sawzall[28]的语言编写的。目前,我们基于Sawzall的API不允许客户端脚本写回Bigtable,但它允许各种形式的数据转换、基于任意表达式的过滤以及通过各种操作符进行摘要。
Bigtable可以与MapReduce[12]一起使用,MapReduce[12]是一个运行Google开发的大规模并行计算的框架。我们已经编写了一组包装器,允许将Bigtable用作MapReduce作业的输入源和输出目标。
4. 构建块
Bigtable是建立在其他几个Google基础设施上的。Bigtable使用分布式Google文件系统(GFS)[17]存储日志和数据文件。Bigtable集群通常在运行各种其他分布式应用程序的机器共享池中运行,而Bigtable进程通常与其他应用程序的进程共享同一台机器。Bigtable依赖集群管理系统来调度作业、管理共享机器上的资源、处理机器故障和监视机器状态。
Google SSTable文件格式在内部用于存储Bigtable数据。SSTable提供从键到值的持久、有序的不可变映射,其中键和值都是任意字节字符串。提供的操作用于查找与指定键关联的值,并在指定键范围内迭代所有键/值对。在内部,每个SSTable包含一系列块(通常每个块的大小为64KB,但这是可配置的)。块索引(存储在SSTable末尾)用于定位块;打开SSTable时,索引将加载到内存中。可以使用单个磁盘搜索执行查找:我们首先通过在内存索引中执行二进制搜索来查找适当的块,然后从磁盘读取适当的块,或者SSTable可以完全映射到内存中,这允许我们在不接触磁盘的情况下执行查找和扫描。
Bigtable依赖于名为Chubby[8]的高可用性和持久性分布式锁服务。一个Chubby服务由五个活动副本组成,其中一个被选为主副本并主动服务于请求。当大多数副本都在运行并且可以相互通信时,该Chubby服务处于活动状态。Chubby使用Paxos算法[9,23]在出现故障时保持其副本的一致性。Chubby提供了一个由目录和小文件组成的名称空间。每个目录或文件都可以用作锁,对文件的读写是原子操作。Chubby客户端库提供了对Chubby文件的一致缓存,每个Chubby客户端维护一个会话来使用Chubby服务。如果客户端的会话无法在租约到期时间内续订其会话租约,则该客户端的会话将到期,当客户端会话过期时,它将丢失所有锁和打开的句柄。Chubby客户端还可以在Chubby文件和目录上注册回调,以通知更改或会话过期。
Bigtable使用Chubby执行各种任务:确保在任何时候最多有一个活动master主服务器;存储Bigtable数据的引导(bootstrap)位置(见第5.1节);发现分区表(tablet)服务器并最终确定分区表(tablet)服务器死亡(见第5.2节);存储Bigtable元数据信息(每个表的列族信息);和存储访问控制列表。如果Chubby服务持续一个时间段不可用,则Bigtable将不可用。我们最近在14个大型集群中测量了这种效应,这些集群跨越11个Chubby实例。Bigtable服务器服务期间,Bigtable中存储的某些数据由于Chubby不可用而不可用(由Chubby不可用的停机或网络问题引起)的平均百分比为0.0047%。受Chubby的不可用性影响最大的单个集群的百分比为0.0326%。
5. 实施
Bigtable实现有三个主要组件:一个链接到每个客户端的库、一个主服务器和多个tablet服务器。可以从集群中动态添加(或删除)tablet服务器,以适应工作负载的变化。
master负责将tablet分配给tablet服务器,检测tablet服务器的添加和过期,平衡tablet服务器负载,并对GFS中的文件进行垃圾收集。此外,它还处理元数据(schema)更改,例如创建表和列族。
每个tablet服务器管理一组tablet(通常我们每个tablet服务器有10到1000个tablet)。tablet服务器处理对已加载tablet的读写请求,并拆分过大的tablet。
与许多单master分布式存储系统一样[17,21],客户端数据不会通过master移动:客户端直接与tablet服务器进行读写通信。由于Bigtable客户端不依赖master获取tablet位置信息,因此大多数客户端从不与master通信。因此,在实践中,master服务器的负载很轻。
Bigtable集群存储许多表。每个表由一组tablet组成,每个tablet包含与行范围相关的所有数据。最初,每张桌子只包含一个tablet。随着表格的增长,它会自动拆分为多个tablet,默认情况下每个tablet的大小约为100-200 MB。
5.1 tablet位置
我们使用类似于B+-tree[10]的三级层次结构来存储tablet位置信息(图4)。
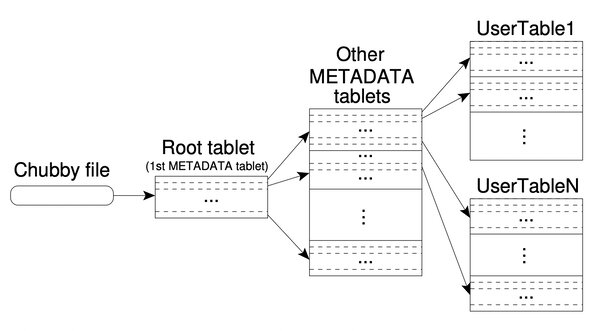
图4:tablet位置层次结构。
第一级是存储在Chubby中的文件,其中包含根tablet的位置。根tablet包含一个特殊METADATA表,表中存储所有tablet的位置。每个METADATA元数据tablet都包含一组用户tablet的位置。根tablet只是METADATA元数据表中的第一个tablet,但这个第一个tablet经过特殊了处理,不可拆分,以确保tablet位置层次结构不超过三个级别。
METADATA元数据表在行键下存储tablet的位置,行键是tablet表标识符和其结束行的编码。每个METADATA元数据行在内存中存储大约1KB的数据。对于128MB元数据tablet的适度限制,我们的三级定位scheme方案足以寻址2的34次方个tablet(或128MB的tablet中,2的61次方个字节)。
客户端库缓存tablet位置。如果客户端不知道tablet的位置,或者发现缓存的位置信息不正确,则会递归地向上移动tablet位置层次结构。如果客户端缓存为空,则定位算法需要三次网络往返,包括一次从Chubby读取。如果客户端的缓存过时,定位算法可能需要多达六次往返,因为过时的缓存条目只有在未命中时才会被发现(假设元数据tablet不会频繁移动)。虽然tablet位置存储在内存中,因此不需要GFS访问,但我们通过让客户端库预取tablet位置,进一步降低了这种常见情况下的成本:它在读取METADATA元数据表时读取多个tablet的元数据。
我们还将次要信息存储在METADATA元数据表中,包括与每个tablet相关的所有事件的日志(例如服务器开始为其提供服务时)。此信息有助于调试和性能分析。
5.2 tablet分配
每个tablet一次分配给一个tablet服务器。master会跟踪一组在线tablet服务器,以及tablet当前分配给tablet服务器的情况,包括哪些tablet未分配。如果tablet未分配,且有足够空间放置tablet的tablet服务器可用,则master会通过向tablet服务器发送tablet加载请求来分配tablet。
Bigtable使用Chubby跟踪tablet服务器。当tablet服务器启动时,它会在特定的Chubby目录中创建并获取一个唯一命名的文件的独占锁。master监控此目录(服务器目录)以发现tablet服务器。如果tablet服务器失去其独占锁,则会停止为其tablet提供服务:例如,由于网络分区导致服务器失去其Chubby的会话。(Chubby提供了一种有效的机制,允许tablet服务器检查其是否仍然持有其锁,而不会引起网络流量。)只要文件仍然存在,tablet服务器就会尝试重新获取其文件的独占锁。如果该文件不再存在,那么tablet服务器将无法再次提供服务,因此它会自杀。每当tablet服务器终止时(例如,因为群集管理系统正在将tablet服务器的机器从群集中移除),它都会尝试释放其锁,以便master更快地重新分配其tablet。
master负责检测tablet服务器何时不再为其tablet提供服务,并尽快重新分配这些tablet。为了检测tablet服务器何时不再为其tablet提供服务,master会定期询问每个tablet服务器其锁的状态。如果tablet服务器报告其已丢失锁,或者如果master在最近几次尝试中无法访问服务器,则master将尝试获取服务器文件的独占锁。如果master能够获取锁,则Chubby处于活动状态,tablet服务器要么已死亡,要么无法到达Chubby,因此master通过删除其服务器文件确保tablet服务器不再服务。一旦服务器的文件被删除,master可以将以前分配给该服务器的所有tablet移动到未分配tablet集中。为了确保Bigtable集群不易受到master和Chubby之间的网络问题的攻击,如果其Chubby会话过期,master将自杀。但是,如上所述,master故障不会改变tablet对tablet服务器的分配。
当群集管理系统启动master时,它需要先发现当前的tablet分配,然后才能更改这些分配。master在启动时执行以下步骤。(1) 主程序在Chubby中获取一个唯一的主锁,防止并发主程序实例化。(2)主服务器扫描Chubby中的servers目录以查找活动服务器。(3)master与每个在线tablet服务器通信,以发现哪些tablet已分配给每个服务器。(4)master扫描元数据表以了解tablet集。每当此扫描遇到尚未分配的tablet时,master会将该tablet添加到未分配的tablet集中,从而使该tablet符合tablet分配的条件。
一个复杂的问题是,在分配元数据tablet之前,无法扫描元数据表。因此,在开始此扫描(步骤4)之前,如果在步骤3中未发现根tablet的分配,则master会将根tablet添加到未分配tablet的集合中。此添加操作确保将分配根tablet。因为根tablet包含所有元数据tablet的名称,所以master在扫描根tablet后会知道所有这些名称。
只有在创建或删除表、合并两个现有tablet以形成一个较大的tablet或将一个现有tablet拆分为两个较小的tablet时,现有tablet集才会更改。master能够跟踪这些更改,因为它会启动除最后一个之外的所有更改。tablet拆分经过特殊处理,因为它们是由tablet服务器启动的。tablet服务器通过在元数据表中记录新tablet的信息来提交拆分。当拆分已提交时,它会通知master。如果拆分通知丢失(可能是因为tablet服务器或master死亡),master会在请求tablet服务器加载已拆分的tablet时检测到新tablet。tablet服务器将通知master拆分,因为它在元数据表中找到的tablet条目将只指定master要求其加载的tablet的一部分。
5.3 tablet服务
tablet的持续状态存储在GFS中,如图5所示。更新提交日志到记录重做(回放)日志的日志服务器中。在这些更新中,最近提交的更新记录存储在内存中一个称为memtable的排序缓冲区中;较旧的更新记录存储在一系列SSTables中。要恢复tablet,tablet服务器从METADATA元数据表中读取其元数据。
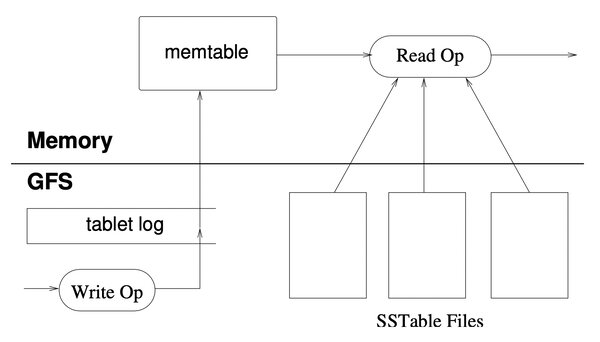
图5:tablet表示
此元数据包含由tablet和一组回放日志组成的SSTables列表,它们是指向任何可能包含tablet数据的提交日志的指针。服务器将SSTables的索引读取到内存中,并通过执行自回放点以来提交的所有更新来重建memtable。
当写入操作到达tablet服务器时,服务器会检查其格式是否正确,以及发送方是否有权执行该操作。授权是通过从一个Chubby的文件(几乎总是Chubby的客户端缓存中命中的文件)中读取允许写入程序的列表来执行的。将有效的更新写入提交日志。批量提交用于提高大量小更新的吞吐量[13,16]。提交写操作后,其内容将插入memtable。
当读取操作到达tablet服务器时,同样会检查其格式是否正确以及授权是否正确。在SSTables序列和memtable的合并视图上执行有效的读取操作。由于SSTABLE和memtable是按字典顺序排序的数据结构,因此可以高效地形成合并视图。
在拆分和合并tablet时,传入的读写操作可以继续,不会阻断。
5.4 数据压缩
随着写操作的执行,memtable的大小会增加。当memtable大小达到阈值时,memtable将被冻结,并创建新的memtable,冻结的memtable将转换为SSTable并写入GFS。这一小型压缩过程有两个目标:它减少tablet服务器的内存使用,并减少在恢复过程中,比如该服务器死机,必须从提交日志读取的数据量。在压缩发生时,传入的读写操作可以继续。
每一个小型压缩创建一个新的SSTable。如果此行为继续未经检查,则读取操作可能需要合并来自任意数量SSTable的更新。相反,我们通过在后台定期执行合并压缩来限制此类文件的数量。合并压缩读取几个SSTable和memtable的内容,并写出到一个新的SSTable。压缩完成后,可以立即丢弃这些输入SSTables和memtable。
将所有SSTable重写为一个SSTable的合并压缩称为主压缩。非主压缩生成的SSTable会包含一些特殊的删除项,这些删除项会抑制仍处于活动状态的旧SSTable的数据删除。另一方面,主压缩会生成不包含删除信息或删除数据的SSTable。Bigtable循环使用其所有tablet,并定期对其应用主要压缩。这些主要的压缩允许Bigtable回收被删除数据使用的资源,还允许它确保被删除的数据及时从系统中消失,这对于存储敏感数据的服务非常重要。
6. 设计改进
上一节中描述的实现需要许多改进,以实现用户所需的高性能、可用性和可靠性。本节更详细地描述了实现的各个部分,以突出这些改进。
本地组
客户端可以将多个列族组合到一个局部性组中。为每个tablet中的每个本地组生成一个单独的SSTable。将通常不一起访问的列族分离到单独的局部性组中可以实现更高效的读取。例如,Webtable中的页面元数据(如语言和校验和)可以位于一个本地组中,而页面内容可以位于另一个组中:希望读取元数据的应用程序不需要读取所有页面内容。
此外,可以基于每个本地组指定一些有用的调优参数。例如,可以将本地组声明为在内存中。内存中本地组的SSTables延迟加载到tablet服务器的内存中。加载后,可以读取属于此类本地组的列族,而无需访问磁盘。此功能对于频繁访问的小块数据非常有用:我们在内部将其用于元数据表中的位置列族。
压缩
客户端可以控制是否压缩本地组的SSTables,如果是,以及使用哪种压缩格式。用户指定的压缩格式应用于每个SSTable块(其大小可通过特定于本地组的调优参数控制)。虽然我们单独压缩每个块会损失一些空间,但我们的优势在于可以读取SSTable的一小部分,而无需解压缩整个文件。许多客户端使用双通道自定义压缩方案。第一个过程使用Bentley-McIlroy的方案[6],该方案在一个大窗口上压缩长的公共字符串。第二步使用快速压缩算法,在一个16KB的小数据窗口中查找重复。这两种压缩过程都非常快,在现代机器上,它们的编码速度为100–200 MB/s,解码速度为400–1000 MB/s。
尽管我们在选择压缩算法时强调速度而不是空间缩减,但这种两次压缩方案的表现令人惊讶地好。例如,在Webtable中,我们使用此压缩方案存储网页内容。在一个实验中,我们将大量文档存储在一个压缩的本地组中。为了实验的目的,我们将每个文档限制为一个版本,而不是存储所有可用的版本。该方案在空间上实现了10比1的缩减。这比HTML页面上典型的Gzip减少3:1或4:1要好得多,因为Webtable行的布局方式是:来自同一个主机的所有页面都彼此靠近存储。这使得Bentley-McIlroy算法能够识别来自同一主机的页面中的大量共享样板文件。许多应用程序(不仅仅是Webtable)选择它们的行名称,以便相似的数据最终聚集在一起,从而实现非常好的压缩比。当我们在Bigtable中存储相同值的多个版本时,压缩比会更好。
为读取性能提升建立缓存
为了提高读取性能,tablet服务器使用两级缓存。扫描缓存是一种更高级别的缓存,用于缓存SSTable接口返回给tablet服务器代码的键值对。块缓存是一个较低级别的缓存,用于缓存从GFS读取的SSTables块。扫描缓存对于倾向于重复读取相同数据的应用程序最为有用。块缓存对于倾向于读取与其最近读取的数据接近的数据的应用程序非常有用(例如,连续读取,或随机读取热行中同一局部性组中的不同列)。
布隆过滤器
如第5.3节所述,读取操作必须读取构成tablet状态的所有SSTables。如果这些SSTables不在内存中,我们可能会进行许多磁盘访问。通过允许客户端指定应该为特定本地组中的SSTables创建Bloom筛选器[7],我们减少了访问次数。Bloom过滤器允许我们询问SSTable是否包含指定行/列对的任何数据。对于某些应用程序,用于存储Bloom筛选器的以占用少量tablet服务器内存为代价,可大大减少读取操作所需的磁盘查找次数。我们对Bloom过滤器的使用还意味着对不存在的行或列的大多数查找不需要接触磁盘。
提交日志实现
如果我们将每个tablet的提交日志保存在一个单独的日志文件中,将有大量文件同时写入GFS中。根据每个GFS服务器上的底层文件系统实现,这些写入操作可能会导致大量磁盘请求写入不同的物理日志文件。此外,每个tablet都有单独的日志文件也会降低组提交优化的效率,因为组往往更小。为了解决这些问题,我们将更新添加到每个tablet服务器的单个提交日志文件中,在同一物理日志文件中混合不同tablet的更新[18,20]。
在正常操作期间使用一个日志文件可以显著提高性能,但会使恢复变得复杂化。当tablet服务器死亡时,它所服务的tablet将被移动到大量其他tablet服务器上:每台服务器通常装载少量原始服务器的tablet。要恢复tablet的状态,新tablet服务器需要从原始tablet服务器编写的提交日志中重新执行该tablet的变更。然而,这些tablet的更新被混合在同一个物理日志文件中。一种方法是让每个新的tablet服务器读取这个完整的提交日志文件,并只应用它需要恢复的tablet所需的条目。然而,在这种方案下,如果100台机器从故障的tablet服务器上分别分配一个tablet,那么日志文件将被读取100次(每台服务器读取一次)。
我们通过首先按照键<table,row name,log sequence number>的顺序对提交日志项进行排序来避免重复日志读取。在排序的输出中,特定tablet的所有更新都是连续的,因此可以通过一次磁盘搜索和一次顺序读取来高效读取。为了并行排序,我们将日志文件划分为64MB的段,并在不同的tablet服务器上并行排序每个段。此排序过程由master协调,并在tablet服务器指示需要从某个提交日志文件恢复更新时启动。
将提交日志写入GFS有时会因各种原因导致性能问题(例如,GFS服务器涉及的写入崩溃,或为到达特定的三台GFS服务器而穿越的网络路径正遭受网络拥塞,或负载过重)。为了保护更新免受GFS延迟峰值的影响,每个tablet服务器实际上有两个日志写入线程,每个线程都写入自己的日志文件;一次只能使用这两个线程中的一个。如果对活动日志文件的写入执行得很差,则日志文件写入将切换到另一个线程,并且提交日志队列中的更新将由新的活动日志写入线程写入。日志条目包含序列号,以允许恢复过程删除此日志切换过程产生的重复条目。
加速tablet恢复
如果master将tablet从一个tablet服务器移动到另一个tablet服务器,则源tablet服务器首先会对该tablet进行一次小压缩。此压缩通过减少tablet服务器提交日志中未压缩状态的数量来缩短恢复时间。完成此压缩后,tablet服务器将停止为tablet提供服务。在实际卸载tablet之前,tablet服务器会执行另一次(通常是非常快的)次要压缩,以消除在执行第一次小压缩时到达的tablet服务器日志中任何剩余的未压缩状态。完成第二次小型压缩后,tablet可以加载到另一台tablet服务器上,而无需恢复任何日志条目。
采用不变性设计
除了SSTable缓存之外,Bigtable系统的其他各个部分都被简化了,因为我们生成的所有SSTable都是不可变的。例如,在从SSTables读取时,我们不需要对文件系统的访问进行任何同步。因此,可以非常有效地实现对行的并发控制。读写操作都可以访问的唯一可变数据结构是memtable。为了减少memtable读取期间的争用,我们每个memtable行都是copy on write设计,并允许并行进行读取和写入。
由于SSTables是不可变的,永久删除已删除数据的问题将转化为垃圾收集过时的SSTables。每个tablet的SSTables都在METADATA元数据表中注册。master服务器删除过时的SSTables作为标记并在SSTables集合上清除垃圾收集[25],其中METADATA元数据表格包含根集合。
最后,SSTables的不变性使我们能够快速拆分tablet。我们不为每个子tablet生成一组新的SSTables,而是让子tablet共享父tablet的SSTables。
7. 性能评估
我们使用tablet服务器建立了一个Bigtable集群,以测量Bigtable的性能和可伸缩性。tablet服务器配置为使用1 GB内存,并写入由1786台机器组成的GFS单元,每台机器有两个400GB IDE硬盘驱动器。N个客户端计算机生成了用于这些测试的Bigtable负载。(我们使用与tablet服务器相同数量的客户端,以确保客户端永远不会成为瓶颈。)每台机器都有两个双核Opteron 2GHz芯片,足够的物理内存容纳所有运行进程的工作集,以及一个千兆以太网链路。这些机器被安排在一个两级树形交换网络中,根节点的总带宽约为100-200 Gbps。所有的机器都在同一个托管设施中,因此任何一对机器之间的往返时间都不到一毫秒。
tablet服务器和主服务器、测试客户端以及GFS服务器都在同一组机器上运行。每台机器都运行一台GFS服务器。一些机器还运行tablet服务器或客户端进程,或在这些实验的同时使用该池的其他作业的进程。
R是测试中涉及的Bigtable不同行键的数目。R的选择,使得每个基准测试在每个tablet服务器上读取或写入大约1 GB的数据。
顺序写入基准使用行键名为0到R−1。该行键空间被划分为10N个大小相等的范围。这些范围由一个中央调度程序分配给N个客户端,该调度程序在客户端完成处理分配给它的上一个范围后,立即将下一个可用范围分配给客户端。此动态分配有助于减轻客户端计算机上运行的其他进程导致的性能变化的影响。我们在每个行键下写了一个字符串。每个字符串都是随机生成的,因此不可压缩。此外,不同行键下的字符串是不同的,因此不可能进行跨行压缩。随机写基准测试与之类似,不同之处在于,行键在写入前立即以模散列,这样,在基准测试的整个持续时间内,写入负载大致均匀地分布在整个行空间中。
顺序读基准以与顺序写入基准完全相同的方式生成行键,但它不是在行键下写入,而是读取存储在行键下的字符串(该字符串是通过先前调用顺序写基准编写的)。类似地,随机读取基准跟踪随机写入基准的操作。
扫描基准与顺序读取基准类似,但使用Bigtable API提供的支持扫描特定行范围内的所有值。使用扫描可以减少基准测试执行的RPC数量,因为单个RPC从tablet服务器获取大量的值序列。
从内存随机读取基准与随机读取基准类似,但包含基准数据的本地组被标记为内存中,因此读取是从tablet服务器的内存中完成的,而不需要GFS读取。就这个基准而言,我们将每个tablet服务器的数据量从1GB减少到100MB,这样就可以轻松地存储在tablet服务器可用的内存中。
图6显示了在Bigtable中读取和写入1000字节值时,我们的基准性能的两个视图。表格显示了每个tablet服务器每秒的操作数;图表显示每秒的操作总数。
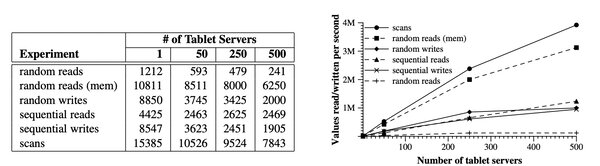
图6:1000字节值的每秒读/写次数。表格展示了每个tablet服务器操作数; 图表展示总操作数。
单tablet服务器性能
让我们先考虑只使用一个tablet服务器的性能。随机读取比所有其他操作慢一个数量级或更多。每次随机读取都涉及通过网络将64 KB SSTable块从GFS传输到tablet服务器,其中仅使用一个1000字节的值。tablet服务器每秒执行约1200次读取,这将转换为从GFS读取约75MB/s的数据。由于网络堆栈、SSTable解析和Bigtable代码中的开销,该带宽足以使tablet服务器CPU饱和,并且几乎足以使系统中使用的网络链路饱和。大多数具有这种访问模式的Bigtable应用程序将块大小减小到较小的值,通常为8KB。
从内存中随机读取的速度要快得多,因为从tablet服务器的本地内存中读取的每1000字节数据都能得到满足,而无需从GFS中获取一个大的64KB数据块。
随机写入和顺序写入的性能优于随机读取,因为每个tablet服务器都将所有传入写入附加到单个提交日志,并使用组提交将这些写入高效地流式传输到GFS。随机写入和顺序写入的性能没有显著差异;在这两种情况下,对tablet服务器的所有写入都记录在同一个提交日志中。
顺序读取的性能优于随机读取,因为从GFS获取的每个64KB SSTable块都存储到我们的块缓存中,用于服务接下来的64个读取请求。
扫描速度更快,因为tablet服务器可以返回大量值以响应单个客户端RPC,因此RPC开销会分摊到大量值上。
系统性能可扩展
随着我们将系统中的tablet服务器数量从1台增加到500台,总吞吐量显著增加,增幅超过100倍。例如tablet服务器数量增加500倍,内存随机读取的性能几乎增加了300倍。出现这种行为是因为此基准测试的性能瓶颈是单个tablet服务器CPU。
但是,性能并不是线性增长的。对于大多数基准测试,从1台tablet服务器到50台tablet服务器时,每台服务器的吞吐量会显著下降。这种下降是由多个服务器配置中的负载不平衡引起的,通常是由于其他进程争夺CPU和网络。我们的负载平衡算法试图处理这种不平衡,但由于两个主要原因无法完美的完成工作:重新平衡被限制以减少tablet的移动次数(tablet在移动时短时间内不可用,通常不到1秒),我们的基准测试产生的负载随着基准测试的进展而变化。
随机读取基准测试显示了最糟糕的扩展(服务器数量增加500倍时,总吞吐量仅增加100倍)。发生这种行为的原因是(如上所述),我们通过网络为每1000字节的读取传输一个64KB的大数据块。这种传输会使我们网络中的各种共享1GB链路饱和,因此,随着机器数量的增加,每台服务器的吞吐量会显著下降。
8. 实际应用
截至2006年8月,有388个非测试Bigtable集群在各种Google机器集群中运行,总共约有24500台tablet服务器。表1显示了每个集群tablet服务器的大致分布情况。其中许多集群用于开发目的,因此在相当长的一段时间内处于空闲状态。一组共有14个繁忙群集,总共有8069台tablet服务器,每秒的请求总量超过120万次,传入RPC流量约为741MB/s,传出RPC流量约为16GB/s。
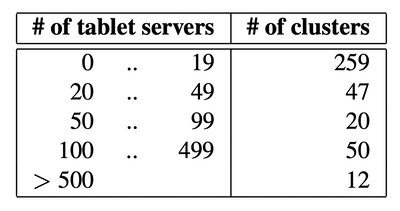
表1:Bigtable集群中tablet服务器数量的分布
表2提供了一些关于当前使用的一些表的数据。一些表存储提供给用户的数据,而另一些表存储用于批处理的数据;这些表在总大小、平均单元大小、从内存提供的数据百分比以及表模式的复杂性方面都有很大的差异。在本节的其余部分中,我们将简要介绍三个产品团队如何使用Bigtable。
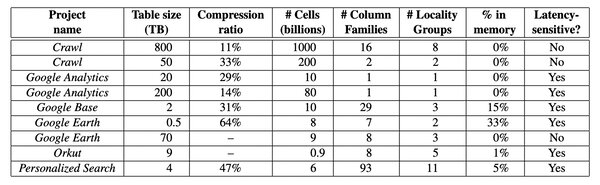
表2:生产中使用的一些表的特点。表格尺寸(压缩前测量)和#单元格表示近似尺寸。未为禁用压缩的表提供压缩比。
8.1 谷歌分析 Google Analytics
谷歌分析(Analytics.Google.com)是一项帮助网站管理员分析网站流量模式的服务。它提供了聚合统计数据,如每天不同的访问者的数量和每天每个URL的页面浏览量,以及网站跟踪报告,如浏览某个页面之后实现购买的用户百分比。
为了启用该服务,网站管理员在他们的网页中嵌入了一个小的JavaScript程序。无论何时访问页面,都会调用此程序。它会在Google Analytics中记录有关请求的各种信息,例如用户标识符和正在获取的页面信息。Google Analytics总结了这些数据,并将其提供给网站管理员。
我们简要介绍谷歌分析公司使用的两个表格。原始点击表(~200 TB)为每个最终用户会话维护一行。行名称是包含网站名称和会话创建时间的元组。此模式确保访问同一网站的会话是连续的,并且按时间顺序进行排序。这张表格压缩到原尺寸的14%。
摘要表(~20 TB)包含每个网站的各种预定义摘要。此表由定期计划的MapReduce作业从原始点击表生成。每个MapReduce作业都从原始点击表中提取最近的会话数据。整个系统的吞吐量受到GFS吞吐量的限制。这张表格压缩到原来尺寸的29%。
8.2 谷歌地球 Google Earth
谷歌运营着一系列服务,用户可以通过基于网络的谷歌地图界面(Maps.Google.com)和谷歌地球(Earth.Google.com)定制客户端软件访问世界表面的高分辨率卫星图像。这些产品允许用户在地球表面导航:他们可以以多种不同的分辨率平移、查看和注释卫星图像。该系统使用一个表来预处理数据,使用一组不同的表来服务客户端数据。
预处理管道使用一个表来存储原始图像。在预处理过程中,图像被清理并合并为最终的服务数据。此表包含大约70 TB的数据,因此由磁盘提供服务。图像已被有效压缩,因此禁用Bigtable压缩。
图像表中的每一行对应于单个地理段。命名行是为了确保相邻地理段彼此相邻存储。该表包含一个列族,用于跟踪每个段的数据源。此列族有大量列:基本上每个原始数据图像有一个列。由于每个片段仅由少数图像构建,因此此列族非常稀疏。
预处理管道严重依赖MapReduce over Bigtable来转换数据。在某些MapReduce作业期间,整个系统处理每个tablet服务器超过1 MB/秒的数据。
服务系统使用一个表来索引存储在GFS中的数据。此表相对较小(500 GB),但它必须以低延迟每秒为每个数据中心提供数万次查询。因此,此表托管在数百台tablet服务器上,并包含in-memory列族。
8.3 个性化搜索
个性化搜索(www.google.com/psearch)是一项选择性加入服务,它记录用户查询和点击谷歌的各种属性,如网络搜索、图像和新闻。用户可以浏览他们的搜索历史,重新访问他们以前的查询和点击,他们还可以根据谷歌的历史使用模式要求个性化的搜索结果。
个性化搜索将每个用户的数据存储在Bigtable中。每个用户都有一个唯一的userid,并被分配一个由该userid命名的行。所有用户操作都存储在一个表中。为每种类型的操作保留一个单独的列族(例如,有一个存储所有web查询的列族)。每个数据元素使用相应用户操作发生的时间作为其Bigtable时间戳。个性化搜索使用MapReduce over Bigtable生成用户配置文件。这些用户配置文件用于个性化实时搜索结果。
个性化搜索数据跨多个Bigtable集群进行复制,以提高可用性并减少由于距离客户端而导致的延迟。个性化搜索团队最初在Bigtable之上构建了一个客户端复制机制,以确保所有副本的最终一致性。现在使用内置于服务器中的复制子系统。
个性化搜索存储系统的设计允许其他组在自己的列中添加新的每用户信息,该系统现在被许多其他需要存储每用户配置选项和设置的Google属性使用。在多个组之间共享一个表会导致异常多的列族。为了帮助支持共享,我们在Bigtable中添加了一个简单的配额机制,以限制共享表中任何特定客户端的存储消耗;该机制在使用该系统存储每用户信息的各种产品组之间提供了一些隔离。
9. 教训
在设计、实现、维护和支持Bigtable的过程中,我们获得了有用的经验,并吸取了一些有趣的教训。
我们学到的一个教训是,大型分布式系统容易受到多种故障的影响,而不仅仅是许多分布式协议中假定的标准网络分区和故障停止故障。例如,我们已经看到了由以下所有原因导致的问题:内存和网络损坏、大时钟偏差、挂起的机器、扩展和不对称的网络分区、我们正在使用的其他系统中的错误(例如Chubby的)、GFS配额溢出,以及计划内和计划外的硬件维护。随着我们在这些问题上获得了更多的经验,我们通过改变各种协议来解决这些问题。例如,我们在RPC机制中添加了校验和。我们还通过消除系统的一部分对另一部分所做的假设来处理一些问题。例如,我们不再假设给定的Chubby操作只能返回一组固定错误中的一个。
我们学到的另一个教训是,重要的是推迟添加新功能,直到清楚如何使用新功能。例如,我们最初计划在API中支持通用事务。但是,因为我们没有立即使用它们,所以我们没有实现它们。现在,我们有许多实际的应用程序在Bigtable上运行,我们已经能够检查它们的实际需求,并发现大多数应用程序只需要单行事务。当人们请求分布式事务时,最重要的用途是维护二级索引,我们计划添加一个专门的机制来满足这一需求。新机制的通用性不如分布式事务,但效率更高(特别是对于跨数百行或更多行的更新),并且与乐观跨数据中心复制方案的交互效果更好。
我们从支持Bigtable中学到的一个实际教训是适当的系统级监控的重要性(即,监控Bigtable本身以及使用Bigtable的客户端进程)。例如,我们扩展了我们的RPC系统,因此对于一个RPC示例,它保留了代表该RPC执行的重要操作的详细跟踪。此功能允许我们检测并修复许多问题,例如tablet数据结构上的锁争用、提交Bigtable更新时对GFS的写入速度慢,以及在元数据tablet不可用时对元数据表的访问受阻。另一个有用的监视示例是,每个Bigtable集群都在Chubby中注册。这使我们能够跟踪所有集群,发现它们有多大,查看它们运行的软件版本,它们接收的流量,以及是否存在任何问题,例如意外的大延迟。
我们学到的最重要的一课是简单设计的价值。考虑到我们系统的大小(大约100000行非测试代码),以及代码以意想不到的方式随时间演化的事实,我们发现代码和设计的清晰性在代码维护和调试方面有着巨大的帮助。其中一个例子是我们的tablet服务器成员协议。我们的第一个协议很简单:master定期向tablet服务器发出租约,如果租约到期,tablet服务器就会自杀。不幸的是,该协议在出现网络问题时显著降低了可用性,并且对master恢复时间也很敏感。我们多次重新设计协议,直到我们有了一个性能良好的协议。然而,最终的协议过于复杂,并且依赖于其他应用程序很少使用的Chubby的特性的行为。我们发现,我们花了大量时间调试晦涩难懂的例外案例,不仅在Bigtable代码中,而且在Chubby代码中。最终,我们放弃了这个协议,转而使用一个新的更简单的协议,它完全依赖于广泛使用的Chubby特性。
10. 相关工作
Boxwood项目[24]的组件在某些方面与Chubby、GFS和Bigtable重叠,因为它提供了分布式协议、锁定、分布式块存储和分布式B树存储。在每一个有重叠的情况下,Boxwood的组件的目标都比相应的Google服务底层一些。Boxwood项目的目标是为构建更高级别的服务(如文件系统或数据库)提供基础设施,而Bigtable的目标是直接支持希望存储数据的客户端应用程序。
最近的许多项目都解决了通过广域网提供分布式存储或更高级别服务的问题,通常是在“互联网规模”上。这包括从CAN[29]、Chord[32]、Tapestry[37]和Pastry[30]等项目开始的分布式哈希表工作。这些系统解决了Bigtable不存在的问题,如高度可变的带宽、不受信任的参与者或频繁的重新配置;分散控制和拜占庭式容错不是大目标。
就可能提供给应用程序开发人员的分布式数据存储模型而言,我们认为分布式B树或分布式哈希表提供的键值对模型过于局限。键值对是一个有用的构建块,但它们不应该是提供给开发人员的唯一构建块。我们选择的模型比简单的键值对更丰富,并且支持稀疏的半结构化数据。尽管如此,它仍然非常简单,可以非常高效地表示平面文件,并且足够透明(通过本地组),允许用户调整系统的重要行为。
一些数据库供应商已经开发了能够存储大量数据的并行数据库。Oracle的Real Application Cluster数据库[27]使用共享磁盘存储数据(Bigtable使用GFS)和分布式锁管理器(Bigtable使用Chubby)。IBM的DB2并行版[4]基于类似于Bigtable的无共享[33]体系结构。每个DB2服务器负责存储在本地关系数据库中的表中的行子集。这两种产品都提供了完整的事务关系模型。
Bigtable Location Group实现了与使用基于列而非基于行的存储在磁盘上组织数据的其他系统类似的压缩和磁盘读取性能优势,包括C-Store[1,34]和商业产品,如Sybase IQ[15,36]、SenSage[31]、KDB+[22]和MonetDB/X100中的ColumnBM存储层[38]。AT&T的Daytona数据库是另一个将垂直和水平数据分割成平面文件并实现良好数据压缩比的系统[19]。局部性组不支持CPUcache级别的优化,如Ailamaki[2]所述。
Bigtable使用memtables和SSTables存储tablet更新的方式类似于日志结构的合并树[26]存储索引数据更新的方式。在这两种系统中,排序后的数据在写入磁盘之前都会缓冲在内存中,读取时必须合并内存和磁盘中的数据。
C-Store和Bigtable有许多共同的特点:两个系统都使用无共享体系结构,并具有两种不同的数据结构,一种用于最近的写入,另一种用于存储长期数据,并具有将数据从一种形式移动到另一种形式的机制。这些系统在API方面有很大的不同:C-Store的行为类似于关系数据库,而Bigtable提供了一个较低级别的读写接口,设计用于支持每台服务器每秒数千次这样的操作。C-Store也是一个“读优化关系DBMS”,而Bigtable在读密集型和写密集型应用程序上都提供了良好的性能。
Bigtable的负载平衡器必须解决无共享数据库(如[11,35])面临的一些相同类型的负载和内存平衡问题。我们的问题稍微简单一点:(1)我们不考虑相同数据的多重拷贝的可能性,可能是由于视图或索引的交替形式;(2)我们让用户告诉我们哪些数据属于内存,哪些数据应该留在磁盘上,而不是试图动态地确定这一点;(3)我们没有需要执行或优化的复杂查询。
11. 结论
我们已经描述了Bigtable,一个用于存储谷歌结构化数据的分布式系统。Bigtable集群自2005年4月开始投入生产使用,在此之前,我们在设计和实现上花了大约7个人年的时间。截至2006年8月,超过60个项目正在使用Bigtable。我们的用户喜欢Bigtable实现提供的性能和高可用性,他们可以通过简单地向系统添加更多的机器来扩展集群的容量,因为随着时间的推移,他们的资源需求会发生变化。
考虑到Bigtable不同寻常的接口,一个有趣的问题是我们的用户适应它有多困难。新用户有时不确定如何最好地使用Bigtable接口,特别是当他们习惯于使用支持通用事务的关系数据库时。然而,许多谷歌产品成功使用Bigtable的事实表明,我们的设计在实践中表现良好。
我们正在实施几个附加的Bigtable功能,例如支持辅助索引和基础架构,以构建具有多个主副本的跨数据中心复制的Bigtable。我们还开始将Bigtable作为服务部署到产品组中,这样各个组就不需要维护自己的集群。随着我们服务集群的扩展,我们需要在Bigtable本身中处理更多的资源共享问题[3,5]。
最后,我们发现在谷歌构建我们自己的存储解决方案有很大的优势。我们已经从为Bigtable设计自己的数据模型中获得了很大的灵活性。此外,我们对Bigtable实现的控制,以及Bigtable所依赖的其他Google基础设施,意味着我们可以消除性能瓶颈和低效。
---煤油灯科技victorlamp.com翻译整理---