摘要
基于 Transformer 的生成模型(Generative Model)近两年受到了很大的关注,最典型的例子就是 OpenAI 提出的拥有1700亿参数的 GPT-3 模型,基于 GPT-3 可以实现很多的任务,例如智能问答、文本生成等等。 为了能在真实的生产场景使用如此巨大的模型,一般会部署一个独立的推理服务(Inference Serving System),用于执行用户提交的推理任务,常见的Inference Serving系统包括NVIDIA 的 Triton Inference Server 以及 TensorFlow 的 TensorFlow Serving。用户可以通过 RPC 向这些 Serving System 提交请求,Serving System负责调度并执行这些请求,最终通过RPC向用户返回结果。
近几年也有大量的针对 Inference Serving System 的工作,在 Inference Serving System 中最典型的优化方式就是 Batching,也就是将一段时间内到达的用户请求合并到一起,提交到GPU中执行,从而提高系统的吞吐量。然而,与传统的 DNN Model 在推理时只要正向执行一遍不同,基于 Transformer 的 Generative Model 在推理时是迭代式的(Iterative),每个请求都需要迭代式执行多次,每次生成部分结果(一个 Token),且每个请求的迭代次数可能是不同的(例如迭代直到模型生成一个 End-Of-Sequence Token)。因此将现有的 Batching 方式应用在 Generative Model 时,可能导致有的请求已经迭代结束了,但是还需要和同Batch中没有迭代结束的请求继续一起执行。这个问题的核心在于,传统的 Batching 技术是以 Request 为粒度的,将多个 Request 绑定在一起提交给执行引擎,多个 Request 同时开始同时结束。当多个 Request 的计算过程一样时(例如传统CNN模型),以 Request 为粒度的 Batching 技术是合适的,但是在 Generative Model 中,不同 Request 执行过程是不同的(Iteration 的次数不同),因此需要一个新的 Batching 的方式,这也是本项工作核心的 Insight:使用更细粒度的,Iteration-level Batching,在每个 Iteration 中将不同的 Request 合并到一起。
1 介绍
语言生成任务对许多类型的应用程序越来越重要,例如聊天机器人、摘要代码生成和标题生成。此外,AI21实验室、DeepMind、谷歌、Meta platform、Microsoft、Microsoft & NVIDIA和OpenAI最近发表的研究报告称,每一个语言处理任务,包括翻译、分类、问答等,都可以看作是一个语言生成问题,并且在这个方向上已经有了很大的改进。生成模型的兴起并不局限于语言领域;AI社区也对其他领域(如图像、视频、语音或多个领域的混合)的生成问题产生了越来越多的兴趣。生成模型的核心在于Transformer架构及其变体,通过依赖注意力机制,Transformer模型可以学习到更好的表示,序列中的每个元素都可能与其他每个元素有直接联系,这在循环模型中是不可能的。
为了在实际应用中使用生成模型,我们经常将推理过程委托给一个独立的服务器来负责ML推理服务。该服务器应该为客户端请求提供低延迟和高吞吐量的推理结果,对该服务的需求日益增长,促进了推理服务系统的开发,如Triton inference Server和TensorFlow serving,这些系统可以使用单独开发的DNN执行引擎来执行实际的张量操作。例如,我们可以通过组合使用Triton和FastTransformer(一个为基于transformer的模型的推理优化的执行引擎)来部署语言生成任务的服务。在这种情况下,Triton主要负责将多个客户端请求分组成一个批处理,而FastTransformer从Triton接收批处理,并以批处理的方式进行推理过程。
不幸的是,我们注意到现有的推理系统,包括服务系统层和执行引擎层,在处理基于Transformer的生成模型的请求方面有局限性。由于这些模型被训练成以一种自回归的方式生成下一个令牌,人们应该以生成令牌的数量运行模型多次,而对于其他模型,如ResNet和BERT,一个请求可以通过运行模型一次来处理。也就是说,为了处理生成模型的请求,我们必须运行模型的多次迭代;每个迭代生成一个输出标记,它被用作下一个迭代的输入。这样的多重迭代特性对推理系统的当前设计提出了质疑,在推理系统中,服务系统按照请求的粒度安排引擎的执行。在此设计下,当服务系统向引擎发送一批请求时,引擎在处理完该批内的所有请求后,立即返回整个批的推理结果。由于不同的客户端请求可能需要不同的迭代次数来处理,因此在批处理中较早完成的请求无法返回到客户端,从而导致延迟增加。在分派批处理之后到达的请求也应该等待批处理,这可以显著增加请求的排队时间。
本文提出以迭代粒度代替请求粒度来调度引擎的执行。特别是,服务系统调用引擎来只运行批处理模型的单个迭代。因此,在只等待模型的一次迭代之后,可以考虑对新到达的请求进行处理。服务系统在每次从引擎返回后检查请求是否已经完成处理,因此完成的请求也可以立即返回给客户端。
然而,当我们试图同时应用批处理和迭代级调度时,一个明显的挑战出现了,与规范的请求级调度不同,建议的调度可以发出一批请求,其中每个请求到目前为止已经处理了不同数量的令牌。在这种情况下,对Transformer模型的请求不能以批处理的方式处理,因为注意机制需要非批处理张量操作,这些操作的输入张量根据处理的标记的数量具有不同的形状。
为了解决这个问题,我们建议只对一组选定的操作应用批处理,我们称之为选择性批处理。通过考虑操作的不同特征,选择性批处理拆分批处理,并分别处理Attention1操作的每个请求,同时将批处理应用于Transformer模型的其他操作。我们观察到,不批量执行Attention操作的决定对效率的影响很小。由于Attention操作与任何模型参数都不相关,所以通过在多个请求中重用已加载的参数,对Attention应用批处理并不能减少GPU的内存读取量。
基于这些技术,我们设计并实现了基于Transformer的生成模型的分布式服务系统ORCA。为了处理大规模模型,ORCA采用了包括层内模型并行化和层间模型并行化的并行化策略,这些策略最初是由Transformer模型训练系统开发的。我们还为提出的迭代级调度设计了一种新的调度算法,并额外考虑了内存管理和跨工人的流水线执行。
我们使用各种配置的OpenAI GPT-3模型评估ORCA,可扩展到341B参数。结果表明,ORCA的性能明显优于FastTransformer,在相同延迟水平下,吞吐量提高了36.9×。虽然我们在整个论文中使用语言模型作为驱动示例,并且只在语言模型上进行实验,但只要模型基于Transformer架构并使用自回归生成过程,其他领域的生成模型也可以从我们的方法中受益。
2 背景
我们提供了GPT推理过程的背景知识,GPT是我们在本文中使用的基于Transformer的生成模型的一个代表例子,以及ML推理服务系统。
- Inference procedure of GPTGPT推理过程。GPT是一个自回归语言模型,基于Transformer的一种架构变体。它接受文本作为输入,并生成新的文本作为输出。具体来说,模型接收一个输入标记序列,然后通过生成后续的输出标记来完成这个序列。图1a展示了一个简化的计算图,它用一个三层GPT模型表示这个过程,其中节点和边分别表示Transformer层和层之间的依赖关系。Transformer层是按照节点上的数字表示的顺序执行的,使用相同一组模型参数的节点(即表示同一层的节点)用相同的颜色填充。
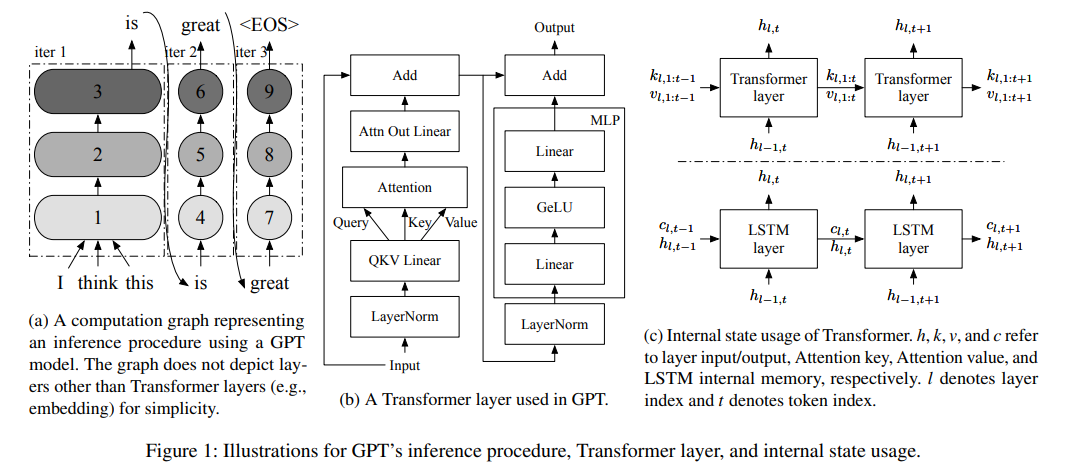
图1:GPT的推理过程、Transformer层和内部状态的使用说明。
生成的输出标记被反馈到模型中以生成下一个输出标记,实施一个顺序的、一个接一个的推断过程。这个生成单个标记的自回归过程是通过使用输入运行模型的所有层来完成的,该输入要么是来自客户机的输入标记序列,要么是先前生成的输出标记。我们将所有层的运行定义为模型的迭代。在图1a所示的示例中,推断过程包括三个迭代。第一次迭代(“iter 1”)一次接受所有输入标记(“I think this”)并生成下一个标记(“is”)。这个迭代组成了一个启动阶段,这个过程负责处理输入令牌并生成第一个输出令牌。接下来的两次迭代(“iter 2”和“iter 3”)组成了一个增量阶段,取前一次迭代的输出标记并生成下一个标记。在本例中,“iter 3”是最后一次迭代,因为它产生了“<EOS>;”,这是一个特殊的序列结束标记,用于终止输出生成。请注意,虽然增量阶段包括多个迭代(因为每个迭代只能处理单个令牌),但初始阶段通常通过并行处理所有输入令牌来实现为单个迭代。
原始的Transformer使用了两个Transformer层堆栈,而GPT的架构由单个层堆栈组成,即解码器。图1b显示了GPT中使用的Transformer层。在组成Transformer层的操作中,Attention是Transformer区别于其他架构的本质。在较高的层次上,Attention操作计算感兴趣的令牌的加权平均值,以便序列中的每个令牌都知道其他令牌。它需要三个输入:查询、键和值,计算查询(对于当前的令牌)与所有键(对于感兴趣的令牌)的点积,在点积上应用Softmax以获得权重,并对与权重相关的所有值进行加权平均。
由于Attention需要前面所有标记的键和值,我们认为键和值是内部状态,应该在多次迭代中维护。naïve无状态推断过程将接受序列中的所有标记(包括客户端提供的输入标记和迄今生成的输出标记),以在每次迭代中重新计算所有键和值。为了避免这种重新计算,fairseq建议增量解码,它保存键和值以便在后续迭代中重用。其他用于变压器的系统,如FastTransformer和Megatron--LM也有同样的功能。
图1c说明了Transformer的状态使用模式,以及维护内部状态的LSTM。主要的区别是,在Transformer中状态的大小(k表示Attention键,v表示value)随着迭代而增加,而在LSTM中状态的大小(c表示LSTM内存,h表示LSTM层的输入/输出)保持不变。当处理索引t处的标记时,注意操作将获取所有之前的注意键K ,1: 和值V ,1: 以及当前键K , 和值V , 因此,Attention操作应该根据已经处理的标记的数量对不同形状的张量执行计算。
在Attention操作之前,有层归一化操作(LayerNorm)和QKVLinear(线性和分割操作,以获取查询、键和值)。注意之后的操作依次为线性操作(Attn Out linear)、剩余连接的添加操作(add)、层归一化操作(LayerNorm)、多层感知器(MLP)操作和其他剩余连接操作(add)。
- ML inference serving systems ML推理服务系统。对ML驱动应用程序的需求不断增长,使得ML推断服务成为现代数据中心的关键工作负载。用户(最终用户或应用程序的内部微服务)向推断服务提交请求,服务使用其提供的资源,基于预定义的ML模型对请求进行响应,通常配备有专门的加速器,如GPU和TPU。特别是,该服务使用输入数据运行DNN模型,为请求生成输出。就像在数据中心上运行的其他服务一样,管理良好的推断服务应该在合理的成本范围内提供低延迟和高吞吐量。
为了满足这些约束,服务运营商经常使用ML推理服务系统,如Triton inference Server和TensorFlow serving。这些系统可以被看作是位于底层模型执行引擎(如TensorRT、TVM、TensorFlow等)之上的一个抽象,与各种ML模型、执行引擎和计算硬件无关。而服务系统将驱动主要数学操作的角色委托给引擎,负责公开接收推断请求的端点,调度引擎的执行,并向请求发送响应。相应地,这些系统关注的方面包括:批量执行、从多个模型变体中选择适当的模型、在同一设备上部署多个模型(每个模型用于不同的推断服务)等等。
在服务系统提供的特性和优化中,批处理是在使用GPU等加速器时实现高加速器利用率的关键。当我们在启用批处理的情况下运行执行引擎时,来自多个请求的输入张量在被提供给模型的第一个操作之前,会合并成一个单独的、大的输入张量。由于加速器更喜欢大的输入张量而不是小的,以更好地利用大量的并行计算单元,引擎的吞吐量高度依赖于批大小,即引擎一起处理的推理请求的数量。重用从片外内存加载的模型参数是批处理执行的另一个优点,特别是当模型涉及内存密集型操作时。
图2显示了使用现有服务系统和执行引擎为生成语言模型提供服务的总体工作流。服务系统(例如Triton)的主要组件是调度器,它负责通过从队列中检索请求来创建一批请求,并调度执行引擎(例如FastTransformer)来处理这些请求。执行引擎通过运行所服务的模型的多次迭代来处理接收到的批处理,并将生成的文本返回给服务系统。在图2中,服务系统调度引擎处理两个请求(x:“我想”,x:“我爱”),引擎分别对请求x 和x 生成“这很棒”和“你”。

图2:使用现有系统为生成语言模型服务的总体工作流程
3 挑战和建议的解决方案
在本节中,我们描述了服务于基于Transformer的生成模型的挑战,并提出了两种技术:迭代级调度和选择性批处理。
- C1: Early-finished and late-joining requests 早完成和晚加入的请求。现有系统的一个主要限制是,服务系统和执行引擎只有在:(1)服务系统在空闲的引擎上调度下一批;或者(2)引擎完成当前批次的处理。换句话说,这些系统被设计成按照请求粒度安排执行;引擎维护一批固定的请求,直到批处理中的所有请求完成。这在生成模型的服务中可能会有问题,因为批处理中的每个请求可能需要不同的迭代次数,导致某些请求比其他请求更早完成。在图3所示的示例中,尽管请求x 比请求x 早完成,但引擎在所有迭代中都对“活动”和“非活动”请求执行计算。对于非活动请求的额外计算(iter 3和4处为x )限制了批处理执行的效率。
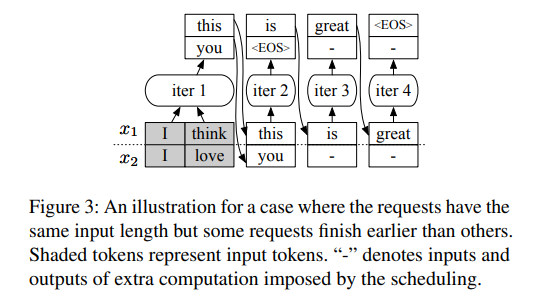
图3:一个示例,其中请求具有相同的输入长度,但有些请求比其他请求更早完成。阴影标记表示输入标记。" - "表示由调度施加的额外计算的输入和输出。
更糟糕的是,这种行为阻止了提前将完成的请求返回给客户端,造成了大量额外的延迟。这是因为引擎只在处理完批处理中的所有请求后才将执行结果返回给服务系统。类似地,当新请求在当前批处理执行过程中到达时,前面提到的调度机制会让新到达的请求等待,直到当前批处理中的所有请求都完成。我们认为目前的请求级调度机制不能有效地处理具有多迭代特性的工作负载。注意,这种早完成和晚加入请求的问题不会出现在语言模型的训练中;训练过程使用教师强迫技术在一次迭代中完成整个批的处理。
- S1: Iteration-level scheduling 迭代级调度。为了解决上述限制,我们建议在迭代的粒度上安排执行。在高层,调度程序重复如下过程:(1)选择接下来要运行的请求;(2)调用引擎对所选请求执行一次迭代;(3)接收预定迭代的执行结果。由于调度程序在每次迭代中都会收到一个返回,因此它可以检测请求是否完成,并立即将其生成的令牌返回给客户机。对于一个新到达的请求,在执行当前预定的迭代之后,请求有机会开始处理(例如,调度程序可以选择下一个运行的新请求),显著减少排队延迟。对于迭代级调度,调度器可以完全控制在每个迭代中处理多少请求和哪些请求。

图4:ORCA系统概述
图4描述了使用迭代级调度的系统架构和ORCA的整体工作流。ORCA公开一个端点(例如HTTPS或gRPC),推断请求到达系统,并发送对请求的响应。端点将新到达的请求放入请求池中,请求池是一个组件,用于在其生命周期内管理系统中的所有请求。池由调度器监控,调度器负责:从池中选择一组请求,调度执行引擎在该集合上运行模型的迭代,从引擎接收执行结果(即输出令牌),并通过将每个输出令牌附加到相应的请求来更新池。该引擎是执行实际张量操作的抽象,可以在分布在多台机器上的多个GPU上并行化。在图4所示的例子中,调度器①与请求池交互以决定下一个要运行的请求,➁调用引擎来运行四个选定的请求:(x , x , x , x )。调度程序向引擎提供第一次调度的请求的输入令牌。在本例中,x 和x 还没有运行任何迭代,因此调度程序交付x (x , x )和x (x , x , x )。引擎➂对这四个请求运行模型的迭代,➃返回生成的输出令牌(x 、x 、x 、x ),每个调度的请求对应一个。一旦请求完成处理,请求池将删除完成的请求,并通知端点发送响应。与图2中所示的方法不同,该方法应该在一个计划的批处理上运行多个迭代,直到批处理中的所有请求完成,ORCA的调度器可以在每次迭代中更改将处理哪些请求,我们在第4.2节中描述了如何在每次迭代中选择请求的详细算法。
- C2: Batching an arbitrary set of requests.C2:批处理任意一组请求。当我们尝试在实践中使用迭代级调度时,我们将面临的一个主要挑战是批处理。为了实现高效率,执行引擎应该能够以批处理的方式处理任何选定的请求集。如果没有批处理,人们将不得不逐一处理每个选择的请求,从而失去了GPU的大规模并行计算能力。
批处理仅适用于两个选择的请求处于相同的阶段,具有相同数量的输入令牌(在启动阶段)或具有相同的令牌索引(在递增阶段)。这一限制极大地降低了现实工作负载中批处理的可能性,因为调度程序应该希望同时存在两个符合批处理条件的请求。随着批处理大小的增加,这种可能性会以指数形式进一步降低,因此不可能使用能够在不影响延迟的情况下获得更好吞吐量的大批处理。
- S2: Selective batching S2:选择性批处理。我们提出了选择性批处理,这是一种批处理执行的技术,它允许以批处理的方式组合请求具有很高的灵活性。与通过“批处理”构成模型的所有张量操作来处理一批请求不同,这种技术选择性地只对少数操作应用批处理。
迭代级调度面临新的挑战:并非所有的请求都能在任意Iteration被Batching到一起。典型的问题就是Batching的Input需要有相同Shape(例如相同的 sequence length)。
为了解决这个问题,Orca 提出了第二点核心技术: Selective batching选择性批处理。这个技术的核心是:Transformer Layer里并非所有的算子都需要Batching的Input有相同的Shape,如下图5所示,Add,Linear,GeLU等算子在计算时可以将一个Batch进行Flatten,这样不同 Sequence Length 的Input也可以Batch到一起进行计算;而对于其他必须有相同Shape才能Batching的算子(例如Attention),则对不同的输入进行单独的计算。

图5:ORCA执行引擎在有选择的批处理请求上运行Transformer层。为了简单起见,我们只描述了QKV线性、注意和注意输出线性操作。
4 ORCA设计
基于上述技术,我们设计并实现了基于Transformer的生成模型的分布式服务系统ORCA。在描述图4时,我们已经讨论了ORCA的系统组件和整体执行模型。在本节中,我们回答了关于如何构建一个有效的系统,该系统可以扩展到具有数千亿参数的大规模模型的剩余问题。我们还描述了迭代级调度的调度算法,即如何在每次迭代时从请求池中选择一批请求。
4.1 分布式体系结构
最近的研究表明,可缩放的语言模型可以极大地提高模型的质量。因此,系统支持服务于这样的大型语言模型变得越来越重要,特别是当该模型不适合单个GPU时。在这种情况下,应该将模型参数与相应的计算分开,并将它们分布在多个GPU和机器上。
ORCA为Transformer模型组合了已知的并行化技术:层内并行和层间并行。FastTransformer也使用这两种模型并行策略,它们最初是为分布式训练而开发的。层内并行可以在多个GPU上分割矩阵乘法(即Linear和Attention运算)及其相关参数,我们省略了这个策略如何划分每个矩阵乘法的细节。另一方面,层间并行性将Transformer层划分到多个gpu上。ORCA为每个GPU分配相同数量的Transformer层。图6举例说明了对4层GPT模型的层内和层间并行性的应用。这4层被划分为2个层间分区,分区中的层又被细分为3个层内分区。我们将每个分区分配给一个GPU,总共使用6个GPU。
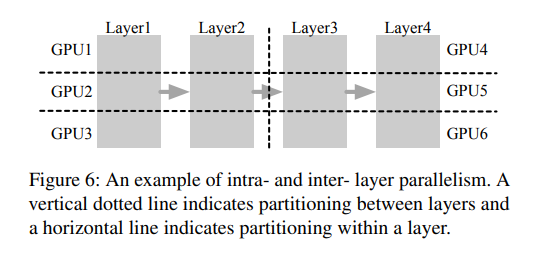
图6:层内和层间并行的一个例子。一条垂直虚线表示层之间的分区,一条水平线表示层内的分区。
ORCA执行引擎支持使用上述技术的分布式执行。图7描述了一个ORCA引擎的架构。每个辅助进程负责模型的层间分区,并且可以彼此放置在不同的机器上。特别是,每个worker管理一个或多个CPU线程,每个CPU线程专门用于控制GPU,其数量取决于层内平行度。
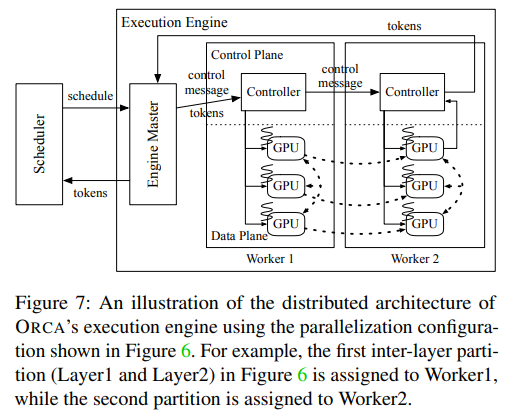
图7:使用并行化配置的ORCA执行引擎的分布式架构示意图
ORCA执行引擎的执行过程如下:一旦引擎被安排为运行一批请求的模型迭代,引擎主就会将收到的关于计划批处理的信息转发给第一个辅助进程(Worker1)。这些信息包括当前迭代的令牌和一个控制消息,该消息由批处理中的请求id、当前令牌索引(用于增量阶段的请求)和输入令牌数量(用于启动阶段的请求)组成。Worker1的控制器将从引擎主机接收到的信息传递给GPU控制线程,每个线程解析信息并将适当的GPU内核发送给相关的GPU。例如,Attention操作的内核使用请求id和当前令牌索引来获取之前被Attention K/V管理器保存的key和值的GPU内存地址。同时,控制器也将控制消息转发给下一个worker (Worker2)的控制器,而无需等待Worker1 gpu上发出的内核完成。与Worker1不同的是,最后一个worker (Worker2)的控制器等待(也就是同步)已发出的GPU内核的完成,以便为每个请求获取输出令牌,并将令牌发送回引擎主机。
为了使GPU尽可能地繁忙,我们设计了ORCA引擎来最小化CPU和GPU之间的同步。我们观察到,当前的分布式推理系统(例如,FastTransformer和Megatron-LM)在每个进程接收到控制消息5时具有CPU-GPU同步,因为它们通过一个GPU - GPU通信通道——NCCL交换消息。这些控制消息的交换发生在每次迭代中,造成不可忽略的性能开销。另一方面,ORCA分离了控制消息(加上令牌)和张量数据传输的通信通道,避免了对CPU使用的数据使用NCCL。图7显示ORCA引擎只使用NCCL来交换中间张量数据(用虚线箭头表示),因为这些数据是由GPU产生和消费的。控制消息,由CPU线程用于发布GPU内核,通过一个单独的通信通道在引擎主控制器和工作控制器之间发送,不涉及GPU,如gRPC。
4.2 调度算法
ORCA调度器在每次迭代中决定应该选择和处理哪些请求。调度器在选择一组请求组成一个批处理时具有很高的灵活性,这是因为选择性批处理技术允许引擎以批处理的方式运行任何一组请求,现在剩下的主要问题是如何在每次迭代中选择请求。
我们将ORCA调度器设计为使用一种简单的算法,该算法不改变客户端请求的处理顺序;提前到达的请求将更早地处理。也就是说,我们确保迭代级的先到先服务(FCFS)属性。我们为具有多重迭代特征的工作负载定义迭代级FCFS属性如下:对于请求池中的任何一对请求(x , x ),如果x 早于x 到达,x 应该运行与x 相同或更多的迭代。注意,如果延迟的请求需要较少的迭代来完成,那么一些延迟的请求可能会更早地返回给客户端。
不过,调度器还需要考虑其他因素:增加批处理大小的收益递减和GPU内存约束。增加批处理大小可以抵消增加的吞吐量和增加的延迟,但是随着批处理大小变大,返回的数量(即吞吐量的增加)会减少。因此,就像其他服务系统一样,ORCA也有一个最大批处理大小的概念:一个批处理中可能的最大请求数。
ORCA系统操作员可以调整这个旋钮,在满足延迟预算的同时最大化吞吐量。我们将在6.2节的实验结果中对此进行更详细的讨论。另一个因素是GPU内存限制。通过跨多个操作重用中间结果的缓冲区来优化内存使用,这是一个被各种系统使用的著名技术,ORCA也采用了这种技术。然而,与可以立即重用的中间结果缓冲区不同,Attention K/V管理器用于存储键和值的缓冲区不能被回收,直到ORCA调度器通知相应的请求已经完成处理。当调度器不能为池中的任何请求发出迭代时,naïve实现可以使调度器陷入死锁,因为没有空间为下一个令牌存储新的Attention键和值。这要求ORCA调度器知道为管理器预分配的内存区域的剩余大小。
ORCA调度器将所有这些因素都考虑在内:它根据到达时间选择最多“最大批处理大小”的请求,同时在第一次调度请求时为存储键和值预留足够的空间。我们在算法1中描述了调度过程。算法从请求池中选择一批请求(第4行),并调度一批请求(第5行)。Select函数(第17行)根据请求到达的时间从池中选择最多max_bs的请求(第20-22行)。算法1没有描述请求到达和返回的过程,可以认为存在将新到达的请求插入request_pool并将完成的请求从request_pool移除的并发线程。
当调度器在初始阶段考虑请求时,这意味着请求还没有被调度,调度器使用请求的max_tokens6属性预留GPU内存的max_tokens插槽,用于提前存储键和值(第23-26行)。调度器根据n_rsrv(当前保留槽的数量)确定是否可能保留(第25行),其中槽是由存储一个Attention键和单个令牌的值所需的内存量定义的。这里,n_slots是ORCA系统操作符调优的参数,表示分配给Attention K/V管理器的内存区域的大小(根据插槽)。由于请求中的令牌数量不能超过max_tokens,如果预留是可能的,则可以保证管理器可以为新生成的键和值分配缓冲区,直到请求完成。

算法1:ORCA调度算法
与max_bs调优需要量化延迟和吞吐量之间的权衡不同,ORCA系统操作符可以轻松配置n_slots,无需任何实验。给定一个模型规范(例如,隐藏大小,层数等)和层内和层间并行度,ORCA的GPU内存使用主要依赖于n_slots。也就是说,操作符可以简单地在内存约束下使用尽可能大的n_slots。
Pipeline parallelism 流水并行。ORCA的调度器使得引擎中的worker的执行通过流水线跨多个批处理进行,调度器不会等待一个已调度的批的返回,直到当前已调度的批的数量达到n_workers(算法1的第9-10行)。通过这样做,调度器保持引擎中并发运行的批的数量为n_workers,这意味着引擎中的每个worker都在处理一个批,而不是空闲。
图8a描绘了3个ORCA worker的执行管道,最大批处理大小为2。我们假设请求A在B之前到达,B在C之前到达,以此类推。首先,调度器根据到达时间选择请求A和B,并安排引擎处理一批请求A和B(我们称之为AB批),其中Worker1、Worker2和Worker3依次处理该批。只有在调度器注入另外两个批:CD和EF之后,调度器才等待批AB的返回。一旦AB批返回,请求A和B将再次被选择和调度,因为它们是池中最早到达的请求。

图8:在ORCA和FastTransformer中使用流水线并行的比较,其中是请求X的第i次迭代
相反,由于请求级调度,当前服务系统和执行引擎之间的接口(例如Triton和FastTransformer的组合)不允许在当前正在运行的批处理完成之前注入另一个批。也就是说,Triton在当前批AB完成之前不能将下一个请求C注入到FastTransformer。为了在这种约束下支持对多个层间分区的流水线执行,FastTransformer将一批请求分割为多个微批,并通过流水线跨微批执行分区。在图8b中,FastTransformer将批AB分成两个微批,A和B。由于每个分区以批处理的方式处理一个微批(比原来的批小),因此批处理带来的性能增益可能会变小。此外,当微批尺寸过大时,该方法可能会在管道中插入气泡,使微批数量小于分区数量。FastTransformer需要用批处理效率(更大的微批大小)换取流水线效率(更少的流水线气泡),而ORCA则不需要这样的权衡,这要感谢迭代级调度,并且可以轻松流水线请求,而不需要将一个批处理划分为微批。
5 实现
我们在CUDA的基础上,用13K行c++语言实现了ORCA。我们在ORCA引擎的控制平面使用gRPC进行通信,而在数据平面使用NCCL进行层间和层内通信。因为我们设计ORCA的重点是基于Transformer的生成模型,ORCA提供了流行的Transformer层作为模型的构建块,包括原始的编码器-解码器Transformer、GPT和Raffel等人讨论的其他变体。
我们还实现了LayerNorm、Attention和GeLU操作符的融合内核,就像其他用于Transformer模型训练或推理的系统一样。例如,将Attention查询与按键之间的点积计算、对点积的Softmax计算、Attention值的加权平均等过程融合到一个CUDA内核中,用于Attention算子。此外,我们更进一步,通过简单地连接用于不同请求的内核的所有线程块来融合split Attention操作符的内核。尽管这种融合使得内核中的线程块具有不同的特征和生存期(这通常被CUDA编程实践所劝阻),因为它们处理不同形状的张量,我们发现这种融合有利于提高GPU利用率和减少内核启动开销。
6 评估
在本节中,我们用评估结果来展示ORCA的效率。
- Environment环境。我们在Azure ND96asr A100 v4虚拟机上运行我们的评估,每个虚拟机配备8个通过NVLink连接的NVIDIA 40-GB A100 gpu。根据被测试模型的大小,我们最多使用4个vm。每个虚拟机拥有8个Mellanox 200Gbps HDR Infiniband适配器,提供1.6Tb/s的虚拟机间互连带宽。
- Models模型。在整个实验中,我们使用GPT作为基于Transformer的生成模型的代表例子。我们使用具有各种配置的GPT模型,如表1所示。13B和175B型号的配置来自GPT-3纸张。在这两个模型的基础上,我们改变了层数和隐藏大小,对101B和341B模型进行配置。所有型号的最大序列长度为2048,遵循原始文献的设置。我们使用fp16格式的模型参数和中间激活进行实验。我们还应用了4.1节中描述的层间和层内并行策略,除了可以容纳在GPU中的13B模型。例如,175B模型使用2个层间分区,再划分为8个层内分区,共划分16个GPU,同一个虚拟机中的8个GPU属于同一个层间分区。
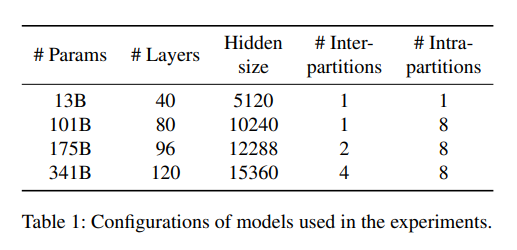
表1:实验中使用的模型配置。
- Baseline system 基线系统。我们比较了FastTransformer,这是一个通过分布式执行支持大规模Transformer模型的推理引擎。虽然也存在其他支持分布式执行的系统,如Megatron-LM和DeepSpeed,但这些系统主要是为训练工作负载设计和优化的,这使得它们的性能相对较低,与推理优化的系统。
- Scenarios场景。我们使用两个不同的场景来驱动我们的评估。首先,我们设计了一个微基准来单独评估ORCA引擎的性能,而不受迭代级调度的影响。特别地,我们在这个场景中不运行ORCA调度器。相反,给定一批请求,测试脚本会重复向ORCA引擎注入相同的一批请求,直到批处理中的所有请求完成,模仿规范请求级调度的行为。我们还假设批处理中的所有请求都有相同数量的输入标记,并生成相同数量的输出标记。我们报告处理批处理(而不是单个请求)所花费的时间,并将结果与FastTransformer进行比较。
第二个场景通过模拟工作负载来测试ORCA的端到端性能。我们合成了客户端请求的跟踪,因为生成语言模型没有公共可用的请求跟踪。合成跟踪中的每个请求都是通过对输入令牌的数量和max_gen_tokens属性进行抽样随机生成的,其中输入令牌的数量加上max_gen_tokens等于第4.2节中描述的max_tokens属性。我们假设所有请求都将继续生成,直到生成的令牌数量达到max_gen_tokens。换句话说,我们让模型永远不会发出“<EOS>;”令牌。这是因为我们既没有实际的模型检查点,也没有实际的输入文本,所以我们没有任何信息来猜测“<EOS>”令牌生成的正确时间。一旦生成了请求,我们就根据泊松过程设置请求到达时间来合成跟踪。为了评估ORCA在不同负载下的行为,我们改变泊松参数(即到达率),并相应地调整请求到达时间。我们使用从不同分布生成的多个跟踪报告延迟和吞吐量,以便更好地比较和理解ORCA和FastTransformer的行为。
6.1 引擎的微基准测试
我们首先使用第一种场景比较FastTransformer和ORCA引擎的性能,我们将批处理中的所有请求设置为具有相同数量的输入标记(32或128),并生成32个标记。也就是说,在这组实验中,批处理中的所有请求同时开始和完成处理。我们使用三种不同的模型进行实验:13B、101B和175B。对于每个模型,我们使用相应的并行化策略,如表1所示。
图9显示了用于处理由相同请求组成的批处理的FastTransformer和ORCA引擎的性能。在图9a中,ORCA引擎在所有配置中与Fasttransformer相比表现出类似(或略差)的性能。这是因为ORCA不对Attention操作应用批处理,而FastTransformer对所有操作应用批处理。不过,性能差异相对较小。尽管没有对Attention操作进行批处理,但由于Attention中没有模型参数,因此这个决策对效率的影响很小,因为跨多个请求重用模型参数没有任何好处。

图9b展示了101B模型的类似结果,该模型在单个VM中使用了所有8个GPU。从这些结果中,我们可以说ORCA引擎和FastTransformer在CUDA内核的实现和层内分区之间的通信方面具有相当的效率。注意,fasttransformer不能在13B模型中使用8或更大的批大小(在101B模型中是16或更大),因为每个请求的Attention键和值的预分配内存数量是固定的,它与模型的最大序列长度成比例增长(在这种情况下是2048)。相反,ORCA根据max_tokens属性为每个请求分别设置键和值的缓冲区大小,从而避免了冗余内存分配。
接下来,我们进一步使用175B模型进行实验,该模型将层分成两个层间分区。在本例中,为了更好地进行比较,我们禁用了两个系统的层间分区的流水线执行。对于FastTransformer,我们将微批大小设置为与批大小相等,以禁用流水线。如图9c所示,ORCA引擎的性能比fasttransformer高出47%。我们将这种性能的改进归功于4.1节中描述的控制数据平面分离。我们省略了341B模型,因为它与175B模型的结果相似。
6.2 端到端性能
现在,我们通过在不同负载下使用合成请求跟踪测量延迟和吞吐量来评估ORCA的端到端性能。在合成跟踪时,我们从U(32,512)采样每个请求的输入令牌数量,这是一个从32到512(包括在内)的均匀分布。带属性的max_gen_tokens从U(1128)采样,这意味着消耗时间最少的请求和消耗时间最多的请求分别需要1次和128次模型迭代来处理。
与第6.1节中所示的微基准测试不同,为了度量端到端性能,我们测试了包括ORCA调度器在内的整个ORCA软件栈。客户端请求按照上面描述的综合跟踪到达ORCA调度器。我们报告了各种最大批处理大小配置的结果。对于没有自己调度器的FastTransformer,我们实现了一个自定义调度器,它接收客户端请求,创建批处理,并将批处理注入到FastTransformer的实例中。我们通过从请求队列中获取最多批处理大小的请求来动态地创建批处理,这是Triton和TensorFlow serving等现有服务系统最常用的调度算法。同样,我们报告了各种最大批大小配置的结果,以及不同的微批大小,FastTransformer中一个控制流水线行为的额外旋钮(参见第4.2节)。
图10显示了端到端延迟和吞吐量的中值。由于跟踪中的每个请求都需要不同的处理时间,处理时间(大致)与生成的令牌数量成比例,因此我们报告的延迟中值是按每个请求生成的令牌数量标准化的。从图中,我们可以看到ORCA提供了比FastTransformer更高的吞吐量和更低的延迟。唯一的例外是低负载下的101B模型(图10a)。在这种情况下,ORCA和FastTransformer在批处理中都没有足够多的请求。也就是说,延迟主要取决于引擎的性能,如图9b所示。当负载变得更重时,ORCA以相对较小的延迟增加提供了更高的吞吐量,因为ORCA调度器会让延迟到达的请求与当前正在进行的批处理一起搭便车。相比之下,FastTransformer无法有效地处理(1)在不同时间到达的多个请求;(2)需要完成的迭代次数不同;或者(3)从不同数量的输入令牌开始,产生0.49请求/秒的峰值吞吐量和更高的延迟。如果我们使用使用多个层间分区的175B或341B模型(图10b和10c), ORCA在每个负载级别下的延迟和吞吐量都优于FastTransformer,当我们在类似的延迟级别上比较结果时,吞吐量会提高一个数量级。例如,为了匹配175B模型中190毫秒的标准化延迟中值,这是图9c中“orca(128)”标准化执行时间的两倍(根据生成的令牌数量),FasterTransformer提供了0.185请求/秒的吞吐量,而orca提供了6.81请求/秒的吞吐量,这是36.9倍的加速。

图10:按生成的令牌数量和吞吐量标准化的端到端延迟中值。
- Varying batch size configurations 不同的批大小配置。图10显示了ORCA的最大批处理大小的增加可以在不影响延迟的情况下获得更高的吞吐量。这是因为ORCA的迭代级调度解决了早完成和晚加入请求的问题。然而,对于任意硬件设置、模型和工作负载,不能保证增加批处理大小不会对延迟产生负面影响。如第4.2节所述,必须仔细设置最大批处理大小,同时考虑所需的延迟和吞吐量需求。
有趣的是,FastTransformer中的最大批处理大小不一定有助于提高吞吐量。通过测试所有模型在不同负载下的最大批大小(max_bs)和微批大小(mbs)的所有可能组合,我们发现(max_bs, mbs) =(1,1)或(8,8)是最佳选择。根据我们在4.1节的讨论,FastTransformer的基于微批处理的管道可能效率较低,因为引擎将以批处理的方式处理最多mbs数量的请求,这解释了为什么最大可能mbs(与max_bs相同)的配置比其他配置性能更好。此外,虽然由于批处理大小的增加,增加max_bs可以提高性能,但与此同时,这也增加了批处理请求的可能性,这些请求的输入令牌数量或生成的令牌数量存在较大差异。在这种情况下,FastTransformer不能有效地处理批处理,因为(1)在批处理的第一次迭代中,FastTransformer处理请求时,它们的输入长度与最短的请求相同;(2)早期完成的请求不能立即返回给客户端。
- Trace of homogeneous requests同类请求的跟踪。当使用同质请求跟踪时,我们测试ORCA和FastTransformer的行为,即跟踪中的所有请求都有相同数量的输入标记和相同的max_gen_tokens属性。由于所有请求都需要相同数量的迭代来完成处理,因此在此跟踪中不会出现提前离开请求的问题。因此,现在max_bs的增加对FastTransformer的性能有明显的积极影响,如图11所示。尽管如此,ORCA仍然优于FastTransformer (max_bs=8),除了使用最大批处理大小为1的情况,在这种情况下,ORCA退化为一个不执行批处理的ORCA worker的简单流水线。

图11:端到端延迟和吞吐量中值,使用由同构请求组成的跟踪175B模型。我们没有将延迟正常化,因为所有请求都具有相同的特征。
7 相关工作与讨论
- Fine-grained batching for recurrent models 用于循环模型的细粒度批处理。我们想强调BatchMaker作为最相关的以前的工作之一。BatchMaker是RNN的服务系统,它以RNN细胞的粒度执行调度和批处理,其动机是RNN具有重复相同计算的独特特性。一旦请求到达,BatchMaker将处理请求的数据流图分解到RNN单元中,以单元的粒度调度执行(而不是整个图),并批量执行相同的单元(如果有的话)。由于每个RNN细胞总是执行完全相同的计算,BatchMaker可以以批处理的方式执行多个RNN细胞,而不管细胞的位置(即标记索引)。通过这样做,BatchMaker允许一个新到达的请求RNN加入(或一个完成的请求离开)当前正在执行的批处理,而无需等待批处理完全完成。
但是,BatchMaker不能为Transformer模型批量生成单元,因为有太多不同的单元(为处理令牌封装计算的子图;图1c)。位于不同令牌索引t的每个单元格必须使用不同的注意键/值集。由于每个t的cell是不同的,所以这个图由L个不同的cell组成(L表示输入和生成的token的数量),这大大降低了在给定时刻相同计算的cell出现的可能性(例如,在图10中,L的范围是33 = 32+1到640 = 512+128)。因此,单元格的执行将主要是序列化的,使BatchMaker退回到非批处理执行。BatchMaker还缺乏对需要模型和管道并行性的大型模型的支持。
虽然BatchMaker是用于检测和对齐可批处理的RNN细胞,但我们在设计ORCA时的关键原则是在每一轮读取模型参数时尽可能多地执行计算。这是基于从GPU全局内存读取参数是大规模模型端到端执行时间的主要瓶颈这一观点。遵循这一原则,我们应用迭代级调度和选择性批处理,在一轮参数读取中处理所有“就绪”的标记,而不管标记的处理是否可以批处理(非注意操作)或不可以(注意操作)。
- Specialized execution engines for Transformer modelsTransformer 模型的专用执行引擎。基于Transformer的模型的突出表现,鼓励了专门针对它们的推理系统的开发。例如,FastTransformer, LightSeq, TurboTransformer和EET。这些系统中的每一个都表现为Triton Inference Server和TensorFlow serving等现有服务系统的后端执行引擎。也就是说,这些系统将调度的角色委托给服务系统层,并遵循规范的请求级调度。相反,ORCA建议以更细的粒度调度执行,这在当前系统中是不可能的,除非改变调度程序和执行引擎之间的协调机制。注意,在这些系统中,FastTransformer是唯一支持分布式执行的系统。虽然像Megatron-LM和DeepSpeed这样的系统也可以用于分布式执行,但这些系统主要是针对大规模训练而不是推理服务进行优化的。
- Interface between serving systems and execution engines 服务系统和执行引擎之间的接口。当前的通用服务系统,如Triton Inference Server和Clipper,作为处理客户端请求和调度底层执行引擎执行的抽象。通过分离服务层和执行层的设计和实现,发现这种方法是有益的。然而,我们发现两层之间流行的接口对于处理像GPT这样具有多次迭代特性的模型太受限制。相反,我们将ORCA设计为紧密集成调度程序和引擎,简化了两种提出的技术的应用:迭代级调度和选择性批处理,虽然在本文中我们不研究支持这两种技术而又不失抽象分离的通用接口设计,但探索这种可能性是一个有趣的话题,我们把这个问题留待以后处理。
8 结论
我们提出了具有选择性批处理的迭代级调度,这是一种为基于Transformer的生成模型实现低延迟和高吞吐量的新方法。迭代级调度使调度程序以迭代而不是请求的粒度与执行引擎交互,而选择性批处理支持在不同位置对任意请求处理令牌进行批处理,这对于使用迭代级调度应用批处理至关重要。基于这些技术,我们设计并实现了一个分布式服务系统ORCA。实验证明了我们的方法的有效性:在相同的延迟级别下,ORCA提供的吞吐量比当前最先进的系统高出一个数量级。
原文链接:https://www.usenix.org/conference/osdi22/presentation/yu