一种机器学习算法展示了超越计算机可用内存的数据处理能力,它通过识别大规模数据集的关键特征并将其分割成可处理的批次,避免了计算机硬件的阻塞。该算法由洛斯阿拉莫斯国家实验室开发,通过在奥克里奇国家实验室的“峰值”超级计算机上进行测试,创下了分解巨大数据集的世界记录,该超级计算机是世界上第五快的超级计算机。
该高度可扩展的算法在笔记本电脑和超级计算机上同样有效,解决了硬件瓶颈的问题,这些瓶颈阻碍了癌症研究、卫星图像、社交媒体网络、国家安全科学和地震研究等数据丰富的应用程序中的信息处理。这只是其中的几个领域。
“我们开发了一种‘超出内存’的非负矩阵分解方法的实现,可以在给定硬件上对比以前可能处理的更大数据集进行分解,”洛斯阿拉莫斯国家实验室的计算物理学家伊斯梅尔·布雷玛说道。布雷玛是这篇创纪录算法论文中的第一作者。
我们的实现简单地将大数据分解为可以用现有资源处理的较小单元。因此,这是一个用于跟上指数增长的数据集的有用工具。
传统的数据分析要求数据适应内存限制。我们的方法挑战了这种观念。
我们引入了一种非内存解决方案。当数据量超过可用内存时,我们的算法将其分解为较小的段,逐个处理这些段,将其循环移入和移出内存。这种技术使我们具备了高效处理和分析极大数据集的独特能力。
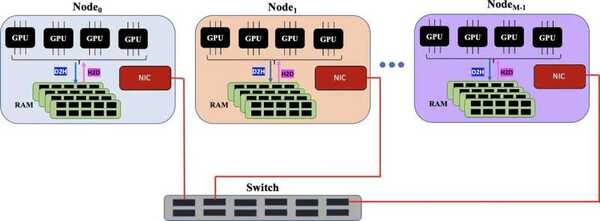
这种适用于现代和异构高性能计算机系统的分布式算法可以在桌面电脑等小型硬件,以及像Chicoma、Summit或即将推出的Venado超级计算机这样的大型复杂硬件上都有用处。
问题不再是是否可能对更大的矩阵进行分解,而是分解需要多长时间。
洛斯阿拉莫斯的这种实现利用了GPU等硬件特性来加速计算,并利用快速互连在计算机之间高效地传输数据。与此同时,该算法能够同时完成多个任务。
非负矩阵分解是洛斯阿拉莫斯SmartTensors项目下开发的高性能算法中的另一项成果。
布雷玛指出,在机器学习中,非负矩阵分解可用作无监督学习的形式,从数据中提取含义,这对于机器学习和数据分析非常重要,因为算法可以识别出对用户具有特定含义的解释性潜在特征。
在洛斯阿拉莫斯团队的创纪录运行中,该算法处理了一个340TB的密集矩阵和一个11EB的稀疏矩阵,使用了25,000个GPU。
分解或因式分解数据是一种专门的数据挖掘技术,旨在提取相关信息并将数据简化为可理解的格式。
Bhattarai进一步强调了他们算法的可扩展性,他说:“相比之下,传统方法常常面临瓶颈,主要是由于计算机处理器和内存之间的数据传输滞后。”
我们也证明了你不一定需要大型计算机。如果你能负担得起,扩展到25,000个GPU当然是很好的,但我们的算法可以在桌面电脑上处理以前无法处理的任务。
