长期以来,使用计算方法研究核糖核酸(RNA)分子的复杂二级结构对于生物学研究和药物开发具有重要意义,特别是随着合成RNA的兴起。
RNA 分子的二级结构会影响其稳定性、翻译和转录功能以及紧凑性。然而,通过实验方法验证二级结构非常耗时。
尽管计算方法可能会有很大差异,但许多计算方法在处理包括假结在内的结构方面的能力有限。事实上,即使是最有效的解决 RNA 二级结构的方法也不能有效地解决假结。
在最近的一项PLOS 计算生物学研究中,研究人员调查了使用量子计算来创建能够更有效、更快速地解决这些结构的方法的可能性。
背景
量子计算机通常被归类为栅极模型或量子退火。例如,量子退火器的应用范围比栅极建模系统窄得多,并且专注于通过最小化问题哈密顿量来优化问题的解决方案。
RNA二级结构的预测作为二元二次模型(BQM)在D波量子退火器(QA)上实现,哈密顿量旨在优化非重叠连续碱基对的数量。假结施加了惩罚,并使用了额外的约束来防止碱基形成超过一对。
经典数据被编码到一个量子设备上,每个可能的词干都映射到一个量子比特。在测量时返回值 1 的量子比特代表有助于二级结构的茎。
该方程使用了一个能量项,奖励更长的茎和两个可调常数。然后可以通过记录所有量子位的值并保存由返回“1”的量子位表示的任何茎来确定最终的二级结构。
但是,如果量子处理单元 (QPU) 直接加载 BQM,则返回的数据噪声很大,更多的量子比特会加剧问题。D-wave 使用经典设备作为混合求解器,将问题分解为更小的元素,然后将它们交给 QPU 进行求解。
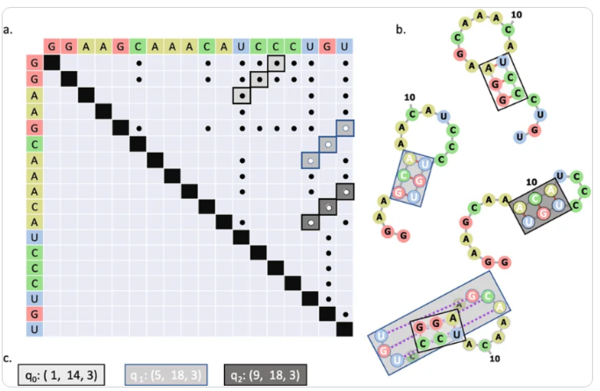
(a) 潜在基数对的矩阵表示。茎以灰色阴影突出显示,并以黑色或蓝色勾勒轮廓。这些颜色仅用于帮助区分茎。(b) 词干的结构表示。灰色线表示共价键,红线表示碱基对,紫色虚线表示伪结配置中的基数对。框的颜色映射到 (a) 中标识的词干。(c)每个可能的词干都分配给量子装置上的一个量子位。如果量子比特返回“1”,则相关词干包含在RNA二级结构中。否则,将排除阀杆。
研究结果
在当前的研究中,编写了一个支持 MPI 的求解s器来与混合求解器进行比较。使用这种方法,包含 45 个量子位的系统可以使用 7,900 个中央处理单元 (CPU) 内核在不到 24 小时内解决。
然后将算法预测的结构与已知解决方案进行比较,灵敏度反映正确识别的碱基对比例,特异性反映以正确顺序映射到结构的碱基对比例。
提取假碱基以获取具有确认假结的 RNA 序列示例,以用作测试集,排除任何相似性高于 95% 的序列。
对于每个枚举,大多数序列都产生了太多可能的词干。因此,最小可能的茎的长度增加到四个,不包括最短的茎并减小了解决方案空间的大小。最终测试集包含 27 个序列,基本测试显示灵敏度为 0.97,特异性为 0.93。
使用量子计算和并行复制交换蒙特卡罗 (REMC) 算法方法对包含 45 到 881 个词干的系统进行了评估。REMC 方法的灵敏度和特异性略高于 QC 方法;但是,平均而言,结果非常相似。
然后,研究人员选择将这些结果与当前文献中发现的三种现有算法进行比较,包括 SPOT-RNA、ProbKnot 和 ViennaRNA。虽然前两种算法能够预测假结,但维也纳 RNA 不能。
正如预期的那样,Vienna RNA 在所有方法中表现最差,其次是 ProbKnot 和 SPOT-RNA。值得注意的是,SPOT-RNA 在超过 45 个词干的数据集上的表现几乎与 QC 一样好,尽管在更少的数据集上表现不佳。
结论
当前研究的结果表明,有可能开发映射到量子硬件的经典折叠势。虽然这种方法并没有优于当前选择的方法,但它为将来更深入地开发类似方法提供了概念证明。
研究人员提供了许多改进此类系统的方法,例如使模型能够解释非 Watson-Crick 或摆动对。因此,量子计算有可能对未来解决 RNA 折叠的尝试非常有帮助,因为可以快速找到大型组合搜索空间的最小能量解决方案。此外,QC 可以灵活地利用更复杂的潜力,这可能会在未来带来更高的特异性和敏感性。
论文参考链接:https://journals.plos.org/ploscompbiol/article?id=10.1371/journal.pcbi.1010032
---煤油灯科技victorlamp.com翻译整理---
