摘要
量子核方法(QKM)有望通过有效地学习编码到指数级大希尔伯特空间的输入数据点之间的关系来加速数据分析。虽然这种技术已经成功地应用于合成数据集的小规模实验,但在有噪声的硬件上扩展到大型电路的实际挑战还没有被彻底解决。在这里,我们展示了我们的研究结果,我们使用使用谷歌的通用量子处理器Sycamore,利用从宇宙学领域获取的真实高维数据,实现了一个量子核分类器。我们构建了一个电路ansatz,它保留了通常由于希尔伯特空间指数增长而消失的内核大小,并针对近期硬件上计算量子核的任务实现了错误缓解。我们的实验使用17个量子位对未压缩的67维数据进行分类,从而在测试集中获得了可与无噪声模拟相媲美的分类精度。
引言
量子核方法(QKM)提供了在机器学习环境中使用量子协处理器的技术。 这些方法最近被证明可以为某些特定的输入数据类提供比传统方法更快的速度。 它们还被用于量化量子机器学习算法中数据的计算能力,并推动量子模型能够超越经典模型的条件。之前的实验工作主要集中在人工或大量预处理的数据,很少涉及量子位的硬件实现,或不适合嘈杂的中等规模量子(NISQ)处理器的电路连接; 最近的实验结果显示了QKM在高能物理中的多量子比特应用的潜力。
在这项工作中,我们将基于QKM的机器学习方法扩展到17个只需要最近邻连接的硬件量子位。 我们使用这种电路结构为经典支持向量机准备了一个核矩阵,用于学习67维超新星数据中的模式,而竞争的经典分类器无法达到 100% 的准确率。 为了在没有量子纠错 (QEC) 的情况下从处理器中提取有用信息,我们实施了针对 QKM 算法的错误缓解技术,并通过实验证明了该算法对某些设备噪声的鲁棒性。此外,我们基于其产生大的核量级的能力来验证我们的电路设计,这些核量级可以通过相对较短的实验运行以较高的统计确定性进行采样。
我们在通过谷歌量子计算服务访问的谷歌Sycamore处理器上实现了该算法。 这台机器类似于量子霸权演示的 Sycamore 芯片,但只有 23 个量子比特处于活动状态。 我们在一个重要的经典数据集上取得了有竞争力的结果,并在电路保真度中等的情况下发现了有趣的分类器鲁棒性。 我们设计的实验突出表明,NISQ 处理器能够利用数十个量子比特来成功完成分类任务,我们的结果激发了进一步的理论工作,包括噪声核方法,以及不需要额外的经典预处理或降维的实际高维数据处理技术。
机器学习中一个常见的任务是监督学习,其中算法消耗数据标签对 ,并输出一个函数 ,该函数理想地预测可见(训练)输入数据的标签,并将其很好地推广到不可见(测试)数据。一个流行的监督学习算法是支持向量机(SVM),它在输入空间的内乘积 上进行训练,以找到一个鲁棒的线性分类边界,最好地分离数据。将SVM分类器推广到非线性可分数据的一个重要技术是所谓的核技巧,它将SVM公式中的 替换为一个对称正定核函数 。由于每个核函数都对应于映射到特征 希尔伯特 空间的输入数据的内积,因此在高维映射上训练的 SVM 找到的线性分类边界对应于输入空间中的复杂非线性函数。
通过使用量子计算机将 中的输入数据映射到高维的复杂希尔伯特空间中,QKM可以潜在地提高分类器的性能,从而可能产生一个具有表现力且具有挑战性的经典计算内核函数。如果不了解数据生成过程,很难知道给定的内核是否特别适合一个数据集,但也许可以根据经验展示经典的硬内核家族来提供性能改进。在本工作中,我们关注一个非变分QKM,它使用量子电路U(x)根据 将真实数据映射到量子状态空间。然后,我们使用的内核函数是 所提供的映射输入数据对之间的平方内积,与 相比,这允许使用更有表现力的模型。
因此,在无噪声的情况下,利用量子计算机对电路 的输出进行采样,然后计算全零位串的经验概率,就可以估计出固定数据集的核矩阵 的最大统计误差。但是在实际应用中,由于器件噪声和读出误差,从量子计算机中采样的核矩阵 可能与 有很大的不同。一旦对训练集中的所有输入数据对求出,就可以在量子计算机的输出上训练经典的SVM。在大小为 的训练集 上训练的SVM根据决策函数学习预测输入数据点 的类:
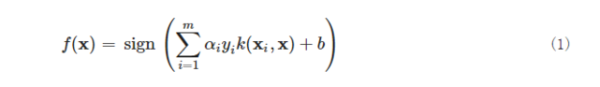
其中, 和 是在SVM训练阶段确定的参数。在T上训练和评估SVM需要一个 的核矩阵,在此之后,测试集 中的每个数据点z都可以对 使用额外的 个 的评估来分类。图1提供了使用量子核训练SVM的过程的示意图。
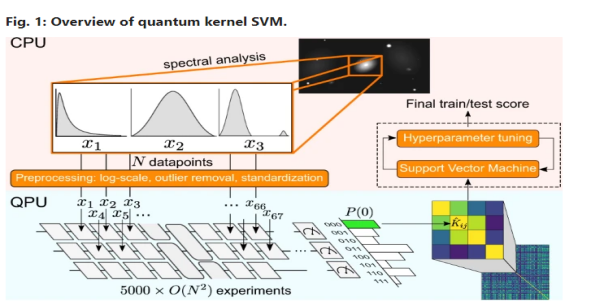
图 1 量子核 SVM 概述。在本实验中,我们执行了有限的数据预处理,这是最先进的经典技术的标准,然后使用量子处理器估计每个数据集中所有编码数据点对 的核矩阵 。然后,我们将内核矩阵传回经典计算机,以使用交叉验证和超参数调整优化 SVM,然后评估 SVM 以产生最终的训练/测试分数。
我们使用了光度LSST天文时间序列分类挑战(PLAsTiCC)提供的数据集,该数据集模拟了Vera C. Rubin天文台的观测结果。PLAsTiCC数据包括模拟天文时间序列的几个不同类别的天体。时间序列由六个波长波段的通量测量组成。这里我们处理来自挑战训练集的数据。为了将问题转化为一个二元分类问题,我们将重点放在两个最具代表性的类和0上,它们分别对应于II型和Ia型超新星。我们对时间序列数据进行统计分析,并进行少量预处理,为每个事件生成67个特征,但不对这些特征进行进一步的降维。
为了在固定数据集上计算核矩阵 ,我们必须对每个电路 运行R次,以确定所有0位串的总计数 ,从而得到一个估计量 。这带来了一个挑战,因为量子核也必须从具有足够低统计不确定性的硬件中采样,以恢复与无噪声条件下的性能相似的分类器。由于K和 之间存在较大的相对统计误差的可能性,当核矩阵的非对角元素都接近于零时,在存在抽样误差的情况下,分类器的性能将下降。相反,对于一个成功的基于硬件的量子核分类器来说,有必要实现特征映射,以产生可以在统计误差水平之上解决的内部产品,电路设计的一个关键目标是平衡大核矩阵元素的要求和传统计算方法难以实现的映射选择。另一个重大的设计挑战是构建一个电路,它可以根据类别将数据分离,而不会将数据映射得太远,以致丢失有关类别关系的信息——在经典机器学习中,这种影响有时被称为维度诅咒。
虽然已经提出了许多QKM特征图,但对于这个实验,我们考虑了上述设计挑战,以及通过使用图2所示的量子电路将数据映射到量子状态空间来容纳高维数据的需要。电路中的每个局部旋转都由预处理输入数据的单个元素参数化,以便量子态空间中的内积对应于输入空间中特征的相似性度量。局部旋转的数量被限制以匹配输入数据的维数(即67维数据的参数化门),但电路的宽度和深度可以改变,而不会显著影响在无噪声环境下分类器的性能。这种电路结构类似于机器学习应用程序中使用的硬件效率高的变分电路,并始终导致大量内积(中位数 ),从而导致 的估计。
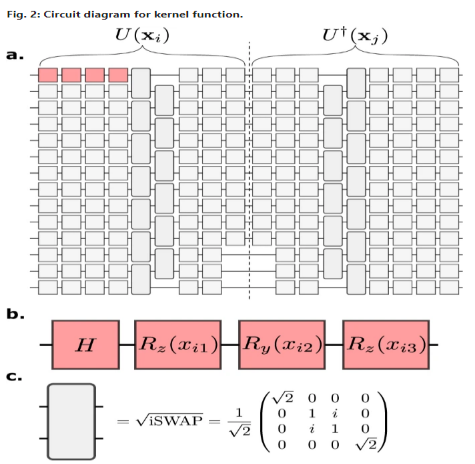
图 2 核函数的电路图。a 在这项工作中用于实验的电路的 14 量子比特示例。虚线表示 之间的边界,它们依次运行以采样 。在边界处出现的非虚拟门是为硬件运行而收缩的。b 基本编码块由一个Hadamard和三个单量子比特旋转组成,每个旋转由输入数据 的不同元素参数化(此处省略归一化和编码常数)。c 我们使用的是 纠缠门,这是Sycamore处理器上的原生硬件双量子比特门。
结果
数据集选择
我们的动机是最小化 的大小,因为在 个数据点上训练SVM的复杂性成本为 。然而,训练样本太小将导致训练模型的泛化能力差,从而导致对保留的 测试集 V 中的数据进行低质量的类预测。我们通过模拟 CIRQ27 中不同训练集大小的分类器来探索这种权衡构建机器学习中的学习曲线(图3)标准。我们发现,与在相同数据子集上使用径向基函数 (RBF) 内核训练的经典 SVM 相比,我们应用于67维超新星数据的模拟量子比特分类器具有竞争力。对于硬件运行,我们构建了训练/测试数据集,其平均训练和 k 倍验证分数在随机下采样数据子集上达到了近似平均性能,考虑了 SVM 超参数优化(参见方法)。小型测试集的分类器分数差异很大,这意味着无噪声分类器在随机下采样数据集上的性能将与平均值显着不同。为了确保硬件性能不被夸大,每个量子比特选择的最终数据集是通过生成一个 1000 模拟内核矩阵来构建的,在大小为 280 的子集上重复执行 4 倍交叉验证,然后选择作为训练/test 设置折叠中的元素,使准确度最接近所有试验和折叠的平均验证分数。
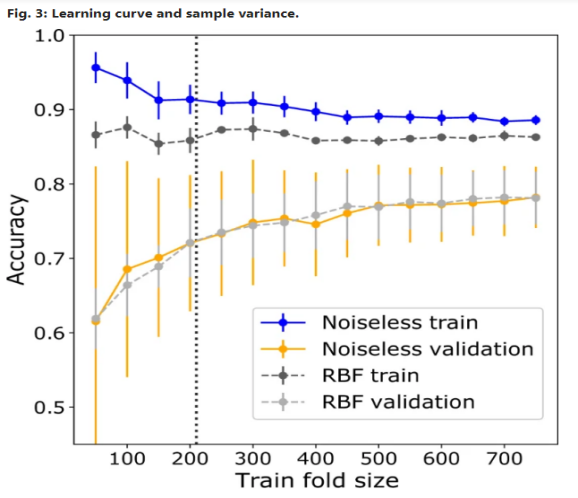
图 3 学习曲线和样本方差。使用17个量子比特上的无噪声电路编码训练的SVM与vs. RBF内核函数的学习曲线 , 其中γ = 0.012,通过 自适应网格搜索进行优化。 点反映了在分层 10 倍分割上训练的分类器的训练/测试精度,从而产生大小为 的平衡的预处理超新星数据点子集。误差条表示 10 次下采样试验的标准偏差,虚线表示为该实验选择的训练集的大小 。
硬件分类及后期处理
我们使用通过谷歌量子计算服务访问的谷歌Sycamore处理器进行了量子核的实验计算。在实验时,该设备由 23 个具有最近邻(网格)连通性的超导量子比特组成。处理器支持具有99%随机基准保真度的单量子位泡利门,以及具有99%随机基准保真度的本地纠缠门 。
为了测试我们的分类器在硬件上的性能,我们使用n个量子比特电路对 个具有平衡类先验的超新星数据 进行 训练一个量子核SVM,我们使用一些错误缓解技术(在补充方法中进一步描述)进行硬件实验。使用基于设备校准数据的启发式评分函数选择每组量子位,满足设备上线路连通性的最大量子位为17(如图3所示)。我们发现,与其他交错执行方案相比,并行执行纠缠门层可以提高性能。我们实现了读出错误校正,以有效地近似具有多项式开销的allzero位串的概率,但我们发现读出错误校正并不能可靠地提高分类器的性能(参见补充讨论)。为了减轻统计误差的影响,每个量子位总共需要 次实验,在量子处理器上大约需要16小时。通常计算决策函数(Eq.(1))的时间成本降低到mv的某个分数,因为只有一小部分训练输入被选择作为支持向量。然而,在模拟和硬件实验中,我们观察到T中的很大一部分数据(分别为87和95%)的数据被选择为支持向量,这可能是由于在硬件分类器中, 的计算结合了复杂的决策边界和噪声。图4显示了每个量子位数量的分类器精度,并演示了QKMs的性能不受所使用的量子位数量的限制。值得注意的是,即使观察到的比特串概率(因此 )由于电路保真度有限而被抑制 时,QKMs分类器仍然表现得相当好。这部分是因为,SVM决策函数在缩放变换 下是不变的,并突出了QKMs的噪声鲁棒性。
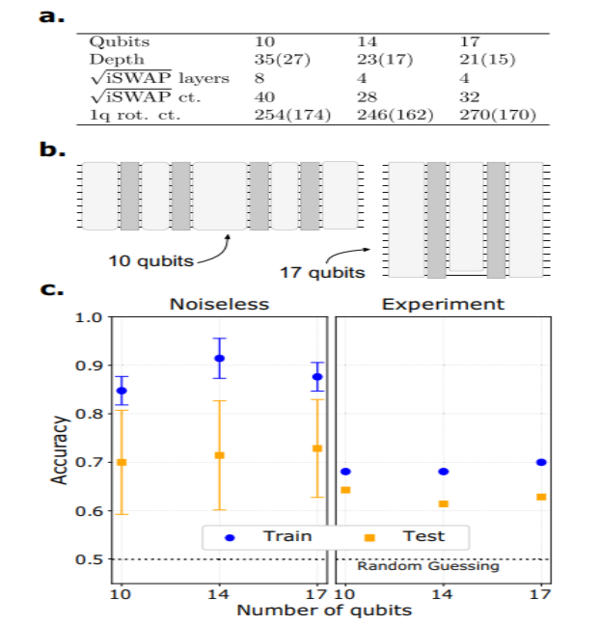
图 4 a 实验中三个电路的参数。计算括号中的值时忽略了虚拟Z门的贡献。b 每个电路的深度和纠缠层(深灰色)的数量,以容纳输入数据的所有67个特征。c 测试精度对硬件QKMs与噪声模拟竞争甚至在电路保真度相对较低的情况下,多个选择的量子比特计数(模拟测试精度 , 仿真测试精度在统计上与优化的 RBF 性能没有区别,类似于图3中 )。硬件噪声的存在显著降低了模型对数据的过拟合能力。模拟数据上的误差条代表了在10个size-m下采样核矩阵上训练的SVM分类器集合,并在size-v下采样测试集(没有替换)上测试的精度的标准偏差。数据集采样误差会传播到硬件结果中,但由于缺乏较大的硬件训练/测试集,无法对泛化误差进行表征(例如使用bootstrapping技术)。
结论
量子计算是否以及如何对现实世界经典数据集的机器学习做出贡献仍有待观察。在这项工作中,我们已经证明在中等规模(10-17量子比特)的量子机器学习可以使用谷歌的超导量子计算机在自然数据集上工作。特别的是,我们提出了一种能够处理来自真实世界科学实验的高维数据的电路ansatz,不需要对输入数据进行降维或重要的预处理,也不需要量子位的数量与数据维数匹配。尽管有硬件噪声和缺乏QEC,但我们展示的分类结果与无噪声模拟具有竞争力。虽然我们实现的电路不是显示量子优势的候选电路,但这些发现表明,QKM可能能够在近期设备上实现高分类精度。
在评价QKM性能时,必须仔细注意弹丸统计量和核元素大小的影响。这些因素影响的实证结果,但这一工作强调了在这些约束条件下进行进一步理论研究的必要性,并推动了对噪声核性质的进一步研究。
主要的开放问题是确定一个自然的数据集,可以导致超越经典性能的量子机器学习。我们相信,这可以在具有相关性的数据集上实现,这些相关性在经典计算机上很难表示或存储,因此在经典计算机上很难学习或推断。这可能包括从接近临界点的量子多体系统模拟或在量子计算机上解决线性和非线性方程组的量子数据。量子数据也可以从量子传感和量子通信应用中产生。软件库TensorFlow Quantum (TFQ)36最近被开发出来,以促进探索用于量子机器学习的数据、模型和算法的各种组合。也有人提出了一些工程数据集的量子优势,并使用类似的QKMs在TFQ中对多达30个量子比特进行了数值验证。量子机器学习的这些发展以及这项工作的实验结果表明,在近期处理器上使用量子机器学习实现量子优势的令人兴奋的可能性。
方法
数据预处理
PLAsTiCC数据最初由时间序列组成,不适合在量子处理器上进行直接分析。每个时间序列可以在六个波段中的每一个波段中进行不同数量的通量测量。为了使用具有固定输入数量的算法对不同的时间序列进行分类,我们将每个时间序列转换为相同的派生量集。其中包括:测量次数;通量和通量误差的最小值、最大值、平均值、中值、标准偏差和偏斜;通量和通量误差之比以及通量乘以通量比的总和和偏斜;测量之间的平均和最大时间;主星系的光谱和光度学红移;每个物体在天空中的位置;以及每个波段的前两个傅立叶系数,以及峰度和偏度。总的来说,这种转换为每个对象产生了一个 67 维的向量。为了准备量子电路的数据,我们将对数正态分布的光谱输入转换为对数尺度,并将所有输入归一化为 。我们不执行降维。
分类器超参数调优
在后处理中训练SVM分类器需要选择单个超参数C,该超参数C对误分类有惩罚作用,会显著影响最终分类器的噪声鲁棒性(参见补充说明)。 为了在不过度拟合模型的情况下确定 C,我们对 T 进行了留一法交叉验证 (LOOCV) 以确定最大平均LOOCV评分对应的Copt。 然后我们固定 C = Copt 以评估从 V 获取的保留数据点 的测试精度。
原文链接:https://www.nature.com/articles/s41534-021-00498-9
---煤油灯科技victorlamp.com翻译整理---
