尽管人工智能 (AI) 由于指数级的发展而变得更加先进,但这种现代技术的局限性仍然存在。
那么,合成数据能否成为所有与人工智能相关的问题的解决方案?
在第四次工业革命中,每个行业都发现了现代技术的潜力;比如人工智能(AI)和机器学习(ML)。
几乎所有其他机构组织都在部署 AI 以创建更高效的业务流程并确保更好的客户满意度。但是,初创公司、SOHO 和中小型企业 (SMB) 在采用 AI 时面临一个重大问题——这就是所谓的冷启动问题。虽然初创公司和中小企业一般没有资源收集大数据,但冷启动问题基本上是缺乏此类相关数据。另一方面,行业巨头已经拥有资源来收集真实世界的数据并将这些数据应用于训练他们的人工智能系统。因此,对中小型企业的胜算很大。在这种情况下,合成数据可能是必要的启动器。
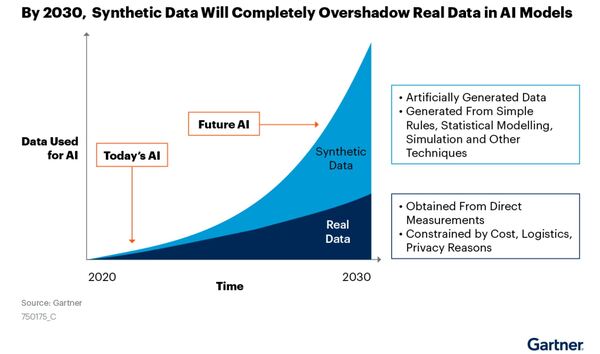
合成数据可以成为数据驱动的商业模式背后的驱动力。此外,研究表明 合成数据产生与真实数据相同的结果。 与真实数据相比,合成数据被认为更便宜且处理时间更短。因此,合成数据的出现可以平衡目前由大公司主导的竞争环境,有利于中小企业和初创公司。
合成数据的好处
合成数据是基于用户指定参数的计算机生成的人工数据,以确保数据尽可能接近真实世界的历史数据。通常,Unreal 引擎和 Unity 等游戏引擎通常用作模拟环境,用于测试和训练基于 AI 的应用程序,例如自动驾驶汽车。基于合成数据开发人工智能驱动的应用程序有很多优势。其中一些优势包括:
1. 开发原型
寻找、聚集和建模大量相关的真实数据是一个乏味的过程。因此,生成合成数据可能是最优解决方案。这些数据将使制造原型和测试这些原型在大规模生产之前达到预期的结果成为可能。与真实数据相比,使用合成数据构建原型更高效、更划算。
非营利性人工智能研究公司Open AI正在开发大量基于人工智能的应用程序。在这些应用中,研究人员开发出了用合成数据训练的机器人,在看到一个动作只执行一次后就能学习新任务。加州一家科技初创公司正在开发一种人工智能平台,其愿景与 Amazon Go类似。这家初创公司的目标是在合成数据的帮助下,为便利店和零售商提供一种免结账的解决方案。他们还引入了人工智能智能系统来监控店内的每一位购物者,以识别和分析他们的学习模式。
2. 确保数据隐私
2018年11月,5亿万豪酒店客户受到数据泄露的影响。在5亿名用户中,3.27亿名用户的护照信息、电子邮件地址、邮寄地址、信用卡信息等信息被窃取。由于这样的事件,人们开始关注自己数据的安全和隐私。
合成数据可以有效地解决此类隐私问题。合成数据不包括任何个人数据。因此,可以很容易地保证数据隐私。合成数据在训练人工智能系统应用于医疗保健方面可能被证明非常有用。人工智能系统通常需要真实的患者数据。这涉及到了病人的隐私。合成数据允许开发医疗保健领域的先进AI应用程序,同时保持患者的隐秘性。例如,英伟达(Nvidia)的研究人员正在与明尼苏达州的Mayo Clinic合作,波士顿的MGH和BWH临床数据科学中心(Center For Clinical Data Science)正在使用生成对抗网络生成用于训练神经网络的合成数据。生成的合成数据包括来自阿尔茨海默病神经成像倡议数据集的3400张mri,以及来自多模态脑肿瘤图像分割基准数据集的200张带有肿瘤的4D脑mri。同样,模拟x射线也可以与实际x射线一起用于训练AI系统识别几种健康状况。
3.前所未有的场景进行测试和培训
在开发人工智能应用程序的过程中,最重要的过程之一是测试系统性能。如果一个系统不能产生期望的输出,它需要重新训练。在这种情况下,合成数据可以被证明是有益的。合成数据可以生成场景来测试AI系统,而不是使用真实数据或在真实环境中测试系统,这种方法比获取真实数据便宜且耗时少。
同样,合成数据还可以训练新的或现有的系统,以应对缺乏真实数据或未来可能发生的事件的场景。通过这种方法,研究人员可以开发出更具有未来感的人工智能应用。此外,使用合成数据对人工智能系统进行再训练更简单,因为生成合成数据比收集准确的真实数据更简单。
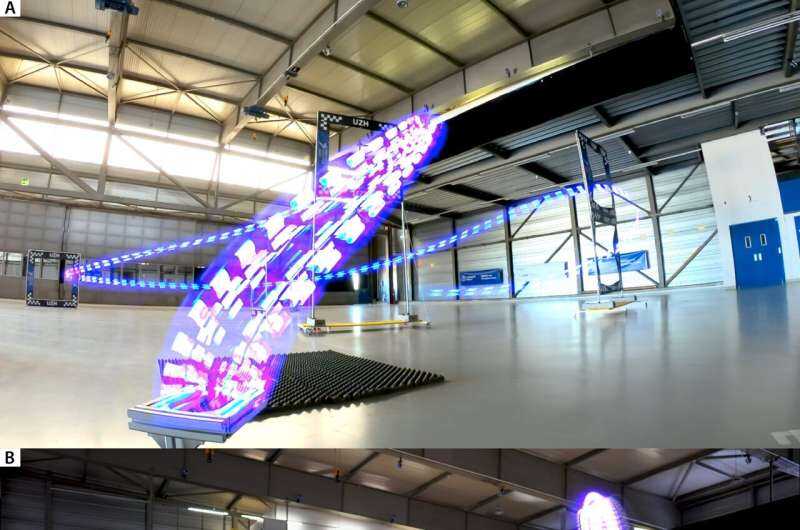
由于这些优点,合成数据已成为测试和培训自动驾驶汽车的一种可行选择。许多自动驾驶汽车的开发人员都在用模拟游戏环境(如《侠客猎车手v》)来训练他们基于人工智能的系统。类似地,May Mobility也在用合成数据训练车辆,打造自动驾驶微型交通服务。另一家名为Waymo的自动驾驶汽车开发商已经对其自动驾驶汽车进行了测试,在模拟道路上行驶了50亿英里,在真实道路上行驶了800万英里。这种合成数据方法允许开发人员在模拟道路上测试他们的自动驾驶汽车,这比直接在实际道路上测试要安全得多。
4. 促进数据的灵活性
获取真实数据是一个繁琐的过程,包括为注释付费,并确保避免侵犯版权。此外,真实数据只能用于特定场景,该场景在其特定领域中具有足够的历史数据。与真实数据不同,合成数据可以立即呈现对象、场景、事件和人员的任何组合。合成数据可以生成通用的数据集,使发现小众应用程序成为可能。因此,研究人员可以利用合成数据探索无限的可能性。几家创业公司通过开发训练数据集来满足客户的需求,创造了一个开放的数据经济。
5. 探索合成数据的局限性
虽然合成数据可以帮助人工智能到达未被发现的景观,但其局限性可能成为其主流部署的主要障碍。对于初学者来说,合成数据模拟了真实数据的多个属性,但它不会完全复制原始数据。AI系统在对这些合成数据进行建模时,只会在真实数据中寻找共同的趋势和情况。因此,包含在现实世界数据中角落案例中的罕见场景可能永远不会包含在合成数据中。此外,研究人员还没有开发出一种机制来检查数据是否准确。发现真实数据中的缺陷并加以改进要比使用合成数据简单得多。人工智能驱动的系统已经有了更黑暗的一面,它会促进无意识的偏见。对于合成数据,预测这种偏差的范围和影响可能还为时过早。
6. 克服的挑战
机构组织需要明白,合成数据是一个新的发现,这类数据的效率和准确性还没有按照目前的行业标准进行评估。因此,不应将合成数据视为独立的数据源,特别是在面临安全问题的应用中,如医疗保健应用和自动驾驶汽车,合成数据必须与真实数据相结合,以开发AI系统。但在风险因素较低的零售领域,应用可以很容易地依赖于合成数据。
对于测试目的,合成数据是一个可行的和成本友好的解决方案。但是,出于其他目的,在采用合成数据作为独立解决方案之前,需要对人工智能系统的结果进行彻底的研究和分析。随着进一步的研究,合成数据对于多种操作可能会变得更加可靠。