在努力了解量子世界的过程中,科学家们面临着一个很大的障碍:他们对世界的经典体验。每当测量量子系统时,这种测量的行为都会破坏状态的“量子性”。例如,如果量子态处于两个位置的叠加态,那么它似乎可以同时在两个地方,一旦它被测量,它将随机出现“这里”或“那里”,但不会同时出现在“这里”或“那里”。我们只看到这个奇怪的量子世界投射的经典阴影。
越来越多的实验正在实施机器学习(ML)算法来帮助分析数据,但这些算法与它们旨在帮助的人具有相同的局限性:它们不能直接访问量子信息并从中学习。但是,如果有一个量子机器学习算法可以直接与这些量子数据进行交互呢?
在与加州理工学院,哈佛大学,伯克利大学和微软的研究人员合作发表在《科学》杂志上的《从实验中学习的量子优势》中,研究表明量子学习代理在许多任务上的表现比经典学习代理要好得多。使用谷歌的量子计算机Sycamore,展示了量子机器学习(QML)算法相对于最佳经典算法的巨大优势。与之前的量子优势演示不同,经典计算能力的任何进步都无法克服这一差距。这是首次证明在学习量子系统方面具有可证明的指数优势,即使在当今嘈杂的硬件上也很强大。
量子加速
QML结合了量子计算和量子传感领域的精华。
对于某些问题,量子计算机可能会比经典系统提供指数级改进,但为了实现它们的潜力,研究人员首先需要增加量子比特的数量并改进量子纠错。更重要的是,量子计算机所承诺的经典算法的指数级加速依赖于对所谓“复杂性类别”问题的假设——即量子计算机上可以解决的问题类别大于在经典计算机上可以解决的问题类别。这似乎是一个合理的假设,然而,没有人证明这一点。在它被证明之前,每个量子优势的主张都会带有一个引号:它可以比任何已知的经典算法做得更好。
另一方面,量子传感器已经用于一些高精度测量,并且与传统传感器相比具有适度(且经过验证的)优势。一些量子传感器通过利用粒子之间的量子相关性来提取比原本可以拥有的更多的系统信息。例如,科学家可以使用N个原子的集合来测量原子环境的各个方面,如周围的磁场。通常,原子可以测量的场的灵敏度与N的平方根成比例。但是,如果使用量子纠缠在原子之间创建一个复杂的相关性网络,那么就可以将缩放提高到与N成正比。但与大多数量子传感协议一样,这种对经典传感器的二次加速是有史以来最好的。
进入QML,这是一种跨越量子计算机和量子传感器之间界限的技术。QML算法进行由量子数据辅助的计算。量子计算机可以存储量子数据并实现QML算法来处理数据而不会崩溃,而不是测量量子态。当这些数据受到限制时,QML算法可以在考虑特定任务时从它收到的每个片段中以指数方式挤出更多的信息。

图1:经典机器学习算法和量子机器学习算法的比较。经典机器学习算法测量量子系统,然后对其获取的经典数据执行经典计算以了解系统。另一方面,量子机器学习算法与系统产生的量子态相互作用,使其比CML具有量子优势。
要了解QML算法的工作原理,与标准量子实验进行对比是很有用的。如果科学家想了解量子系统,他们可能会发送一个量子探针,例如原子或其他量子物体,其状态对感兴趣的系统敏感,让它与系统相互作用,然后测量探针。然后,他们可以设计新的实验或根据测量结果进行预测。经典机器学习(CML)算法使用ML模型遵循相同的过程,但工作原理是相同的——它是处理经典信息的经典设备。
QML算法使用人工“量子学习器”。在量子学习器发送探针与系统交互后,它可以选择存储量子态而不是测量它。这就是QML的力量所在。它可以收集这些量子探针的多个副本,然后将它们纠缠在一起,以更快地了解有关该系统的更多信息。
例如,假设感兴趣的系统通过从某些可能状态的分布中抽样,以概率方式产生量子叠加态。每个状态都由n个量子比特组成,其中每个都是“0”和“1”的叠加——所有学习者都可以知道状态的通用形式,但必须了解其细节。
在只能访问经典数据的标准实验中,每次测量都提供了量子态分布的快照,但由于它只是一个样本,因此有必要测量状态的许多副本来重建它。事实上,它将需要大约 个副本。
QML代理更聪明。通过保存n -qubit状态的副本,然后将其与出现的下一个副本纠缠在一起,它可以更快地了解全局量子态,从而更快地更好地了解状态的样子。
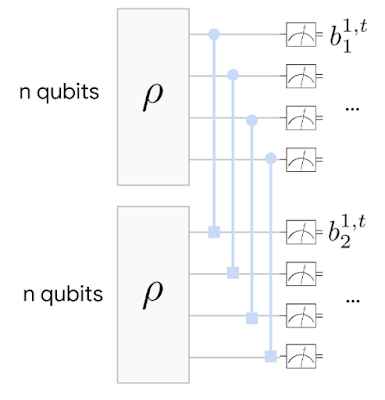
图:QML算法的基本原理图。保存一个量子态的两个副本,然后执行“贝尔测量”,其中每一对都被纠缠并测量它们的相关性。
经典的重建就像试图找到一个隐藏在嘈杂像素海洋中的图像——可能需要很长时间才能平均所有噪声才能知道图像代表什么。另一方面,量子重建使用量子力学通过同时寻找两个不同图像之间的相关性来更快地隔离真实图像。
结果
为了更好地理解QML的强大功能,研究人员首先研究了三种不同的学习任务,并从理论上证明,在每种情况下,量子学习代理都会比经典学习代理做得更好。每个任务都与上面给出的示例相关:
- 学习量子态的不相容可观测量——即由于海森堡不确定性原理而无法同时以任意精度知道的可观测量,如位置和动量。但是我们表明,可以通过纠缠一个状态的多个副本来克服这个限制。
- 了解量子态的主要成分。当存在噪声时,它会扰乱量子态。但通常情况下,“主要成分”——叠加中概率最高的部分——对这种噪声具有鲁棒性,因此我们仍然可以通过找到这个主要部分来收集有关原始状态的信息。
- 了解作用于量子系统或探测器的物理过程。有时,状态本身不是感兴趣的对象,而是演化这种状态的物理过程。我们可以通过分析状态随时间的演变来了解各种领域和相互作用。
除了理论工作外,研究人员还在Sycamore量子处理器上进行了一些原理验证实验。首先实现了一个 QML 算法来执行第一个任务。向算法输入了一个未知的量子混合状态,然后询问该状态的两个可观测值中哪个更大。在用模拟数据训练神经网络后,研究发现量子学习代理需要成倍减少的实验来达到 70% 的预测准确度——相当于当系统大小为 20 量子比特时测量次数减少 10,000 倍。由于一次存储了两个副本,因此使用的量子比特总数为 40。
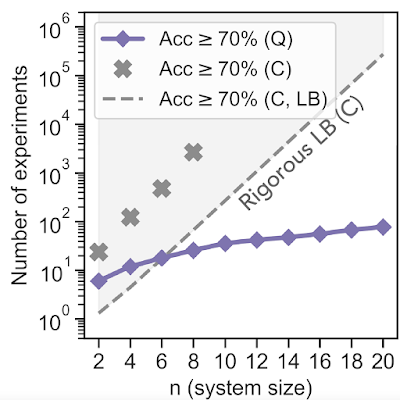
图:用于预测量子态可观察量的QML与CML算法的实验比较。虽然使用CML算法(上面的“C”)达到70%准确度所需的实验数量随着量子态n的大小呈指数级增长,但QML算法(“Q”)所需的实验数量仅在n中是线性的。标有标记为“Rigrous LB (C)”的虚线表示经典机器学习算法的理论下限 (LB)——最佳性能。
在与上述任务3相关的第二个实验中,让算法了解了一个算子的对称性,该算子演化了量子比特的量子态。特别是,如果一个量子态可能经历完全随机或随机的演化,但也是时间反转对称的,那么经典学习者可能很难分辨出其中的区别。在此任务中,QML 算法可以将运算符分为两个不同的类别,表示两个不同的对称类,而 CML 算法则完全失败。QML算法是完全无监督的,因此研究人员希望该方法可以用于发现新现象,而无需事先知道正确答案。
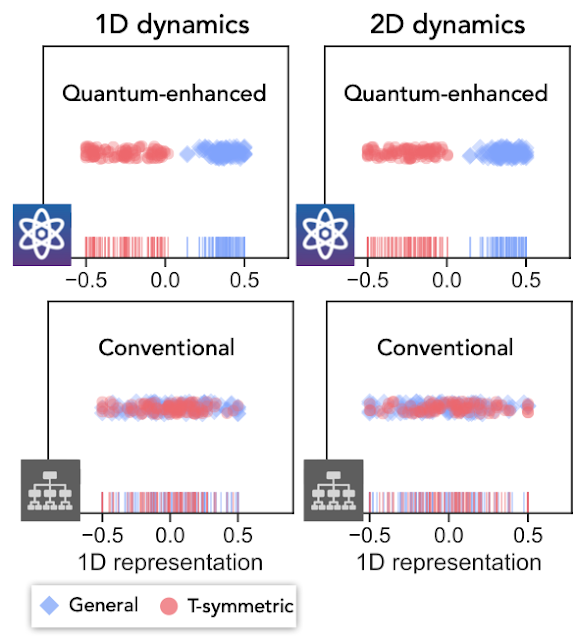
图:用于预测算子对称类的 QML 与 CML 算法的实验比较。虽然 QML 成功地分离了两个对称类,但 CML 无法完成任务。
结论
这项实验工作代表了量子机器学习中首次展示的指数优势。而且,与计算优势不同的是,当限制来自量子态的样本数量时,这种类型的量子学习优势无法受到挑战,即使是无限的经典计算资源。
到目前为止,该技术仅用于人为的“原理验证”实验,在该实验中故意产生量子态,研究人员假装不知道它是什么。为了在实际实验中使用这些技术进行量子增强测量,首先需要研究当前的量子传感器技术和方法,以将量子态忠实地传输到量子计算机。但是,今天的量子计算机已经可以处理这些信息,从而在学习中挤出指数优势,这对于量子机器学习的未来来说是个好兆头。
原文链接:https://ai.googleblog.com/2022/06/quantum-advantage-in-learning-from.html
---煤油灯科技victorlamp.com翻译整理---
