摘要
InterPlanetary File System(IPFS)是一个点对点的分布式文件系统,旨在将所有的计算设备与相同的文件系统连接起来。在某些方面,IPFS类似于Web,但IPFS可以被看作是一个单一的BitTorrent群,在一个Git存储库中交换对象。换句话说,IPFS提供了一个高吞吐量的内容寻址块存储模型,具有内容寻址的超链接。这形成了一个通用的Merkle DAG,这是一种人们可以在此基础上建立版本化的文件系统、区块链,甚至是永久Web的数据结构。IPFS结合了一个分布式哈希图,激励块交换和一个自我认证的命名空间。IPFS没有单点故障,节点之间不需要相互信任。
1. 简介
在构建全局分布式文件系统方面已经有许多尝试。一些系统取得了显著的成功,有些则完全失败。在学术界的尝试中,AFS[6]取得了广泛的成功,至今仍在使用。其他的[7, ?]没有取得同样的成功。在学术界之外,最成功的系统是点对点的文件共享应用,主要是面向大型媒体(音频和视频)。大多数情况下,Napster、KaZaA和BitTorrent[2]部署了支持超过1亿的同步用户的大型文件分发系统。即使在今天,BitTorrent仍然保持着一个大规模的部署,每天有数千万个节点在运转[16]。与学术文件系统对应的应用程序相比,这些应用程序的用户和文件数量更过。然而,这些应用并不是作为基础设施来设计的。虽然已经有了成功的再利用,但没有一个通用的文件系统能够提供全球性的、低延迟的和分散的文件。
也许这是因为对于大多数情况来说已经存在一个“足够好”的系统:HTTP。到目前为止,HTTP是最成功的的“分布式文件系统”,再加上浏览器,HTTP在技术上和社会上产生了巨大的影响。它已经成为在互联网上传输文件的事实上的方式。然而,它未能利用在过去15年中发明的几十种出色的文件分发技术。从一个角度来看,发展Web基础设施几乎是不可能的,因为有许多向后兼容的限制和许多强大的技术。例如,Linux发行版使用BitTorrent来传输磁盘图像,暴雪公司使用它来分发视频游戏内容。各方投资于当前模式。但从另一个角度来看:自HTTP出现以来,新的协议已经出现并得到了广泛使用。现在所缺乏的是升级设计:加强目前的HTTP网络,并在不降低用户体验的情况下引入新功能。
工业界之所以能够长期使用HTTP,是因为移动小文件的成本相对较低,即使对于流量很大的小组织来说也是如此。但我们正在进入一个数据分发的新时代,面临着新的挑战:(a)托管和分发PB级的数据集,(b) 跨组织的大数据计算,(c) 高容量高清晰度的按需或实时媒体流,(d) 大规模数据集的版本管理和链接(e) 防止重要文件的意外消失,以及更多。其中许多都可以归结为“大量的数据,随处可访问”。迫于关键功能和带宽问题,我们已经准备放弃HTTP,而选择了不同的数据分发协议。下一步是使它们成为网络本身的一部分。
与高效的数据分发正交,版本控制系统已经成功开发了重要的数据协作工作流程。Git,分布式源代码版本控制系统,开发了许多有用的方法来建模和实现分布式数据操作。Git的工具链提供了大型文件分发系统所严重缺乏的多功能版本控制功能。受Git启发的新解决方案正在出现,例如个人文件存储系统Camlistore[?],以及数据协作工具链和数据集包管理器Dat[?]。Git已经影响了分布式文件系统的设计[9],因为它的内容解决了Merkle DAG数据模型使得强大的文件分发策略。有待探索的是这种数据结构如何影响面向高吞吐量的文件系统的设计,以及它如何升级Web本身。
本文介绍了IPFS,一个新颖的点对点版本控制的文件系统,旨在解决这些问题。IPFS综合了过去许多成功系统的经验。以接口为重点的精心集成产生了一个比其各部分之和更大的系统。。IPFS的中心原则是将所有数据建模为同一Merkle DAG的一部分。
2.背景
本节回顾了成功的点对点系统的重要特性,IPFS 结合了这些特性。
2.1 分布式哈希表
分布式哈希表(DHT)被广泛用于协调和维护点对点系统的元数据。
例如,BitTorrent MainlineDHT跟踪torrent群中的对等点集。
2.1.1 Kademlia DHT
Kademlia[10]是一个流行的DHT,它提供:
1. 通过大规模的网络进行高效的查询:查询时平均联系dlog2(n)e个节点。(例如,对于一个有10,000,000个节点的网络来说,有20个跳)。
2. 低协调开销:它优化了向其他节点发送控制信息的数量。
3. 通过优先选择长寿命的节点来抵抗各种攻击。
4. 在点对点应用中广泛使用,包括Gnutella和BitTorrent,形成超过2000万个节点的网络[16]。
2.1.2 Coral DSHT
虽然一些点对点文件系统直接在DHT中存储数据块,但这“浪费了存储和带宽,因为数据必须存储在不需要它的节点上”[5]。Coral DSHT以三个特别重要的方式扩展了Kademlia:
1. Kademlia将数值存储在ID与键“最近”(使用XOR-distance)的节点中。这并没有考虑到应用程序的数据位置的局限性,忽略了可能已经拥有数据的“远”节点,并强制“最近”的节点存储数据,无论他们是否需要它。这浪费了大量的存储和带宽。相反,Coral将地址存储到可以提供数据块的对等方上。
2. Coral将DHT的API从get_value(key)放宽到get_any_values(key)(DSHT中的“sloppy”)。这仍然有效,因为Coral用户只需要一个(工作)对等方,而不是完整的列表。作为回报,Coral可以只将数值的子集分配给“最近”的节点,避免热点(当一个密钥变得流行时,会重载所有最近的节点)。
3.此外,Coral根据区域和规模组织了一个独立的DSHT层次结构,称为集群。这使得节点能够首先查询其区域内的对等点。“查找到附近的数据,而不去查询远处的节点”[5],并大大减少了查询的延迟。
2.1.3 S/Kademlia DHT
S/Kademlia[1]在两个特别重要的方面对Kademlia进行了扩展,以防止恶意攻击。
1. S/Kademlia提供了安全的NodeId生成方案,并防止Sybil攻击。它要求节点创建一个PKI密钥对,从中获取他们的身份,并相互签署他们的信息。一个方案包括一个工作量证明的加密谜题,以使生成Sybil的成本高昂。
2. S/Kademlia节点通过不相干的路径查询数值,以确保诚实的节点在网络中存在大量对手的情况下能够相互连接。S/Kademlia达到0.85的成功率,即使对抗性分数高达节点的一半。
2.2 区块交换 - BitTorrent
BitTorrent[3]是一个广泛成功的点对点文件共享系统,它成功地协调了由不信任的对等点(群)组成的网络,以合作方式将文件分发给对方。BitTorrent及其生态系统为IPFS的设计提供信息的主要功能包括:
1.BitTorrent的数据交换协议使用了一种准以牙还牙的策略,奖励那些为对方做出贡献的节点,而惩罚那些窃取别人的资源的节点。
2. BitTorrent对等方跟踪文件片段的可用性,优先发送最稀有的片段。这将减轻种子的负担,使非种子节点能够互相交易。
3.BitTorrent的标准针锋相对策略很容易被一些剥削性的带宽共享策略所利用。PropShare[8]是一种不同的对等带宽分配策略,能更好地抵制剥削性策略,并提高集群的性能。
2.3 版本控制系统 - Git
版本控制系统提供了对随时间变化的文件进行建模并有效分发不同版本的工具。流行的版本控制系统Git提供了一个强大的Merkle DAG 2对象模型,它以分布式友好的方式捕获了对文件系统树的更改。
1. 不可改变的对象代表文件(blob)、目录(tree)和变更(commit)。
2.对象的内容是由其内容的加密散列进行内容寻址。
3.嵌入到其他对象的链接,形成Merkle DAG。这提供了许多有用的完整性和工作流程属性。
4.大多数版本元数据(分支、标签等)都是简单的指针引用,因此创建和更新的成本很低。
5. 版本变更只更新引用或添加对象。
6. 将版本更改分发给其他用户只是传输对象和更新远程引用。
2.4 Self-Certified Filesystems - SFS
SFS[12,11]提出了令人信服的实现方式,包括(a) 分布式信任链,和 (b) 平等共享全局命名空间。SFS引入了一种构建SelfCertified文件系统的技术:使用以下方案对远程文件系统进行寻址:
/sfs/<Location>:<Host ID>
其中Location是服务器的网络地址:
HostID = hash(public_key || Location)
这样,一个SFS文件系统的名称就证明了它的服务器。用户可以验证由服务器提供的公钥。协商共享秘密,并确保所有通信的安全。所有的SFS实例共享一个全局名称空间,其中名称分配是加密的,而不是由任何集中的机构来控制。
3. IPFS设计
IPFS是一个分布式文件系统,它综合了以前点对点系统的成功理念,包括DHTs, BitTorrent, Git, 和SFS.。IPFS的贡献是简化、发展和连接已证实的技术成一个单一的有凝聚力的系统,大于其各个部分的总和。IPFS为编写和部署应用程序提供了一个新的平台,也是一个用于分发和版本化大数据的新系统。IPFS甚至可以使网络本身得到发展。
IPFS是点对点的;没有节点是有特权的。IPFS节点在本地存储中存储IPFS对象。节点之间相互连接并传输对象。这些对象代表文件和其他数据结构。IPFS协议被划分为负责不同功能的子协议的堆栈:
1. 身份 - 管理节点身份的生成和验证。在第3.1节中进行了描述。
2. 网络 - 管理与其他对等体的连接,使用各种底层网络协议。可配置的。在第3.2节中描述。
3. 路由 - 维护信息以定位特定的同伴和对象。对本地和远程查询做出响应。默认为DHT,但可以互换。在第3.3节中描述。
4. 交换 - 一个新的区块交换协议(BitSwap),用于管辖高效的区块分配。以市场为模型,对数据复制的激励较弱。贸易策略可互换。在第3.4节中进行了描述。
5. 对象 - 带有链接的内容寻址的不可变对象组成的Merkle DAG。用于表示任意的数据结构,例如文件层次和通信系统。在第3.5节中进行了描述。
6. 文件 - 受Git启发的版本化文件系统层次结构。在第3.6节中描述。
7. 命名 - 一个自我认证的可变名称系统。在第3.7节中描述。
这些子系统不是独立的;它们是集成的并利用混合属性。然而,分开描述它们是有用的,从下而上构建协议栈。
Notation:下面的数据结构和函数是用Go语法指定的。
3.1 身份
节点是由NodeId识别的,NodeId是公钥的加密哈希值,由S/Kademlia的静态密码器[1]创建。节点存储他们的公钥和私钥(用口令加密)。用户可以在每次启动时自由地实例化一个“新”节点身份,尽管这将失去累积的网络利益。激励节点保持不变:
type NodeId Multihash
type Multihash [ ]byte
// self-describing cryptographic hash digest

type PublicKey [ ]byte
type PrivateKey [ ]byte
// self-describing keys

type Node struct {
NodeId NodeID
PubKey PublicKey
PriKey PrivateKey
}
基于S/Kademlia的IPFS身份生成:
difficulty =  <interger parameter>
n = Node{ }
do {
n.PubKey, n.PrivKey = PKI.genKeyPair()
n.NodeId = hash(n.PubKey)
p = count_preceding_zero_bits(hash(n.NodeId))
} while (p < difficulty)
首次连接时,对等方交换公钥,并检查:hash(other.PublicKey)是否等于other.NodeId。如果
不等于,连接将被终止。
关于加密函数的注意事项:
IPFS不是将系统锁定在一组特定的函数选择上,而是倾向于自我描述的值。散列摘要值是以multihash格式存储的,其中包括一个简短的标题,指定使用的散列函数和字节为单位的摘要长度。例如:
<function code><digest length><digest bytes>
这允许系统(a)为用例选择最佳函数(例如,更强的安全性与更快的性能),以及(b)随着功能选择的变化而发展。自我描述值允许使用不同的参数选择来兼容。
3.2 网络
IPFS节点定期与网络中的数百个其他节点进行通信,可能跨越广泛的互联网。
IPFS网络堆栈功能:
- 传输:IPFS可以使用任何传输协议。最适合WebRTC DataChannels [?] (用于浏览器连接)或uTP(LEDBAT[14])。
- 可靠性:如果底层网络不提供可靠性,IPFS可以提供可靠性。使用uTP(LEDBAT[14])或SCTP[15]。
- 连接性:IPFS也使用ICE的NAT穿越技术[13]。
- 完整性:可选择使用哈希检查和来检查消息的完整性。
- 真实性:通过用发件人的私钥对信息进行数字签名,可选择检查信息的真实性。
3.2.1 Note on Peer Addressing
IPFS可以使用任何网络;它不依赖或假设对IP的访问 。这允许IPFS可以在覆盖网络中使用。IPFS将地址存储为multiaddr格式的字节串,供底层网络使用。Multiaddr提供了一种表达地址及其协议的方式,包括对封装的支持。例如:
# an SCTP/IPv4 connection
/ip4/10.20.30.40/sctp/1234/

# an SCTP/IPv4 connection proxied over TCP/IPv4
/ip4/5.6.7.8/tcp/5678/ip4/1.2.3.4/sctp/1234/
3.3 路由
IPFS节点需要一个能够找到(a)其他对等点的网络地址和(b)能够为特定对象提供服务的对等点的路由系统。IPFS使用一个基于S/Kademlia和Coral的DSHT来实现这一目标,并使用了2.1中讨论的属性。IPFS的对象大小和使用模式类似于Coral[5]和Mainline[16],所以IPFS DHT根据其大小对存储的值进行区分。小的值(等于或小于1KB)直接存储在DHT上。对于较大的值,DHT存储引用,也就是可以为该块提供服务的节点的NodeId。
这个DSHT的界面如下:
type IPFSRouting interface {
FindPeer(node NodeId)
// gets a particular peer’s network address

SetValue(key []bytes, value []bytes)
// stores a small metadata value in DHT

GetValue(key []bytes)
// retrieves small metadata value from DHT

ProvideValue(key Multihash)
// announces this node can serve a large value

FindValuePeers(key Multihash, min int)
// gets a number of peers serving a large value
}
注意:不同的用例会要求有实质上不同的路由系统(例如,广域网中的DHT,本地网络中的静态HT)。因此,IPFS的路由系统可以更换成适合用户需求的系统。只要满足上述接口,系统的其他部分将继续运行。
3.4 区块交换 - BitSwap协议
在IPFS中,通过使用受BitTorrent启发的协议BitSwap与的对等方交换区块来进行数据分发。像BitTorrent一样,BitSwap的对等方希望寻求获得一组的区块(want_list),并有另一组区块作为交换(have_list)。与BitTorrent不同,BitSwap并不局限于一个torrent中的区块。BitSwap作为一个持久的市场运作,节点可以获得他们需要的区块,不管这些区块属于什么文件。这些块可能来自文件系统中完全不相关的文件。节点聚集在一起,在市场上进行易货交易。
虽然易货系统的概念意味着可以创建虚拟货币,但这需要一个全球分类帐来跟踪货币的所有权和转让。这可以作为BitSwap策略来实现,并将在未来的文章中进行探讨。
在基本情况下,BitSwap节点必须以区块的形式向对方提供价值。当节点之间的区块分配是互补的,也就是说,他们拥有对方想要的东西。通常情况下,并非如此。在某些情况下,节点必须为他们的区块工作,一个节点没有它的对等点想要的东西的情况下,它就会寻找其对等点想要的区块,其优先级低于节点自己想要的区块。这就激励了节点去缓存和传播稀有碎片,即使他们对它们不感兴趣。
3.4.1 BitSwap Credit
该协议还必须激励节点在他们不需要任何特别的东西时播种,因为他们可能有别人想要的区块。因此,BitSwap节点将区块给他们的同伴,期待着债务得到偿还,但必须防止水蛭(从不分享的免费加在节点)。一个简单的类似信贷的系统解决了这个问题:
1. 对等节点跟踪他们与其他节点的余额(以字节为单位进行验证)。
2. 节点根据随着债务增加而下降的函数概率性地向债务节点发送块。
请注意,如果节点决定不向对等方发送数据,则该节点会在ignore_cooldown超时期间忽略对等方。这可以防止发送者试图通过造成更多的掷骰子来博弈概率。(默认的BitSwap是10秒)。
3.4.2 BitSwap策略
BitSwap同行可能采用的不同策略对整个交换的性能有截然不同的影响。在BitTorrent中,虽然指定了标准策略(针锋相对),但也有各种其他的策略被实施,从BitTyrant[8](尽可能少的分享)到BitThief[8](利用漏洞,永远不分享),到PropShare[8](按比例共享)。BitSwap对等方可以类似地实施一系列的策略(好的和恶意的)。那么,函数的选择应该以下列为目标:
1.最大化节点和整个交易所的交易性能
2.防止贪婪者利用和破坏交易所
3. 有效应对其他未知的策略
4.对受信任的对等方宽松
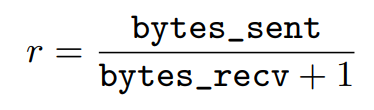
探索这种策略空间是未来的工作。在实践中可行的函数选择是一个由债务比率缩放的sigmoid函数。让一个节点和它的对等体之间的债务比率r为:
给定r,让发送债务人汇款的概率为:
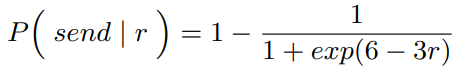
正如在图1中看到的那样,当节点的债务比率超过既定信贷的两倍时,这个函数就会迅速下降。
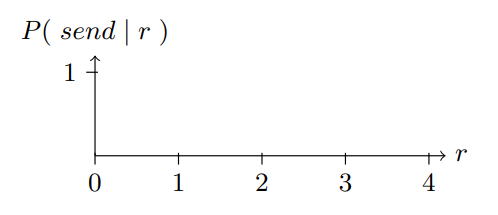
图1:随着r的增加发送的概率
债务比率是衡量信任的标准:对以前成功交换过大量数据的节点之间的债务宽容,而对未知的、不信任的节点无情。这(a)为可能创建大量新节点提供了对攻击者的抵抗力,(b)保护以前成功的贸易关系,即使其中一个节点暂时无法提供价值,以及(c)最终扼杀已经恶化的关系,知道他们改善。
3.4.3 BitSwap Ledger
BitSwap节点保留账本记录与其他节点的传输情况,这使得节点可以跟踪历史并避免被篡改。当激活连接时,BitSwap节点会交换他们的账本信息。如果它不完全匹配,账本将从头开始重新初始化,失去累积的信用或债务。恶意的节点有可能故意“丢失”分类帐,希望消除债务。不太可能的是,节点已经积累了足够的债务,以至于也失去了积累的信任;但是,合作伙伴节点可以自由地将其视为不当行为,并拒绝交易。
type Ledger struct {
owner NodeId
partner NodeId
bytes_sent int
bytes_recv int
timestamp Timestamp
}
节点可以自由地保留账本历史,但对于正确的操作来说并不是必须的。只有当前的账本条目是有用的。节点也可以在必要时自由地对分类账本进行垃圾回收,从不太有用的账本开始:旧的(对等节点可能不存在了)和小分类账。
3.4.4 BitSwap Specification
BitSwap节点遵循一个简单的协议。
// Additional state kept
type BitSwap struct {
ledgers map[NodeId]Ledger
// Ledgers known to this node, inc inactive

active map[NodeId]Peer
// currently open connections to other nodes

need_list []Multihash
// checksums of blocks this node needs

have_list []Multihash
// checksums of blocks this node has
}

type Peer struct {
nodeid NodeId
ledger Ledger
// Ledger between the node and this peer

last_seen Timestamp
// timestamp of last received message

want_list []Multihash
// checksums of all blocks wanted by peer
// includes blocks wanted by peer’s peers
}

// Protocol interface:
interface Peer {
open (nodeid :NodeId, ledger :Ledger);
send_want_list (want_list :WantList);
send_block (block :Block) -> (complete :Bool);
close (final :Bool);
}
对等体连接的生命交换周期图:
1.开放:对等方发送分类账,直到他们达成一致。
2.发送:对等方交换want_lists和block。
3.关闭:对等方停用一个连接。
4.忽略:(特殊)如果一个节点的策略避免发送,那么忽略对等点(在超时期间)
Peer.open(NodeId, Ledger)
连接时,节点用一个Ledger来初始化连接,可以是从过去的连接中存储的,也可以是新连接的归零。然后,向对等方发送一个带有Ledger的Open消息。
收到Open消息后,对等点选择是否激活该连接。如果——根据接收方的账本,发送方不是一个可信任的代理(传输率低于零,或有大量未偿债务),接收方可以选择忽略该请求。这应该通过概率性的忽略_冷却时间,以便允许纠正错误并阻止攻击者。
如果激活连接,接收方使用本地版的Ledger初始化一个Peer对象,并设置last_seen时间戳。然后,它将收到的Ledger和它自己的Ledger进行比较。如果它们完全匹配,则连接就已经打开。如果它们不匹配,对等体创建一个新的归零的Ledger并将其发送。
Peer.send_want_list(WantList)
当连接打开时,节点将他们的want_list通告给所有连接的对等点。这是在(a)打开连接时完成的,(b)在一个随机的周期性超时后,(c)在want_list发生变化后,以及(d)在收到一个新的区块。
在收到want_list后,节点会将其存储起来。然后,它检查它是否有任何想要的区块。如果有,它就根据上面的BitSwap策略来发送它们。
Peer.send_block(Block)
发送一个块是很简单的。节点只需发送数据块。在收到所有的数据后,接收方会计算Multihash校验和,以验证它是否符合预期匹配,并返回确认。
在最终完成一个区块的正确传输后,接收方将该区块从need_list移至have_list,并且接收方和发送方都会更新他们的账本以反映传输的额外字节。
如果传输验证失败,那么发送方要么出现故障,要么攻击接收方。接收方可以自由地拒绝进一步的交易。请注意,BitSwap希望在可靠的传输通道上运行,因此在将数据提供给 BitSwap 之前,预计会发现传输错误——这可能导致对发送者的错误惩罚。
Peer.close(Final)
close的最后一个参数预示着关闭连接的意图是否是发件人的意图。如果是false,接收方可以选择立即重新打开连接。这就避免了过早的关闭。
在两种情况下,对等的连接应该关闭:
- silence_wait超时,而没有收到对等方的任何消息(默认BitSwap使用30秒),节点发出Peer.close(false)。
- 节点正在退出,BitSwap正在关闭。在这种情况下,节点发出Peer.close(true)。
在关闭消息后,接收方和发送方都会断开连接,清除存储的所有状态。如果这样做有用的话,Ledger可以被储存起来以备将来使用。
注意
应该忽略非活动连接上的未开放信息应该。如果是send_block消息下,接收方可以检查该块是否需要,是否正确,如果是,就使用它。无论如何,所有这些乱序的消息都会触发来自接收方的close(false)消息,以强制重新初始化连接。
3.5 Object Merkle DAG
DHT和BitSwap允许IPFS形成一个庞大的点对点系统,用于快速、稳健地存储和分发区块。在此基础上,IPFS建立了一个Merkle DAG,这是一个有向无环图,其中对象之间的链接是嵌入源中的目标的加密哈希值。这是对Git数据结构的一种概括。Merkle DAG为IPFS提供了许多有用的特性,包括:
- 1.内容寻址:所有的内容都是由它的multihash检验和唯一识别的,包括链接。
- 2.防篡改:所有的内容都是通过它的校验和进行验证。如果数据被篡改或损坏,IPFS会检测到它。
- 3.重复数据删除:所有持有完全相同内容的对象都是相同的,并且只存储一次。这对索引对象特别有用,如git树和提交,或共同的部分。
IPFS对象的格式是:
type IPFSLink struct {
Name string
// name or alias of this link

Hash Multihash
// cryptographic hash of target

Size int
// total size of target
}

type IPFSObject struct {
links []IPFSLink
// array of links

data []byte
// opaque content data
}
IPFS Merkle DAG是一种极其灵活的方式来存储数据。唯一的要求是,对象引用是(a)内容寻址,和(b)以上述格式编码。IPFS授予应用程序对数据字段的完全控制权;应用程序可以使用他们选择的任何自定义数据格式,IPFS可能无法理解这些格式。独立的inobject链接表使IPFS能够:
- 列出一个对象中的所有对象引用,例如:
> ipfs ls /XLZ1625Jjn7SubMDgEyeaynFuR84ginqvzb
XLYkgq61DYaQ8NhkcqyU7rLcnSa7dSHQ16x 189458 less
XLHBNmRQ5sJrdMPuu48pzeyTtRo39tNDR5 19441 script
XLF4hwVHsVuZ78FZK6fozf8J9WEURMbCX4 5286 template
<object multihash> <object size> <link name>
- 解决字符串路径查询,如foo/bar/baz。给定一个对象,IPFS将第一个路径组件解析为对象的链接表中的哈希值,获取第二个对象,并重复下一个组件。因此,无论数据格式是什么,字符串路径都可以遍历Merkle DAG。
数据格式是什么。
- 解析递归引用的对象:
> ipfs refs --recursive \
/XLZ1625Jjn7SubMDgEyeaynFuR84ginqvzb
XLLxhdgJcXzLbtsLRL1twCHA2NrURp4H38s
XLYkgq61DYaQ8NhkcqyU7rLcnSa7dSHQ16x
XLHBNmRQ5sJrdMPuu48pzeyTtRo39tNDR5
XLWVQDqxo9Km9zLyquoC9gAP8CL1gWnHZ7z
...
一个原始数据字段和一个共同的链接结构是在IPFS之上构建任意数据结构的必要组成部分。虽然我们很容易看到Git对象模型适合这个DAG,但请考虑以下其他的潜在的数据结构:(a) 键值存储 (b) 传统的关系型数据库 (c) 关联数据三重存储 (d) 链接文档发布系统 (e) 链接通信平台 (f) 加密货币区块链。这些都可以在IPFS Merkle DAG的基础上进行建模,这允许这些系统中的任何一个都可以使用IPFS作为更复杂的应用程序的传输协议。
3.5.1 路径
可以通过一个字符串路径API遍历IPFS对象。路径的工作方式与传统UNIX文件系统和Web中的工作方式相同。Merkle DAG链接使遍历变得容易。
请注意,IPFS中的完整路径采用以下形式:
# format
/ipfs/<hash-of-object>/<name-path-to-object>

# example
/ipfs/XLYkgq61DYaQ8NhkcqyU7rLcnSa7dSHQ16x/foo.txt
/ipfs前缀允许在标准安装点到现有的系统中而不发生冲突(安装点名称当然是可配置的)。第二个路径组件(IPFS中是第一个)是一个对象的散列。情况总是这样,因为没有全局根。根对象将有一个不可能完成的任务。相反,我们使用内容寻址来模拟根,所有的对象总是可以通过其哈希访问。请注意,这意味着在路径<foo>/bar/baz中的三个对象,所有对象都可以访问最后一个对象:
/ipfs/<hash-of-foo>/bar/baz
/ipfs/<hash-of-bar>/baz
/ipfs/<hash-of-baz>/baz
3.5.2 本地对象
IPFS客户端需要一些本地存储,一个外部系统,用于存储和检索IPFS管理的对象的本地原始数据。存储的类型取决于节点的使用情况。在大多数情况下,这仅仅是一部分磁盘空间(要么由本地文件系统管理,要么由一个键值存储器[4],或者直接由IPFS客户端管理)。
在其他情况下,例如非持久性缓存,这种存储只是RAM的一部分。
最终,IPFS中所有可用的块都在某个节点的本地存储中。当用户请求对象时,它们会在本地找到、下载和存储,至少是暂时的。这为之后的一些可配置的时间内提供了快速查找。
3.5.3 Object Pinning
希望确保特定对象生存的节点可以通过pinning对象来实现。这可以确保对象保存在节点的本地存储中。Pinning可以递归地进行,以pinnig所有链接的后代对象。然后,所有被指向的对象都被保存在本地。这对持久化文件特别有用,包括引用。
这也使得IPFS成为一个链接是永久的Web,并且对象可以确保他们所指向的其他对象的生存。
3.5.4 发布对象
IPFS是全球分布的,它旨在让数以百万计的用户的文件共存在一起。具有内容哈希寻址的DHT允许以一种公平、安全和完全分布式的方式发布对象。任何人都可以发布一个对象,只需将其密钥添加到DHT中,将自己添加为对等体,并向其他用户提供该对象的路径。请注意,对象本质上是不可改变的,就像在Git一样。新版本的哈希值不同,因此也是新的对象。追踪版本是额外版本管理对象的工作。
3.5.5 Object-level Cryptography
IPFS具备处理对象级加密操作的能力。加密或签名的对象被包裹在一个特殊的帧中,允许对原始字节进行加密或验证。
type EncryptedObject struct {
Object []bytes
// raw object data encrypted

Tag []bytes
//  optional tag for encryption groups
}

type SignedObject struct {
Object []bytes
//  raw object data signed

Signature []bytes
// hmac signature

PublicKey []multihash
//multihash identifying key
}
加密操作改变了对象的哈希值,定义了一个不同的对象。IPFS自动验证签名,并可以用用户指定的密钥链解密数据。加密对象的链接也被保护起来,没有解密密钥就不可能进行遍历。可以有一个父对象在一个密钥下被加密,而子对象在另一个密钥下被加密或者根本不加密。这可以保护到共享对象的链接。
3.6 文件
IPFS还定义了一组对象,用于在Merkle DAG的基础上对版本化的文件系统进行建模。这个对象模型类似于Git的:
1.块:可变大小的数据块。
2.列表:块或其他列表的集合。
3.树:块、列表或其他树的集合。
4.提交:树的版本历史中的快照。
我们希望完全使用Git的对象格式,但不得不离开介绍在分布式文件系统中有用的功能,即 (a) 快速查找大小(聚合字节大小添加到对象中),(b) 大文件重复数据删除(增加了列表对象),以及(c)将提交嵌入到树中。但是,IPFS文件对象与Git足够接近,因此两者之间的转换是可能的。另外,可以引入一组Git的对象进行转换,而不会丢失任何信息(unix文件权限等等)。
Notation:下面的文件对象格式使用JSON。需要注意的是,这个结构实际上是使用protobufs进行二进制编码的,尽管ipfs包括导入/导出到JSON。
3.6.1 文件对象:blob
blob对象包含一个可寻址的数据单位,并表示一个文件. IPFS块类似于Git的blob或文件系统数据块。它们存储用户的数据。请注意,IPFS文件既可以用列表也可以用Blob表示。Blob没有链接。
{
"data": "some data here"
// blobs have no links
}
3.6.2 文件对象:列表
列表对象表示由多个IPFS的blob串联在一起组成的大型或去重文件。列表包含一个blob或列表对象的序列。从某种意义上,IPFS列表的功能就类似于具有在直接块的文件系统文件。由于列表可以包含其他列表,包括链接列表和平衡树在内的拓扑结构是可能的。同一个节点出现在多个地方的定向图允许文件内重复数据删除。当然,循环是不可能的,正如哈希寻址所强制的那样。
{
"data": ["blob", "list", "blob"],
// lists have an array of object types as data
"links": [
{ "hash": "XLYkgq61DYaQ8NhkcqyU7rLcnSa7dSHQ16x", "size": 189458 },
{ "hash": "XLHBNmRQ5sJJrdMPuu48pzeyTtRo39tNDR5", "size": 19441 },
{ "hash": "XLWVQDqxo9Km9zLyquoC9gAP8CL1gWnHZ7z", "size": 5286 }
// lists have no names in links
]
}
3.6.3 文件对象:树
IPFS中的树对象类似于Git:它表示一个目录,一个名字与哈希值的映射。哈希值引用了blobs,列表,其他树或提交。请注意,Merkle DAG已经实现了传统的路径命名。
{
"data": nil,
// trees have no data, only links
"links": [
{ "hash": "XLYkgq61DYaQ8NhkcqyU7rLcnSa7dSHQ16x", "name": "less", "size": 189458 },
{ "hash": "XLHBNmRQ5sJJrdMPuu48pzeyTtRo39tNDR5", "name": "script", "size": 19441 },
{ "hash": "XLWVQDqxo9Km9zLyquoC9gAP8CL1gWnHZ7z", "name": "template", "size": 5286 }
// trees do have names
]
}
3.6.4 文件对象:提交
IPFS中的提交对象代表了任何对象的版本历史的快照。它类似于Git,但可以引用任何类型的对象,它还可以链接到作者对象。
{
 "data": {
 "type": "tree",
"date": "2014-09-20 12:44:06Z",
"message": "This is a commit message."
},
"links": [
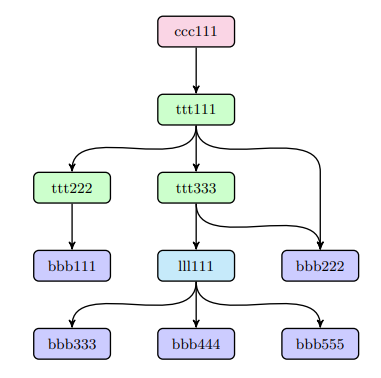
图2:示例对象图
> ipfs file-cat  --json
{
"data": {
"type": "tree",
"date": "2014-09-20 12:44:06Z",
"message": "This is a commit message." },
"links": [
{ "hash": "", "name": "parent", "size": 25309 },
{ "hash": "", "name": "object", "size": 5198 },
{ "hash": "", "name": "author", "size": 109 }
]
}

> ipfs file-cat  --json
{
"data": nil,
"links": [
{ "hash": "", "name": "ttt222-name", "size": 1234 },
{ "hash": "", "name": "ttt333-name", "size": 3456 },
{ "hash": "", "name": "bbb222-name", "size": 22 }
]
}

> ipfs file-cat  --json
{
"data": "blob222 data",
"links": []
}
图3:示例对象
{ "hash": "XLa1qMBKiSEEDhojb9FFZ4tEvLf7FEQdhdU", "name": "parent", "size": 25309 },
{ "hash": "XLGw74KAy9junbh28x7ccWov9inu1Vo7pnX", "name": "object", "size": 5198 },
{ "hash": "XLF2ipQ4jD3UdeX5xp1KBgeHRhemUtaA8Vm", "name": "author", "size": 109 }
]
}
3.6.5 版本控制
提交对象代表了对象版本历史上的特定快,比较两个不同提交的对象(和子对象),可以发现文件系统的两个版本之间的差异。只要一个提交对象和它所引用的所有子对象都可以访问。就可以检索到之前的所有版本,并且可以访问文件系统更改的完整历史记录。这不属于Merkle DAG 对象模型。
IPFS用户可以使用Git版本控制工具的全部功能。对象模型是兼容的,虽然不相同的。可以 (a) 建立一个经过修改为使用IPFS对象图的Git工具版本,(b) 构建一个挂载了 IPFS 的FUSE 文件系统,将 IPFS 树挂载为Git repo。将Git文件系统的读/写转换为IPFS格式。
3.6.6 文件系统路径
正如我们在Merkle DAG部分看到的,IPFS对象可以可以通过字符串路径API进行遍历。IPFS文件对象旨在使IPFS安装到UNIX文件系统上更加简单。它们将树限制为没有数据,以便以表示它们是目录。而提交可以是表示为目录,或者从文件系统中完全隐藏。
3.6.7 将文件分割成列表和Blob
版本管理和分发大文件的主要挑战之一是找到正确的方法将它们分割成独立的块。与其假设它能为每一种类型的文件做出正确的决定,IPFS提供了以下几种替代方案:
(a) 使用LBFS [?]中的Rabin Fingerprints)[?]来挑选合适的区块边界。
(b) 使用rsync [?]的rolling-checksum算法,以检测版本之间发生变化的块。
(c) 允许用户指定针对为特定的文件指定高度的块分割功能。
3.6.8 路径查找性能
基于路径的访问会遍历对象图。检索每个对象都需要在DHT中查找其键,连接到对等点,并检索其块。这是相当大的的开销,特别是当查询有许多组件的路径时。这一点可以通过以下方式得到缓解:
- 树状缓存:因为所有的对象都是哈希寻址的,因此可以被无限期地缓存起来。此外,树倾向于小尺寸,所以IPFS优先缓存它们而不是Blob。
- 扁平树:对于任何给定的树,可以构建一个特殊的扁平树来列出所有可以从树上到达的对象。扁平化树中的名称实际上是与原始树分开的路径,带斜线。
例如,上述tt111的扁平化树:
{
"data":
["tree", "blob", "tree", "list", "blob" "blob"], "links": [
{ "hash": "", "size": 1234 "name": "ttt222-name" },
{ "hash": "", "size": 123, "name": "ttt222-name/bbb111-name" },
{ "hash": "", "size": 3456, "name": "ttt333-name" },
{ "hash": "", "size": 587, "name": "ttt333-name/lll111-name"},
{ "hash": "", "size": 22, "name": "ttt333-name/lll111-name/bbb222-name" },
{ "hash": "", "size": 22 "name": "bbb222-name" }
] }
3.7 IPNS:命名和可变状态
到目前为止,IPFS栈形成了一个点对点的块交换,构建一个对象的内容寻址DAG。它用来发布和检索不可变的对象。它甚至可以跟踪这些对象的版本历史。然而,缺少了一个关键组件:可变的命名。没有它。所有关于新内容的通信都必须发生在带外。发送IPFS链接。所需要的是某种方式在统一路径来检索可变的状态。
值得说明的原因是——如果可变数据最终是必要的——我们努力工作建立一个不可变的Merkle DAG。考虑一下不属于Merkle DAG的IPFS的属性:对象可以(a)通过它们的哈希值被检索,(b) 完整性检查,(c) 链接到其他对象,以及(d) 无限期地缓存。从某种意义上来说:
对象是永久的
这些都是高性能分布式系统的关键属性,其中数据在网络链接中的移动的成本是很昂贵的。对象内容寻址构建的网络具有(a)显著的带宽优化,(b)不受信任的内容服务,(c)永久链接,以及(d)对任何对象及其引用进行完全永久备份的能力。
Merkle DAG(不可变的内容寻址对象)和Naming(指向Merkle DAG的可变指针),实例化了许多成功的分布式系统中存在的二分法。这些系统包括Git版本控制系统,它具有不可变的对象和可变的引用;以及Plan9 [?]是UNIX的分布式继承者,它有可变的Fossil[?]和不可变的Venti[?]文件系统。LBFS[?]也使用可变的索引和不可变的块。
3.7.1 自我认证的名称
使用SFS[12, 11]的命名方案给了可以在一个加密分配的全局名称空间中构建自我认证的名称,这些名称是可变的。IPFS方案如下:
1. 回顾一下,在IPFS中:
NodeId = hash(node.PubKey)
2.我们给每个用户分配一个可变的名字空间:
/ipns/<NodeId>
3.用户可以将对象发布到由她的私钥签名的此路径,例如:
/ipns/XLF2ipQ4jD3UdeX5xp1KBgeHRhemUtaA8Vm/
4. 当其他用户检索该对象时,他们可以检查签名是否与公钥和NodeId相符。这验证了由用户发布的对象的真实性,实现了可变状态的检索。
注意以下细节:
- ipns(InterPlanetary Name Space)的单独前缀是为了对于程序和人类读者建立可变路径和不可变路径之间的易于识别的区别。
- 因为这不是一个内容寻址的对象,所以发布它依赖的是IPFS中唯一的可变状态分布系统,即路由系统。其过程是(1) 将该对象作为一个常规的不可变的IPFS对象,(2)在路由系统上发布其哈希值,作为一个元数据值。
routing.setValue(NodeId, <ns-object-hash>)
已发布的对象中的任何链接都充当命名空间的子名称:
/ipns/XLF2ipQ4jD3UdeX5xp1KBgeHRhemUtaA8Vm/
/ipns/XLF2ipQ4jD3UdeX5xp1KBgeHRhemUtaA8Vm/docs
/ipns/XLF2ipQ4jD3UdeX5xp1KBgeHRhemUtaA8Vm/docs/ipfs
建议发布一个提交对象,或者其他一些具有版本历史的的对象,这样客户端就可以能够找到旧的名字。这是个用户选项,因为它并不总是需要的。
注意,当用户发布这个对象时,不能以同样的方式发布。
3.7.2 人性化的名称
虽然IPNS确实是一种分配和重新分配名字的方式,但它对用户并不友好,因为它把长的哈希值作为名称公开,众所周知,这是很难记住的。这对URL来说是可行的,但不适用于许多种类的离线传输。因此,IPFS通过以下技术增加了IPNS的用户友好性。
Peer Links
正如SFS所鼓励的那样,用户可以将其他用户的对象直接链接到他们自己的对象中(命名空间、主页等)。这样做的好处是可以创建一个信任网(并且支持旧的证书机构模式):
# Alice links to Bob
ipfs link /<alice-pk-hash>/friends/bob /<bob-pk-hash>

# Eve links to Alice
ipfs link /<eve-pk-hash>/friends/alice /<alice-pk-hash>

# Eve also has access to Bob
/<eve-pk-hash>/friends/alice/friends/bob

# access Verisign certified domains
/<verisign-pk-hash>/foo.com
DNS TXT IPNS记录
如果/ipns/<domain>是有效的域名,IPFS在其DNS TXT中查找关键ipns。IPFS将该值解释为是一个对象哈希值或另一个IPNS路径:
# this DNS TXT record
ipfs.benet.ai. TXT "ipfs=XLF2ipQ4jD3U ..."

# behaves as symlink
ln -s /ipns/XLF2ipQ4jD3U /ipns/fs.benet.ai
Proquint可发音标识符
一直以来,都有将二进制编码为可发音的词的方案。IPNS支持Proquint[?]。因此:
# this proquint phrase
/ipns/dahih-dolij-sozuk-vosah-luvar-fuluh

# will resolve to corresponding
/ipns/KhAwNprxYVxKqpDZ
名称缩短服务
势必会出现一些服务,将提供名称缩短服务,向用户提供他们的命名空间。
这类似于我们今天看到的DNS和Web URL:
# User can get a link from
/ipns/shorten.er/foobar

# To her own namespace
/ipns/XLF2ipQ4jD3UdeX5xp1KBgeHRhemUtaA8Vm
3.8 使用IPFS
IPFS被设计成可以在许多不同的方面使用。
下面是我要追求的一些使用案例:
1.作为一个挂载的全局文件系统,在/ipfs和/ipns下。
2.作为已安装的个人同步文件夹,可自动对任何人写入进行版本、发布和备份。
3.作为加密的文件或数据共享系统。
4.作为所有软件的版本包管理器。
5.作为虚拟机的根文件系统。
6.作为虚拟机的启动文件系统(在管理程序下)。
7.作为数据库:应用程序可以直接写入Merkle DAG数据模型,并获得IPFS提供的所有的版本控制、缓存和分发。
8.作为一个链接的(和加密的)通信平台。
9.作为大文件(无SSL)的完整性检查CDN。
10. 作为一个加密的CDN。
11. 在网页上,作为一个网络CDN。
12. 作为一个新的永久网络,链接不会消失。
IPFS的实施目标是:
(a) 在自己的应用程序中导入一个IPFS库。
(b) 直接操作对象的命令行工具。
(c) 安装文件系统,使用FUSE[?]或作为内核模块。
4. 未来
IPFS背后的想法是几十年来在学术界和开源成功的分布式系统研究的产物,IPFS综合了迄今为止最成功的系统中的许多最佳理念。除了BitSwap这种新颖的协议之外,IPFS的主要贡献是系统的耦合和设计的综合。
IPFS是对新的去中心化的互联网基础设施的雄心勃勃的愿景,在此基础上可以建立许多不同类型的应用。最低限度,它可以被用作一个全局性的、安装的、版本化的文件系统和命名空间,或作为下一代的文件共享系统。在其最好的情况下,它可以将网络推向新的境界,在那里,发布有价值的信息并不强加给发布者,而是托管给那些感兴趣的人。用户可以信任他们所收到的内容,而无需信任他们从总接收信息的同行,并且旧的但重要的文件也不会丢失。IPFS期待着把我们带向永久网络。
5.致谢
IPFS是许多伟大思想和系统的综合体。如果没有站在这些巨人的肩膀上,就不可能敢于实现如此宏大的目标。个人感谢David Dalrymple、Joe Zimmerman和Ali Yahya,感谢他们对许多想法的长期讨论,特别是:暴露了一般的Merkle DAG(Joe Zimmerman),滚动哈希阻塞(David),以及s/kademlia sybil保护(David, Ali)。还有特别感谢David Mazieres,感谢他一直以来的精彩观点。
6. 参考文献
[1] I. Baumgart and S. Mies. S/kademlia: A practicable approach towards secure key-based routing. In Parallel and Distributed Systems, 2007 International Conference on, volume 2, pages 1–8. IEEE, 2007.
[2] I. BitTorrent. Bittorrent and ¸ttorrent software surpass 150 million user milestone, Jan. 2012.
[3] B. Cohen. Incentives build robustness in bittorrent. In Workshop on Economics of Peer-to-Peer systems, volume 6, pages 68–72, 2003.
[4] J. Dean and S. Ghemawat. leveldb–a fast and lightweight key/value database library by google, 2011.
[5] M. J. Freedman, E. Freudenthal, and D. Mazieres. Democratizing content publication with coral. In NSDI, volume 4, pages 18–18, 2004.
[6] J. H. Howard, M. L. Kazar, S. G. Menees, D. A. Nichols, M. Satyanarayanan, R. N. Sidebotham, and M. J. West. Scale and performance in a distributed file system. ACM Transactions on Computer Systems (TOCS), 6(1):51–81, 1988.
[7] J. Kubiatowicz, D. Bindel, Y. Chen, S. Czerwinski, P. Eaton, D. Geels, R. Gummadi, S. Rhea, H. Weatherspoon, W. Weimer, et al. Oceanstore: An architecture for global-scale persistent storage. ACM Sigplan Notices, 35(11):190–201, 2000.
[8] D. Levin, K. LaCurts, N. Spring, and B. Bhattacharjee. Bittorrent is an auction: analyzing and improving bittorrent’s incentives. In ACM SIGCOMM Computer Communication Review, volume 38, pages 243–254. ACM, 2008.
[9] A. J. Mashtizadeh, A. Bittau, Y. F. Huang, and D. Mazieres. Replication, history, and grafting in the ori file system. In Proceedings of the Twenty-Fourth ACM Symposium on Operating Systems Principles, pages 151–166. ACM, 2013.
[10] P. Maymounkov and D. Mazieres. Kademlia: A peer-to-peer information system based on the xor metric. In Peer-to-Peer Systems, pages 53–65. Springer, 2002.
[11] D. Mazieres and F. Kaashoek. Self-certifying file system. 2000.
[12] D. Mazieres and M. F. Kaashoek. Escaping the evils of centralized control with self-certifying pathnames. In Proceedings of the 8th ACM SIGOPS European workshop on Support for composing distributed applications, pages 118–125. ACM, 1998.
[13] J. Rosenberg and A. Keranen. Interactive connectivity establishment (ice): A protocol for network address translator (nat) traversal for offer/answer protocols. 2013.
[14] S. Shalunov, G. Hazel, J. Iyengar, and M. Kuehlewind. Low extra delay background transport (ledbat). draft-ietf-ledbat-congestion-04. txt, 2010.
[15] R. R. Stewart and Q. Xie. Stream control transmission protocol (SCTP): a reference guide. Addison-Wesley Longman Publishing Co., Inc., 2001.
[16] L. Wang and J. Kangasharju. Measuring large-scale distributed systems: case of bittorrent mainline dht. In Peer-to-Peer Computing (P2P), 2013 IEEE Thirteenth International Conference on, pages 1–10. IEEE, 2013.
---煤油灯科技victorlamp.com翻译整理---
