美国加州大学伯克利分校的一组研究人员介绍了一种方法,这个方法可以让机器人在60分钟内学会走路。这种技术与传统的深度强化学习方法不同,在这种技术中,机器人可以在没有模拟器的情况下进行训练。该项目名为“DayDreamer:物理机器人学习的世界模型”,该项目由Philipp Wu、Alejandro Escontrela、Danijar Hafner、Ken Goldberg和Pieter Abbeel领导。根据研究人员的说法,“Dreamer” 算法可以通过学习世界模型中的规划,从少量交互中学习,进而在电子游戏中比纯强化学习表现更好。
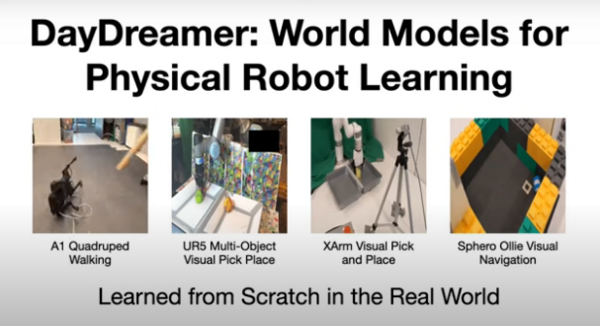
DayDreamer:强化学习的另一种方法
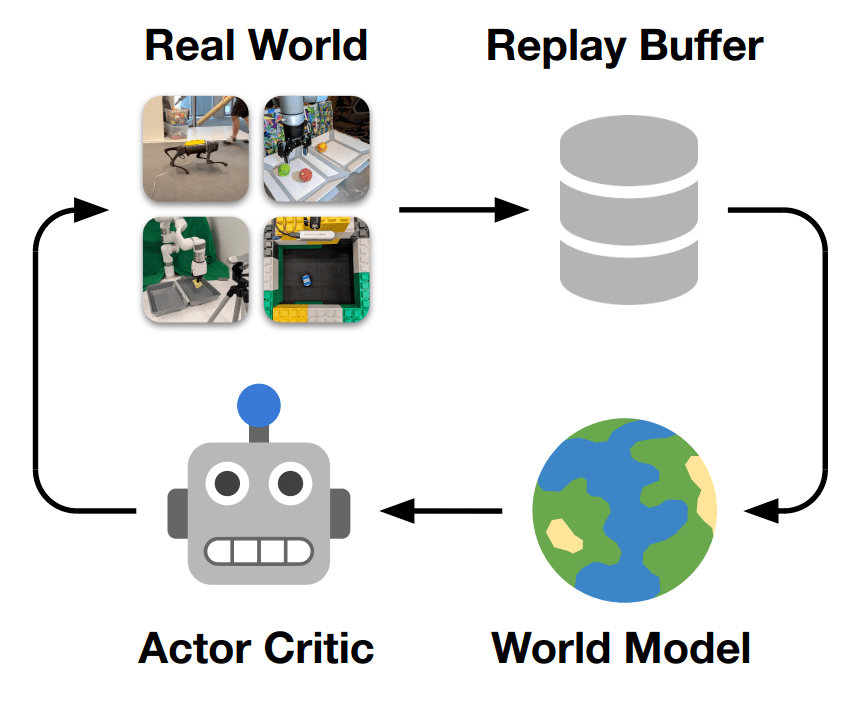
Dreamer 世界模型是谷歌、多伦多大学等机构在 2021 年提出的一种。Dreamer 从过去经验的回放缓存中学习世界模型,从世界模型的潜在空间中想象的 rollout 中学习行为,并不断与环境交互以探索和改进其行为。研究者的目标是在现实世界中推动机器人学习的极限,并提供一个强大的平台来支持未来的工作。
机器人面临的一个根本挑战是让机器人具备在现实世界中解决复杂任务的能力。深度强化学习(RL)是一种流行的方法,使机器人通过试错进行学习。目前基于强化学习的算法需要与模拟环境进行过多的交互才能学习成功的行为,这使得它们对许多现实世界的任务不切实际。
在DayDreamer项目中,研究人员将Dreamer算法应用于四个机器人,让它们在现实世界中直接学习。他们能够克服不同的行动空间、感觉模式和奖励结构等挑战。
总体来说,这项研究的贡献在于:
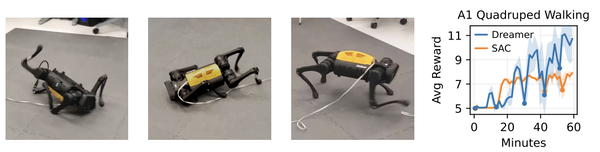
- A1 Quadrap——研究人员在没有任何模拟器的情况下,直接在端到端强化学习设置中训练机器人。他们从零开始训练Unitree A1机器人,该机器人由12个直接驱动电机组成。在10分钟内,机器人就能适应并学会承受外界刺激,比如推和拉。
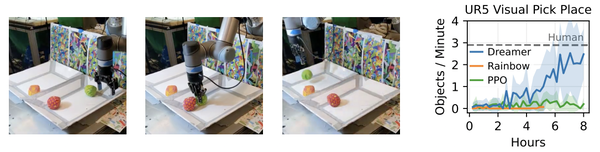
- UR5多目标视觉拾取和放置——机器人手臂被训练来拾取和放置球。这个过程包括从第三人称摄像机图像定位球,抓住它们,并将它们移动到指定的箱子。Dreamer算法能在8小时内达到平均每分钟2.5个物体的拾取速度。
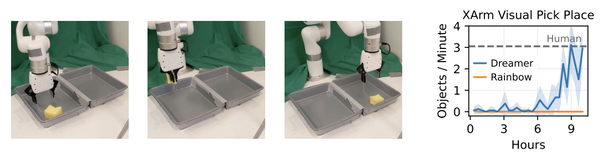
- XArm视觉拾取和放置——对于XArm,团队使用了具有RGB和深度模式的第三人称RealSense相机,以及机器人手臂的本体感觉输入,需要世界模型学习传感器融合,同时需要世界模型学习机器人手臂的本体感觉输入,需要世界模型学习传感器融合。在这里,一个柔软的物体被用来代替球,这是一个模拟的挑战。XArm成功地在10小时内完成了这项任务。
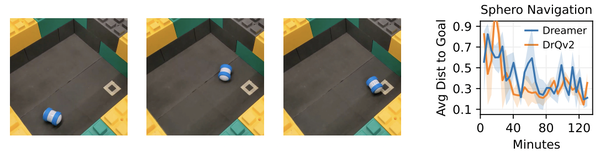
- Sphero Navigation——这个任务由一个名为Sphero Ollie的机器人通过连续的动作导航到一个指定的位置,唯一的感官输入是自上而下的RGB图像。机器人通过像素来确定自己的位置,并通过一系列过去的图像来推断自己的方向,并通过欠驱动的电机来控制机器人,这些电机会随着时间的推移而积累动量。Spero ollie在2小时内学会了这个任务。
DayDreamer与MIT的猎豹
在DayDreamer的开发之前,麻省理工学院人工智能实验室的另一个团队也在做一个类似的项目,这个团队开发了微型猎豹,那是当时移动最快的四倍机器人。
猎豹的控制器基于一种神经网络架构,它使用强化学习在模拟中进行训练,然后将其转移到现实世界中。猎豹的性能是通过两个基准来衡量的:(1)速度命令的自适应课程和(2)利用之前的工作进行模拟到真实转移的在线系统识别策略。
这个模型可以在3小时的实际时间内积累100天的不同地形的经验,虽然这是Dreamer模型所需训练时间的三倍,但在强化学习领域这是一个重大的成就。
人工智能机器人的未来
研究人员表示,Dreamer模型方法可以在不改变超参数的情况下解决机器人的运动、操作和导航任务。Dreamer教一个四足机器人从背上滚下来,站起来,从头开始步行1小时,这之前需要大量的模拟训练,然后转移到现实世界或参数化轨迹生成器,并给出重置策略。
虽然Dreamer取得了很好的成果,但长时间的硬件学习对机器人造成了磨损,可能需要人类干预或修复。此外,通过长时间的训练,还需要更多的工作来探索Dreamer的极限和基线。
原文链接:https://analyticsindiamag.com/this-robot-used-dreamer-algorithm-to-learn-walking-in-60-minutes/
