摘要
近年来,深度学习已经成为网络安全领域一种非常有价值的工具,因为它可以帮助网络入侵检测系统对攻击进行分类并检测新的攻击。对抗性学习是利用机器学习来生成一组受干扰的输入,然后输入到神经网络来错误分类的过程。目前对抗性学习领域的许多工作都是在图像处理和自然语言处理方面进行的,采用了各种各样的算法。我们感兴趣的两种算法是深度神经网络的弹性网络攻击和文本攻击。在实验中,我们将EAD和TextAttack算法应用于域名系统放大分类器,该算法用于生成恶意的分布式拒绝服务对抗实例,然后作为输入提供给网络入侵检测系统神经网络,以分类为有效流量。我们在这项工作中表明,图像处理和自然语言处理对抗学习算法可以应用于网络入侵检测神经网络。
1.引言
现代网络入侵检测系统(NIDS)一直在发展,以利用当前人工智能和机器学习,即深度学习的进展。深度学习通过实现神经网络嵌入,深度学习技术的引入使NIDS能够在更大范围内检测网络威胁。虽然神经网络在网络攻击分类领域的应用相对较新,但围绕机器学习分类在图像处理和自然语言处理(NLP)等其他领域的应用已经有了广泛的研究。研究人员发现,神经网络特别容易受到对抗性攻击,即对要分类的数据进行干扰,以欺骗神经网络接收不正确的分类。
然而,如[图1]所示,对抗性攻击已经成为神经网络的真正威胁。虽然这些攻击可能造成重大后果,但在网络安全领域,这些后果会被放大。依赖配备了神经网络的NIDS的公司和组织可能容易受到严重的渗透。这些NIDS的实现很容易受到这些攻击,并向恶意参与者暴露有价值的信息。
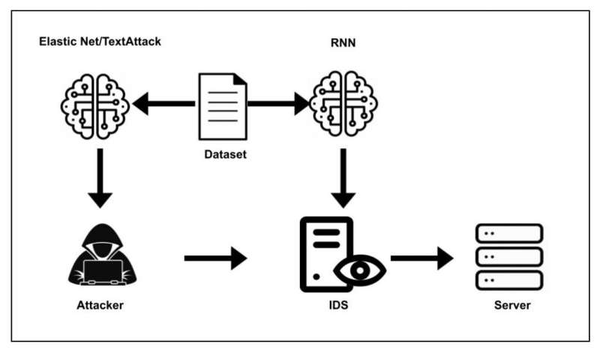
图1.实验结构示意图
在图像处理中,已经开发了许多攻击算法来实现这一目标,如Carlini & Wagner Attack,Deepfool,和快速梯度符号法(FGSM)。在这方面,有一种算法表现出了优越性,那就是深度神经网络弹性网络攻击(EAD)。EAD算法已经与目前的深度神经网络(DNN)对抗攻击算法进行了比较,并在最小扰动的情况下优于其他算法。这些算法凸显了现代DNN的脆弱性,图像分类器可以通过对图像的少量扰动有效地欺骗。
自然语言处理领域的对抗算法研究也产生了许多优秀的算法。这些算法是为自然语言处理量身定制的,因此与图像处理算法有很大的不同。NLP数据是离散的,而图像是连续的,因此需要非常专门的算法来保持被干扰文本的语法结构,而图像的像素可以沿着颜色光谱连续被干扰。TextAttack算法越来越受欢迎,TextAttack接收文本数据,并通过替换字典中的单词、删除单词中的字符、甚至向单词添加字符来对其进行干扰。就像在图像分类中一样,NLP分类器会被输入的最小扰动所欺骗。
NIDS 利用神经网络的范围为恶意行为者破坏网络提供了新的攻击向量。这对在网络入侵环境中实现的神经网络的实际弹性以及这些算法的适用性提出了质疑。
本文研究和实验设计了一个能够有效检测DNS扩增攻击的神经网络,并利用EAD算法和TextAttack算法生成会被错误分类的对抗示例(AEs),使用KDD DDoS-2019数据集中的数据创建和训练了一个模型,该数据集包含多种类型的DDoS攻击,其中使用了DNS扩增数据。图[2]展示了本文实验的可视化表示,图[2]强调了实验的白盒属性与共享数据集。攻击者和IDS对他们的模型使用相同的数据集。在IDS方面,受害者使用数据集创建一个神经网络来分类DNS扩增攻击,而攻击者利用相同的数据基于受害者的模型创建AEs。在这个项目中,我们比较了图像处理和NLP对抗算法如何在网络数据上工作。我们形成一个神经网络,对KDD DNS数据进行训练,并应用这些算法对其进行训练。
2.相关工作
目前对抗性学习领域的工作正在不断增长,这项技术正以新奇有趣的方式被应用。最著名的对抗性学习方法是FGSM,这是一种欺骗神经网络的有效方法。针对FGSM提出了两种方法:躲避和模拟。躲避使分类器错误地分类一个正常的对象,而模拟使分类器认为攻击者是一个有效的用户/对象。FGSM是白盒攻击。两种模式均使用FGSM攻击不同扰动大小的人脸识别神经网络,以确定最合适的扰动量。结果表明,随着扰动的增加,躲避的识别率降低,模仿的识别率增加。
这类攻击的其他例子包括:DeepFool方法,Carlini & Wagner方法, Elastic Net Attack方法。DeepFool方法实现了一种针对卷积神经网络(CNN)生成AEs的新方法。与FGSM相比,该方法对图像分类器进行了更精细的干扰。另一种著名的方法是Carlini & Wagner方法,该方法被证明优于DeepFool方法。Carlini & Wagner攻击利用损失函数来生成AEs以及距离损失来评估AE和原始图像之间的变化量。
下一个值得一提的方法是Elastic-Net算法。该方法建立在Carlini & Wagner方法的基础上,将生成AEs的过程视为正则化问题。结果表明,与前面提到的其他方法相比,这种新方法产生的AEs扰动更少。除了生成AEs,这些研究还表明,他们的算法可以通过对抗性训练使神经网络更健壮。对抗性训练是使用生成的AEs对模型进行训练,使其对攻击更具弹性的过程。
EAD算法在针对深度学习NIDS实现,并对其他著名算法进行了评估,包括:投影梯度下降(PGD)、动量迭代法、DeepFool和Carlini & Wagner。在DDoS分类器上对这些算法进行了测试,每个算法都被证明能够有效地欺骗模型。虽然这些算法最初是为图像处理而设计的,但它们也可以应用到其他领域,即NIDS。
虽然NLP对抗算法与EAD等算法有着相同的目标,但它们的方法却截然不同。基于BERT的对抗示例(BAE)攻击强调了NLP对抗算法是如何工作的。由于数据是离散的,NLP对抗算法需要在处理离散数据的同时保持被扰动数据的语法正确性。BAE的工作原理是在句子中替换单词和插入新词,可以插入或使用多个令牌来屏蔽单词,BAE会选择最优的解决方案,BAE算法为离散数据集的AEs生成提供了一种有效的方法。
在NLP领域中,攻击算法也是一个日益发展的课题。TextAttack是NLP攻击的一个特别有趣的工具。TextAttack专注于文本扩充,并实现了许多有文档的攻击。自定义攻击也可以用TextAttack制作。TextAttack是开源的,提供了一个健壮的框架,可以以多种方式修改文本,包括单个字符操作和同义词替换。除了文本扩充,TextAttack还可以训练分类器并运行预定义的攻击。
3.预备
3.1.DNS放大攻击
在网络攻击领域,DoS (denial of service)和DDoS (distributed denial of service)攻击是一种严重且持续存在的威胁。攻击者试图通过网络发送大量数据包,目标是特定的服务器或系统,其意图是压倒性的,并最终迫使设备在DoS攻击中脱机,DDoS攻击的关键在于有多台设备进行攻击。
通常DoS攻击利用受害者系统使用的某些协议。域名系统(DNS)是一种特别适合利用的协议,DNS主要负责将设备的IP地址转换为可读的域名。该协议为恶意行为者提供了一个独特的攻击向量。攻击者可以很容易地欺骗受害者的IP地址,并向一个开放的DNS服务器发送DNS名称查找请求,该服务器将向受害者发送响应,这被称为放大攻击。对DNS服务器的请求明显小于响应。DNS扩增攻击简单有效,且由于DNS的开放性,难以防范。图[2]显示了DNS Amplification攻击的攻击流程。
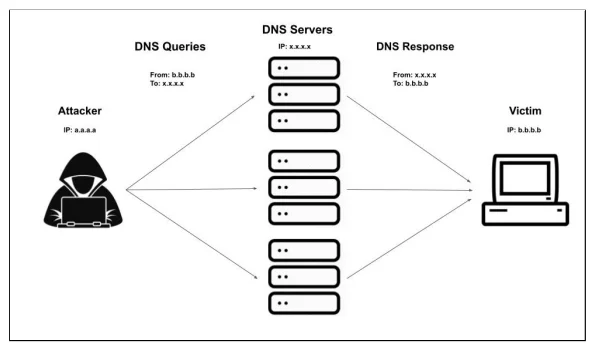
图2. DNS 放大示意图
3.2. 递归神经网络
RNN 是一种按顺序学习的神经网络,传递到 RNN 的数据是数据点在时间上是连续的和相关的。RNN 架构使用称为长短期记忆 (LSTM) 的机器学习技术,其作用类似于记忆块。这种机制获取当前输入、先前输入和先前输入的记忆,并决定是否更新记忆单元并输出存储单元的状态。这对于检测 DoS 攻击很有用,因为数据包之间的时间关系是确定攻击是否发生的关键因素。
3.3. 对抗学习
对抗性学习是机器学习过程,在生成真实的合成数据中起着关键作用。生成的数据用于机器学习嵌入式模型的稳健训练,以实现一致的分类。这些生成的输入被称为对抗样本(AE)。最著名的对抗性学习算法是 FGSM 和 Carlini & Wagner ,他们可以是白盒或黑盒。当用于训练目标神经网络的数据以及模型结构已知时,就会发生白盒攻击。然而,在黑盒攻击中,白盒攻击中可用的信息一无所知。对抗性学习的大部分工作都是在图像处理中完成的,这为将其应用于使用深度学习的入侵检测系统提供了机会。作者表明 EAD 算法可以胜过许多其他常用算法,EAD 方法是一种白盒攻击,因为它依赖于使用相同的模型来学习它如何预测值并分配损失以修改将被错误分类的输入。
4.方法
4.1.威胁模型
在EAD攻击中,攻击者将拥有对数据和模型的白盒访问权,EAD算法将使用该模型来确定对数据的最优扰动。对于TextAttack,攻击者将拥有对模型的黑箱访问权,并在不知道模型输出的情况下干扰数据包。
4.2. 数据集预处理
4.2.1.流程
为了训练神经网络,有必要找到一个包含足够可用数据的稳健数据集来输入模型。下一步是解析要使用的数据的正确子集,选择最佳特征,并塑造要传递到模型的数据。KDD 拥有多种用于 NIDS 的网络流量数据,包括 DDoS-2019 数据集,该数据集包含数百个 pcap 文件和数百万个数据包。不同的 DDoS 攻击是由两天的时间构成的,其中 DNS 攻击在第二天的 10:52 - 11:05 (ADT) 之间。一旦确定了 pcap 文件的范围,就有多达 1400 万个数据包和 7,620 个 DNS 数据包。尽管整个 pcap 文件很大,但其中的一小部分包含训练模型所需的实际 DNS 放大数据包。由于非攻击数据包和攻击数据包之间的巨大差异,选择了 pcap 文件的特定切片来利用所有混入正常数据包的 DNS 数据包。最终结果是一个包含 16,247 个数据包和 7,620 个 DNS 数据包的数据集。数据的训练/测试拆分如下:训练集包含 10,885 个数据包和 5,105 个 DNS 数据包,以及 5,362 个数据包和 2,515 个 DNS 数据包的测试集。pcap 文件将 DDoS 数据包与正常流量数据包混合在一起,这增加了解析和标记训练数据的复杂性。CICFlowMeter用于将 pcap 特征解析为 csv 格式。CICFlowMeter 返回一个 csv 文件,其中包含从 pcap 文件解析的数据包流中获得的特征。在我们的实验中,使用 python 库 scapy 的自定义 pcap 解析方法用于提取完整数据包并确定哪些特征最好,该实验将整个数据包用于对抗性算法中的直接扰动。
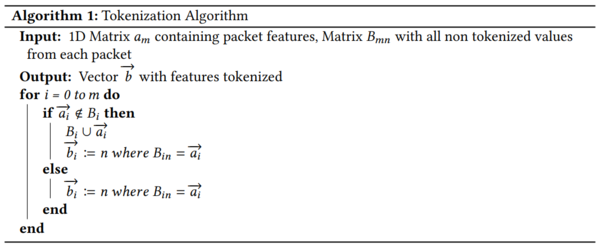
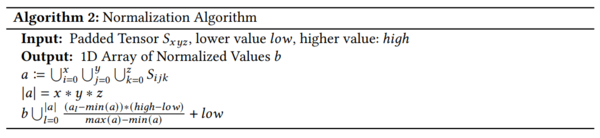
数据包中包含的大部分数据都是简单的英文而不是数字,神经网络需要提供给它们的数据是数字的。NLP 中用于对非数值数据进行训练的常用方法用于实现这一目标。标记化是将非数字数据转换为数字的更普遍的方法之一,标记化将每个唯一对象映射到数组中的索引,并允许将所有 pcap 数据转换为整数值,。然后将数组中的值从 -0.5 标准化到 +0.5,以使模型更容易处理数据 。
在解析来自 KDD 文件的原始 pcap 数据后,需要确定哪些特性可以使偏差最小。 针对 DNS 放大攻击,确定最大数据包长度是对 DNS 放大攻击进行分类的最重要特征。为了做到这一点,遗传算法用于确定给定 csv 文件中的哪些特征不太可能产生训练偏差。最初,数据包被分成 42 个特征(TCP 和 UDP),在通过遗传算法传递数据后,这些特征被缩小到 15 个特征。使用的特征是:目标地址、源地址、IP 数据包长度、IP id、IP 标志、IP chksum、DNS id、DNS ra、源端口、目标端口、seq、ack、dataofs、chksum、urgptr。
算法 1:标记化算法
算法 2:归一化算法
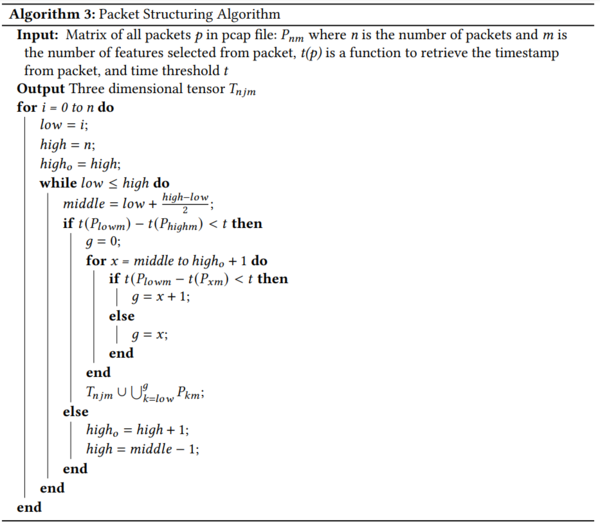
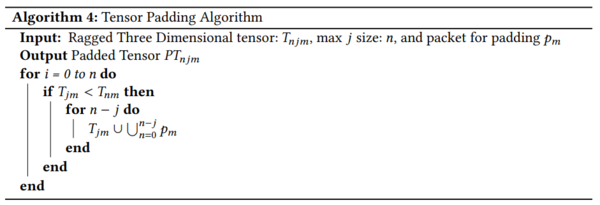
为了捕获用于训练过程的DDoS攻击的性质,需要对数据进行重构,以反映用于标记过程的这种攻击的时间性质。DNS报文的攻击频率是攻击的核心,需要对其进行量化,数据包关系是这些攻击的另一个重要方面。为了以一种有意义的方式对数据进行标记,将初始包集根据彼此之间的时间关系划分为子集。算法 [3] 用于生成原始集的每个子集,其中包含彼此间隔在30秒内的所有数据包。这允许KDD数据集扩展,并为集中的每个包生成包流。发现标注DNS扩增攻击最重要的特征是报文长度。判断DNS攻击报文的平均最大长度为1378.80字节,DNS报文最大长度为465字节,大部分恶意响应超过100字节。如果在30秒内,每个包流包含至少3个大于100的DNS包,则被标记为攻击。这给我们留下了一个不规则的张量,这意味着包流的集合是不对称的,每个包流包含唯一数量的包。不规则形状的张量比对称形状的张量更难处理。另一种方法是张量填充,如算法 [4] 中所示填充的工作原理是将空值或中性值附加到数据集的末尾,以使它们都适合相同的大小。信息流中的信息包数量是所有信息流之间不对称的数据部分。该过程采用一个三维张量,其中k表示一个包,j表示一个包流,并且在所有i中是唯一的,k是一组基数为15的包特征集。找到最大的数据包矩阵,然后在每个较小的矩阵中添加正确数量的中立数据包,其中中立数据包被定义为不影响数据标记的数据包。数据根据预先确定的攻击度量进行标记。标签只是0表示没有攻击,1表示攻击。
算法 3:分组结构算法
算法 4:张量填充算法
4.2.2.指标
为了评估这些算法的有效性,我们观察了本文提出的每个算法的时间度量。这些指标的结果可以在表[1]中找到,每一种算法都针对5个不同的pcap文件进行了评估,这些文件包含500、1,000、5,000、10,000和100,000个数据包。处理每个数据包的平均时间大约为71.839毫秒。实际上,所有的算法不会一起使用。更有趣的比较是填充算法和粗糙算法之间的比较。我们观察到,填充数组通常会比规范化慢0.69 ms,而实际填充算法比将数组转换为一个不规则的张量流张量要少花费1.648 ms。总的来说,处理一个带有填充的包的平均时间为62.169 ms,不规则算法为63.127 ms。当只计算一个包时,这个.958 ms的差异相对较小,但是对于每1000个包,这个差异会放大大约1秒。当处理数十万或数百万包时,效率会变得太低。
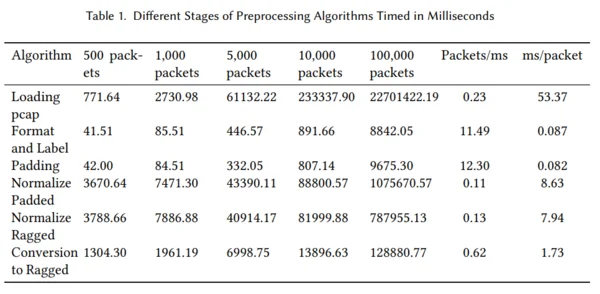
表1:以毫秒为单位的预处理算法的不同阶段
4.3. 模型
由于 DDoS 攻击和 pcap 数据的时间特性,RNN 被用于使用 LSTM 层的分类器。该模型由一个 LSTM 层和两个使用 tanh 和 sigmoid 激活的密集层组成。最终模型的分类准确率在 98% 到 99% 之间。使用的数据的主要结构是具有上述 15 个特征的填充张量。不规则张量和填充张量被传递到模型中进行评估。不规则张量和填充张量都是由相同的数据集形成的,并被传递到具有相同批量大小和时期数的相同模型中。在测试了这两种张量结构之后,观察到所达到的精度差异几乎可以忽略不计,因为两者对测试数据产生了几乎相同的预测。两者最多相差1%。图[3] 显示了通过深度神经网络的流程的可视化表示。
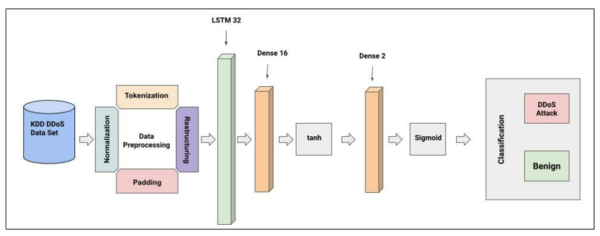
图 3. RNN 模型示意图
4.4. EAD 算法
一旦形成了对 DNS 放大攻击进行分类的有效模型,EAD 算法就会适应它。目标是保留算法的功能,同时允许它在三维数据包张量上工作。最初传入算法的数据是一个四维张量 ,其中i 表示图像的数量,j表示正方形图像的x和 y轴,设置为 28,k表示通道数,设置为 1。这个张量可以明显小于这个项目产生的张量。图像张量的大小可以表示为 784 n其中n是图像的数量。数据包张量大小可以显示为 21 lm,其中l是数据包流的数量,m是流中的数据包数量。对于更大的 pcap 文件选择,这个张量变得非常麻烦,因为在这个实验中l是 16,247,m通常是数千。对于攻击,作者使用“迭代收缩阈值算法 (ISTA)” 来收缩某些像素值,因为它们与原始值的差异大于定义的阈值。此方法类似于 Carlini & Wagner 算法,但更有效。攻击采用批量图像或数据包流并将它们与下限进行比较:
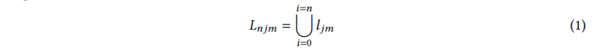
与输入张量的形状相同,其中 是一个所有值都为 0 的矩阵,上限也是一个张量。
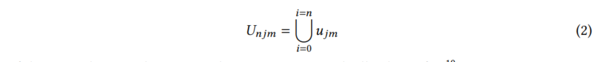
与输入的形状相同, 并且是一个所有值为10的10次方的矩阵
将分数分配给边界和输入并进行评估以确定哪个是最佳的,从这里选择最佳攻击并在模型上使用。
4.5. 文本攻击算法
在模型上评估 EAD 后,需要调整 TextAttack 以扰乱数据包数据。TextAttack 比 EAD 算法更适合分组数据,因为分组数据本质上是离散的和不连续的。TextAttack python 库非常健壮、开源,并且很容易适应这项研究。python 库包含用于增强数据的多种操作模式,包括:CLAREAugmenter、CheckListAugmenter、EasyDataAugmenter、CharSwapAugmenter、EmbeddingAugmenter 和 WordNetAugmenter。在这些模式中,使用了 ClareAugmenter 和 CharSwapAugmenter。CLAREAugmenter 使用预先训练的掩码语言模型替换、插入和合并文本。CharSwapAugmenter 替换、删除、插入和交换相邻字符。TextAttack 可以接收单个单词或单词列表来扰动并且可以被链接。要将 TextAttack 应用于数据包数据,首先需要确定哪些数据包特征是可变的。并非数据包的所有特征都是文本,因此还需要一种将 TextAttack 应用于整数值的方法。要做到这一点,一种将整数中的每个单独数字转换为其各自字母值的算法,该值介于“a”和“i”之间。然后使用 CharSwapAugmenter 通过多次迭代修改转换后的数字,然后将单词转换回整数。与 EAD 算法一起使用的相同数据也与 TextAttack 一起使用,因为两者都能够扰乱相同的张量结构。与 EAD 算法相比,TextAttack 能够扰乱数据包数据,同时保持合法的数据包特征,使其成为更实用的攻击。与 EAD 算法一起使用的相同数据也与 TextAttack 一起使用,因为两者都能够扰乱相同的张量结构。与 EAD 算法相比,TextAttack 能够扰乱数据包数据,同时保持合法的数据包特征,使其成为更实用的攻击。与 EAD 算法一起使用的相同数据也与 TextAttack 一起使用,因为两者都能够扰乱相同的张量结构。与 EAD 算法相比,TextAttack 能够扰乱数据包数据,同时保持合法的数据包特征,使其成为更实用的攻击。
5.结果
为了评估 EAD 和 TextAttack 实验的结果,使用了两个指标:平均扰动和攻击成功率。如图 [4] 所示,在进行攻击之前获取模型的基线。
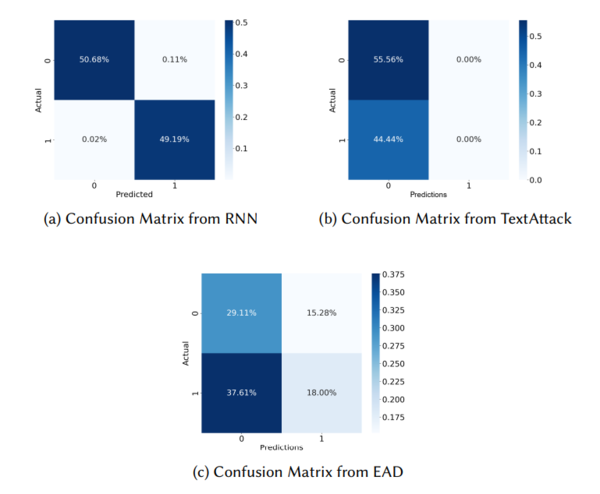
图4.模拟结果
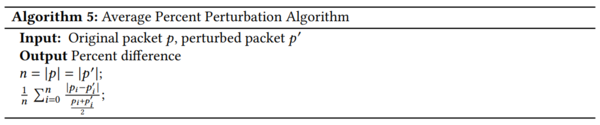
为了计算由每种算法创建的 AE 的平均扰动,采用了未扰动数据包和扰动数据包之间的距离。为了计算每对数据包的百分比,评估了数据包中每个特征的百分比差异,然后按照算法 [5] 中显示的方法进行平均。结果可见表 [2] 。两种算法在平均扰动百分比方面存在巨大差异.EADs 高扰动率的原因是它持续扰动数据包特征作为其优化的一部分,导致 200% 的距离。TextAttack 创建了一个更正常的距离,因为每个单独的数据包特征单独受到单个字符插入或删除的轻微干扰。
算法5:平均百分比扰动算法
攻击成功率的结果如图4的[b] 和 [c] 所示。借助 TextAttack,AE 能够成功地在攻击方面欺骗分类器,同时还允许良性数据包流保持良性。EAD 混淆矩阵也显示出类似的结果,但方差略大。两次攻击都有很高的误报率,这是攻击的目标。他们也有很高的真阳性率,这表明他们可以保留良性数据包而不会将它们转化为可分类的攻击。被归类为良性的攻击的百分比用于计算攻击成功率。表 [2] 显示攻击成功率的结果。结果表明,这两种算法都能够产生能够欺骗 DNS 放大分类器的高质量 AE。
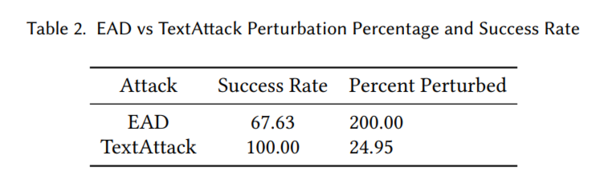
表2:EAD 与 TextAttack 扰动百分比和成功率
6.结论和未来工作
在我们的研究中,形成了一个 RNN 来训练 DNS 放大数据。EAD 和 TextAttack 算法被应用于这个模型来欺骗它,根据它们与网络流量数据的性能以及它们保存数据性质的程度,对这两种算法进行了评估和比较。结果表明,欺骗机器学习 NIDS 是可能且相对容易的,这再次证实了这些深度学习算法很容易受到对抗性学习的影响。可以使为图像处理或 NLP 创建的对抗算法适应网络分类器,虽然这些算法能够扰乱网络流量数据,但它们不一定能制作出真实的数据包,从而导致未来开发一种纯粹用于网络流量分类器的新对抗算法。我们发现 TextAttack 算法可以产生 100% 几率欺骗模型的 AE。EAD 算法的 AE 有 67.63% 的机会欺骗模型。TextAttack 算法的扰动率为 24.95%,EAD 算法对数据包的扰动率为 200%。
未来的目标是创建一种新的对抗性攻击,专门针对网络流量分类器的攻击而设计,并通过对抗性学习和训练蒸馏来实施防御。我们未来的下一个目标是将在 DNS 放大分类器上所做的工作应用于 IoT DDoS 攻击,特别是针对许多物联网设备使用的受限应用协议 (CoAP) 的 DDoS 攻击,这将包括创建一个类似于来自 CoAP 流量(包括恶意数据包)的 KDD 的数据集。然后,这将应用于使用 NIDS 对 IoT 环境进行的真实世界模拟。
