密歇根大学(University of Michigan)的研究人员公开了迄今为止最大的基准数据集,这是一套基于数据隐私设计的机器学习技术。这种方法被称为联邦学习,在智能手机和笔记本电脑等终端用户设备上训练学习模型,而不需要将私人数据传输到中央服务器。
密歇根大学计算机科学与工程博士生Fan Lai解释说:“通过在生成数据的地方进行现场训练,我们可以在更大的现实世界数据上训练。”Fan Lai将在本周的机器学习国际会议上介绍了FedScale训练环境。
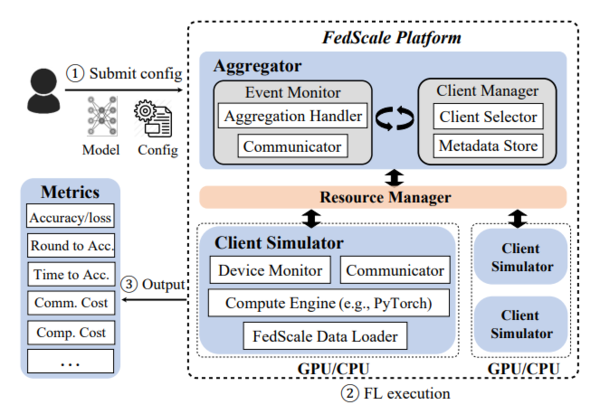
FedScale是一个大规模联邦学习系统,它主要提供海量具有挑战性和现实的数据集,以促进大规模,全⾯的和可重复的联邦学习 (Federated Learning,FL) 研究。FedScale 数据集是⼤规模的,包含⼴泛的重要FL 任务,例如图像分类、对象检测、单词预测、语⾳识别和视频流中的序列预测。对于每个数据集,我们使⽤现实的数据拆分和提供统⼀的评估指标。
Lai说:“这也使我们能够降低隐私风险,以及降低从终端用户设备收集原始数据到云端相关的高通信和存储成本”。
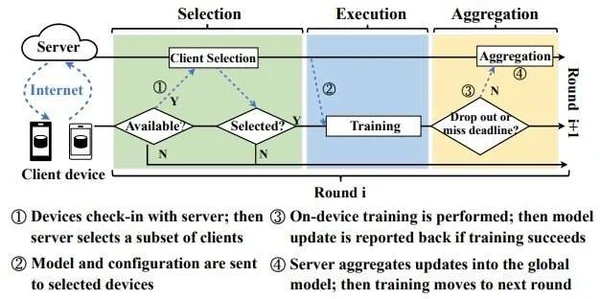
联邦学习仍然是一项新技术,它依赖于一种作为集中协调器的算法,它将模型交付给设备,在相关的用户数据上对其进行本地训练,然后将每个部分训练的模型带回来,并使用它们生成最终的全局模型。
对于许多应用程序,该工作流提供了额外的数据隐私和安全保障,即时通讯应用程序、医疗数据、个人文件和其他敏感但有用的培训材料可以改进模型,而不用担心数据中心的漏洞。
除了保护隐私之外,联邦学习还可以通过减少甚至有时消除大数据的传输,使模型训练的资源效率更高,但在广泛应用之前,它面临着一些挑战。跨多个设备进行培训意味着无法保证可用的计算资源,而用户连接速度和设备规格等不确定性导致数据选择的质量参差不齐。
密歇根大学计算机科学与工程副教授Mosharaf Chowdhury说:“联邦学习作为一个研究领域正在迅速发展。但大多数工作都使用了少数数据集,这些数据集非常小,不能代表联邦学习的许多方面。”
这就是FedScale的作用所在,该平台可以在少数GPU和CPU上模拟数百万用户设备的行为,使机器学习模型的开发人员能够探索他们的联邦学习程序将如何执行,而不需要大规模部署。它服务于各种流行的学习任务,包括图像分类、目标检测、语言建模、语音识别和机器翻译。
Mosharaf Chowdhury说:“任何在终端用户数据上使用机器学习的东西都可以进行联邦练习,应用程序应该能够学习并改进它们提供服务的方式,而不需要实际记录用户的所有操作。”
研究人员指定了几个必须考虑的条件,以真实地模拟联邦学习体验:数据的异构性、设备的异构性、异构连接和可用性条件,所有这些条件都具有在多种规模上操作各种各样的机器学习任务的能力。据Chowdhury说,FedScale的数据集是迄今为止专门针对联邦学习中这些挑战发布的最大的数据集。
“在过去的几年里,我们收集了几十个数据集。原始数据大多是公开的,但很难使用,因为它们的来源和格式多种多样,”Fan Lai说。“我们也在继续致力于支持大规模的设备上部署。”
Federscale团队还推出了一个排行榜,以推广在U-M系统上训练的最成功的联邦学习解决方案。
原文链接:https://techxplore.com/news/2022-07-source-platform-enables-privacy-preserving-machine.html
