摘要
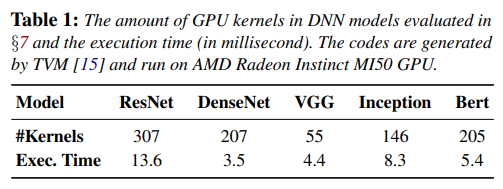
许多智能应用程序,如自动驾驶和虚拟现实,需要同时运行对延迟至关重要的和尽力而为(best-effort)的DNN推理任务,以实现实时和节省GPU上的工作。然而,普通GPU缺乏有效的抢占式调度支持,最先进的方法要么垄断GPU,要么让实时任务等待尽力而为的任务完成,这导致低利用率或高延迟或两者兼有。本文提出了第一种GPU加速的DNN推理服务系统 REEF,该系统实现了微秒级的内核抢占,并在GPU调度中控制并发执行。REEF的创新体现在两个方面:首先,基于DNN推理核大多幂等的观察,REEF设计了一种基于重置的抢占方案,通过在微秒级主动杀死和恢复尽力而为的内核,在 GPU 上启动实时内核。其次,由于DNN推理核具有不同的并行性和可预测的延迟,REEF提出了一种动态内核填充机制,该机制使用适当的尽力而为内核动态填充实时内核,以完全利用GPU,而开销可以忽略不计。使用一种新的DNN推断服务基准(DISB)在不同的工作负载下进行评估,并在AMD GPU上进行真实的跟踪,结果表明,与将GPU用于实时任务相比,REEF在实时任务的端到端延迟方面只增加了不到2%的开销,但总体吞吐量增加了7.7倍。为了证明我们的方法在闭源GPU上的可行性,我们进一步在NVIDIA GPU上移植并评估了一个限制版本的REEF,其抢占延迟从6.3×减少到12.3×(原来是6.3×)。
1 介绍
深度神经网络(DNN)推理已被现代智能应用广泛采用,如自动驾驶、虚拟现实、语音/图像识别和医疗保健,仅举这几个例子,它们中的许多要求在关键任务中提供实时推理服务,GPU已经成为服务DNN推理的流行加速器。
虽然可以通过将整个GPU用于顺序地处理单个DNN应用程序的请求来满足低延迟的DNN推断需求,但很难充分利用GPU的大规模并行性。因此,在新兴智能系统中,在具有不同时间约束的多个应用程序之间共享GPU是一种常见的做法,可以大大提高整体吞吐量,如图1(a)所示。例如,自动驾驶汽车使用DNN来识别障碍物和交通灯,这是延迟关键任务(本文称之为实时任务)。同时,其他无实时性要求的任务(本文称之为best-effort任务),如监测人类驾驶员的情绪和疲劳等,也通过DNN在GPU中服务。
通常,DNN推断对于GPU调度有两个潜在的冲突目标。首先,将实时任务视为GPU上的首要任务,不受其他任务的干扰,实现较低的端到端延迟。第二,实时任务和最优任务都应该在GPU上并发服务,以实现较高的总体吞吐量(节省工作)。
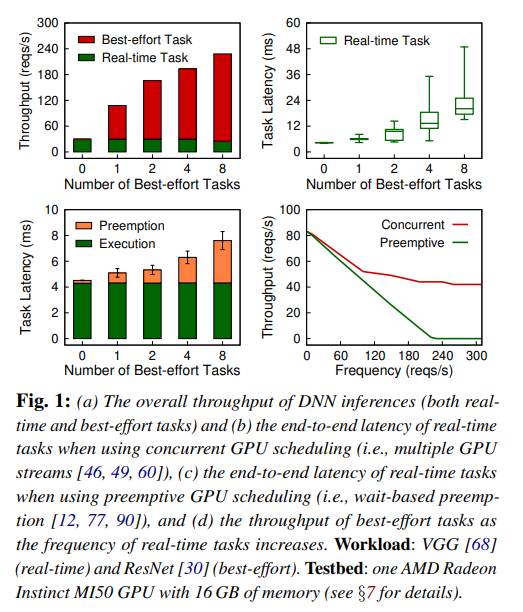
最先进的GPU库(如CUDA和ROCm)通常提供多个GPU流(如CUDA流),以在同一GPU上并发执行多个任务。然而,如图1(b)所示,尽管实时任务的端到端推断延迟很低(约4ms),并且垄断GPU时很稳定,但实时任务的尾延迟在与最努力的任务并发运行时显著增加了一个数量级(接近50ms)。不幸的是,这对于实时场景是不可接受的。
类似于操作系统使用抢占式调度来提供实时保证,一种直观的方法是为GPU调度提供抢占,不幸的是,这在普通GPU中是缺失的。之前的工作提出了一种基于等待的方法,被动等待直到运行块完成,这可能会导致几毫秒的抢占延迟。尽管对于传统的GPU工作负载而言,这种方法可能已经足够了,但对于DNN推理任务来说,这种方法仍然远远不是最优的,因为与实时推理任务的执行时间相比,抢占延迟不是微不足道的,如图1(c)所示。此外,当实时推断请求到达一个高频率(例如,摄像头(120请求/秒)或多个传感器),尽力而为的任务甚至可能会饿死,如图1(d)所示。
本文提出了首款面向商用GPU的DNN推理服务系统REEF,该系统具有微秒级的内核抢占功能,并在GPU调度中控制并发执行,实现实时性和工作节省。具体来说,到达的实时任务应该立即从运行得最好的内核中抢占GPU,而不需要等待它们完成。同时,最好的内核应该使用实时内核剩余的GPU资源并发执行。REEF的一个关键见解是,DNN推断中的每个核大多是幂等的。这意味着可以在不保存上下文的情况下主动终止和恢复正在运行的最佳内核。在此基础上,REEF提出了一种基于重置的抢占方案。为了在GPU运行时和设备中彻底刷新数百个出色的内核,REEF设计了不同的方法来重置不同的软件队列,并翻新了GPU驱动程序,以准确地使用现有的硬件机制来重置计算单元,同时保留GPU的设备内存。它可以改进内核抢占和恢复。因此,REEF可以在几十微秒内在GPU上启动一个实时任务,而不考虑被抢占的内核数量和它们的执行时间。
基于GPU内核在DNN推理中执行时间的确定性和可预测性,REEF进一步提出了一种动态内核填充机制。这意味着可以仔细选择待处理的最佳内核,在不影响性能的情况下,提前基于脱机分析来填充实时内核。REEF扩展了GPU编译器,使用函数指针构造填充内核的模板。此外,为了消除GPU上间接函数调用的开销,REEF引入了代理内核来解决寄存器分配问题,并避免运行时不必要的上下文保存。因此,REEF可以用best-effort任务并发执行实时任务,而性能和内存开销可以忽略不计(小于1%,约10kb)。
我们通过扩展Apache TVM(一个用于深度学习的编译器)和AMD ROCm(一个开源的GPU计算平台)实现了REEF。我们使用新的DNN推断服务基准(DISB)评估REEF,该基准具有不同的工作负载和模型,以及来自Apollo(一个开放的自动驾驶平台)的真实轨迹。我们的实验结果表明,与将GPU用于实时任务相比,REEF只增加了不到2%的端到端延迟开销,但增加了4.3×的总体吞吐量。我们的方法与最先进的技术相比,进一步减少了一个数量级以上的抢占延迟,所有模型的抢占延迟都小于40微秒。为了证明我们的方法在闭源GPU上的可行性,我们进一步在NVIDIA GPU上移植并评估了一个限制版本的REEF,其抢占延迟从6.3×减少到12.3×(原来是6.3×)。
我们总结我们的贡献如下:
- 深入了解GPU加速的DNN推断的特性,如幂等性和最先进的GPU调度方案。
- 一种新的基于重置的抢占方案,可以在几微秒内启动GPU上的实时内核,而不管被抢占的内核数量。
- 一种优雅的机制,可以动态地用最好的内核填充实时内核,以充分利用GPU的大规模并行性。
- 在AMD和NVIDIA GPU上的实现(§6),以及一份证明了REEF优于最先进GPU的评估。
REEF的源代码可以在https://github.com/SJTU-IPADS/reef上公开,DNN推理服务基准(DISB)框架可以从https://github.com/SJTU-IPADS/disb单独获得。
2 背景与动机
2.1 GPU加速DNN推断的特征
深度神经网络(DNN)由多个通用层实例组成,如卷积层、池化层和全连接层。GPU被广泛应用于加快DNN推理服务。为了在GPU上服务推断请求,预先训练的DNN模型(例如ResNet)被提前加载到GPU内存中。图2概述了GPU加速的DNN推理的实现。对于每个到达的请求,DNN模型的所有内核将与输入一起依次执行,并将结果输出返回给DNN应用程序。
DNN推理现在被用于实时(RT)任务,如障碍物和红绿灯识别,以及尽力而为(BE)任务,如情绪和疲劳监测。实时任务是延迟关键,因为违反端到端延迟要求可能会导致系统故障甚至安全问题。此外,这种请求通常由输入传感器(如相机和激光雷达)以不同的频率周期性地发出。相反,尽力而为的任务没有严格的时间要求,而是在后台重复执行。
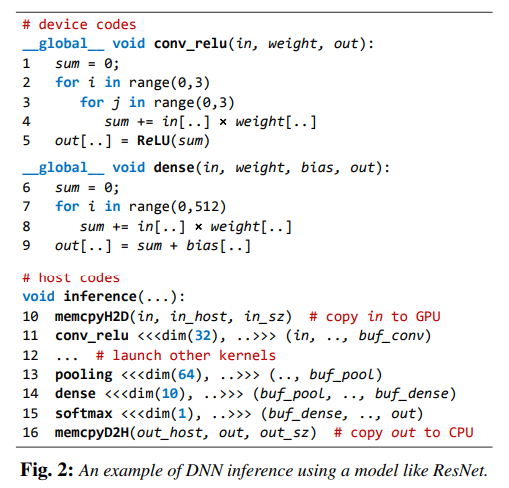
图2:使用ResNet的模型进行DNN推断的一个例子
- Idempotence 幂等性。用于推理任务的GPU加速DNN模型由一系列实现一个或多个DNN层的内核组成。我们观察到,在DNN模型中的GPU内核大部分是幂等的,因为它们几乎只包含密集的线性代数计算,而没有副作用,因此无论是否重试,内核都可以使用相同的输入产生相同的输出。同时,在DNN模型中,第(k)个核总是使用第(k-1)个核的输出和静态参数(如权值)作为输入,如图2中的conv_relu和dense核。因此,DNN推理任务的执行可以在中断的内核之前从任何内核恢复,并且不会改变推理结果。
- Massive kernels。传统的GPGPU应用一般只有几个或十几个GPU Kernel,而DNN Inference任务往往具有数十或上百个GPU Kernel(在本工作的测试中,一个模型最多具有307个Kernel)。在执行如果巨大数量的GPU kernel时,kernel launch的性能开销会尤为明显。为了避免kernel launch的性能开销,一般的execution engine都会选择异步的将所有kernel全部提交到GPU runtime后,再同步等待结果。这个特性导致在实现GPU任务抢占时,除了正在执行的kernel,还有数十上百的kernel存在于GPU runtime中,对这些kernel的抢占也会显著的影响任务抢占的时延。
- Latency predictability 延迟的可预知性。DNN Inference任务中的GPU Kernel的执行时间具有可预测性,因为他们的大多都是没有逻辑分支、无状态的代数运算,当使用固定大小的输入进行计算时,计算过程是固定的。因此我们可以在离线阶段提前记录每个kernel的执行时延,并在运行时实现精准的资源分配和任务调度。
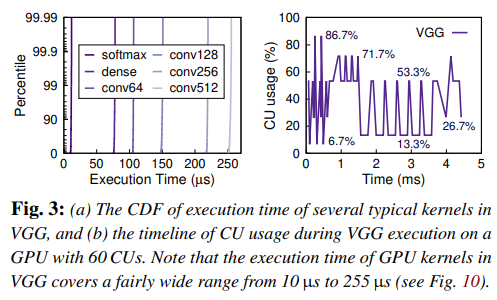
- Varied parallelism 不同的并行性。同一个DNN Inference任务中不同的GPU Kernel具有不同的并行度,如上图3所示,在执行VGG模型的执行过程中,不同时刻对于 GPU 中计算单元(Compute Unit,CU)的利用率是动态变化的。因此在多个任务并行执行时,应该具有一个动态的计算资源分配机制,来满足不同任务的性能需求。
2.2 最先进的GPU调度
如前所述,DNN推断服务系统依赖GPU调度来满足两个潜在冲突的性能目标:低延迟和工作节省。尽管GPU调度在高性能计算领域得到了广泛的研究,但DNN推理的独特特性和两个性能目标给GPU调度带来了新的挑战。我们回顾了最先进的GPU调度方案,并通过一个简单的例子讨论了服务于各种DNN推断时的性能问题,如图4所示。
- Sequential execution 顺序执行。 最典型的调度方法就是将 GPU 视为一个整体,每次执行一个任务,这也是现有的Serving System(例如 ClockWork)的典型调度方式。由于这种调度策略是非抢占式的,如上图所示,如果一个RT任务到达时,系统正在执行一个BE任务,那么这个RT任务只能等BE任务完成之后,才能被执行,现在会严重影响RT任务的响应时延。同样的,这种调度方式没有能够充分利用GPU的并行性,造成了计算资源的浪费,从而导致了较低的吞吐量。
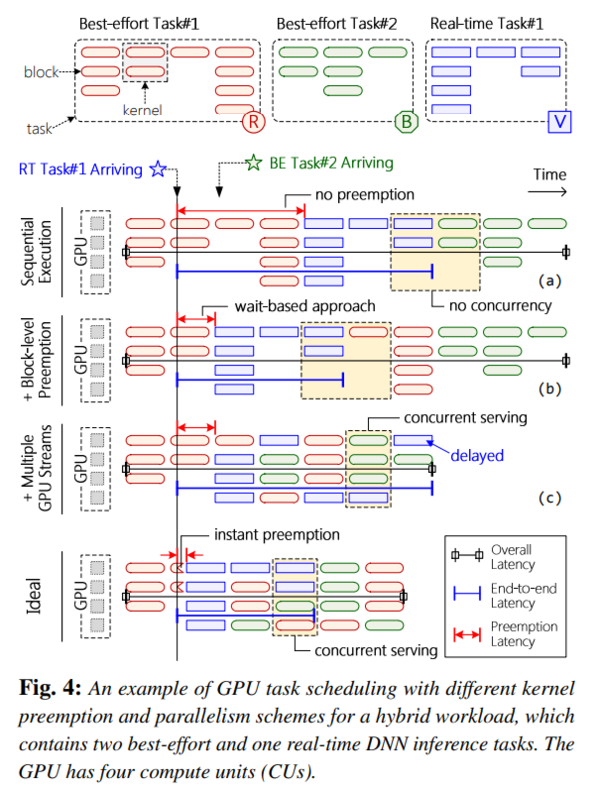
图4:混合工作负载下不同内核抢占和并行方案的GPU任务调度示例,包含两个BE任务和一个实时DNN推理任务,GPU有4个计算单元。
- Block-level preemption 块级抢占。由于现有的商用GPU没有提供“抢占式调度”的用户API,因此现有工作利用GPU kernel中的block具有独立性的特点,实现了block-level preemption。当一个kernel被抢占时,它不会等待所有的block都计算完成,而是只等待正在执行的block完成后则退出。通过这个方式可以实现GPU的抢占式任务调度,在RT任务到达时抢占BE任务,从而降低RT任务的响应时延。而这一方式存在以下三个问题:首先这个方法的抢占时延取决于正在执行的block还有多久结束,这在严格意义上并非是“抢占”,并且在有多个kernel并行执行时会有较大的抢占时延;其次,这个方法要求GPU runtime中只能存在一个kernel,在DNN Inference具有 massive kernels的特征下会显著放大kernel launch的开销,显著降低推理的性能,而若不做此限制(即允许GPU Runtime中存在多个kernel),则会显著影响抢占时延(至毫秒级);最后,抢占式调度存在一个著名的“饥饿”问题,当RT任务到达频率很高时,BE任务会因为被频繁抢占而被“饿死”。
- Multiple GPU streams 多个GPU流。为了避免饥饿和提高系统吞吐,现有的GPU Runtime提供了Stream的抽象(例如CUDA Stream),可以利用多个Stream实现任务的并行执行。而GPU Stream虽然能够提高系统吞吐量,也同时由于多个任务对计算资源的竞争,显著影响RT任务的执行时延。
3 REEF概述
3.1 系统体系结构
REEF的目标是提供抢占式的GPU调度,以实现对延迟关键任务的实时性,并为最优任务保存工作(见图4中的理想调度示例)。基于DNN推理核大多是幂等的,有大量的核具有不同的并行性和可预测的延迟,REEF提供了两种新颖的设计,即基于重置的抢占和动态内核填充。
图5展示了REEF的架构概述,REEF由(a)离线部分和(b)在线部分组成,离线部分负责编译和加载用户提供的DNN模型,在线部分负责调度和服务DNN推理请求。
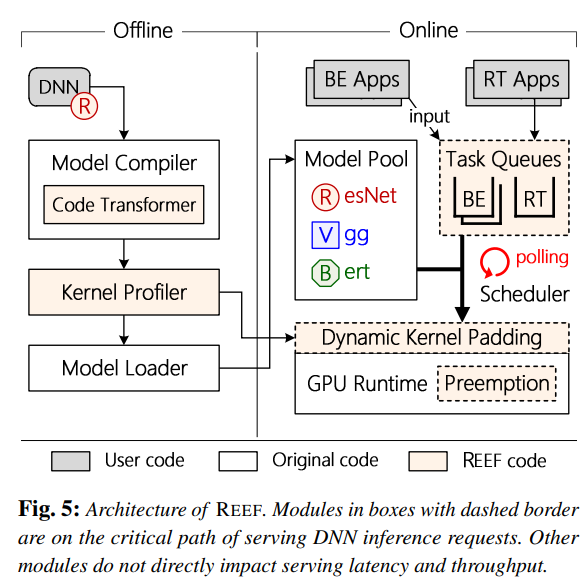
图5:REEF的架构:边框为虚线的框中的模块位于服务DNN推断请求的关键路径上,其他模块不会直接影响服务延迟和吞吐量。
- DNN model preparation (offline) DNN模型制备(离线)。通常,DNN模型首先编译并优化加速器后端(例如GPU),然后加载到模型池中。受前人工作的启发,REEF通过一个代码转换模块扩展了模型编译器(如TVM),该模块首先验证DNN模型中内核的幂等性,然后转换源代码以辅助GPU在REEF中的调度。此外,REEF开发了一个内核分析器来测量模型每个内核的计算需求和执行时间,这对于DNN模型是准确和实用的。
- DNN inference serving (online)DNN推断服务(在线)。REEF扩展了最先进的GPU运行时(例如,ROCm),为DNN推断服务提供了四个主要组件:
Task Queues任务队列。REEF维护一个实时任务队列和几个best-effort任务队列。每个队列都被绑定到一个用于启动GPU内核的GPU流,其中推断请求是按照FIFO顺序服务的。为了简单起见,REEF每次执行一个实时请求。需要注意的是,任何将整个GPU视为单个设备的调度策略,例如EDF,都可以被REEF用于实时请求。此外,REEF还为基于dnn的应用程序提供了基于RPC的接口,以向任务队列发送推断请求。
Scheduler调度器。REEF中的调度器使用繁忙的轮询任务队列,并将任务分配给相关的GPU流。针对是否存在实时任务,REEF提供了实时模式和正常模式两种执行模式。当遇到实时任务时,调度器会从普通模式切换到实时模式,当实时任务队列为空时,调度器会切换回普通模式。
Preemption module抢占模块。在正常模式下,REEF使用GPU运行时提供的多个GPU流,从不同的任务队列并发地服务best-effort任务。在实时模式下,REEF首先使用抢占模块来即时抢占GPU所有正在运行的最佳任务,然后立即在GPU上启动实时任务。
Dynamic kernel padding (DKP)动态内核填充(DKP)。在实时模式下,在启动实时内核之前,DKP模块将选择合适的最佳内核,并动态地将它们填充到实时内核中。REEF将在GPU上执行填充内核,以实现高吞吐量。注意,best-effort内核只会使用实时内核剩余的GPU资源。
3.2 一个说明性例子
图6 给出了在REEF中调度5个DNN推理任务的时间轴。当收到前两个best-effort请求r 和b 时,REEF运行在正常模式下,两个不同任务的内核被调度到两个不同的GPU流。GPU运行时将并发执行GPU上的内核。当r 和b 执行时,一个实时请求v 到达。调度程序立即切换到实时模式,GPU运行时立即抢占GPU,杀死所有best-effort任务的运行内核(即r 和b )。同时,DKP模块从恢复任务中选择合适的内核动态填充实时任务v 的内核。之后,被填充的内核将单独在GPU上执行。当v 完成时,调度程序切换回正常模式。所有正在运行的和以后的best-effort任务(即r , b , b 和r )将通过两个GPU流并发地在GPU上执行。
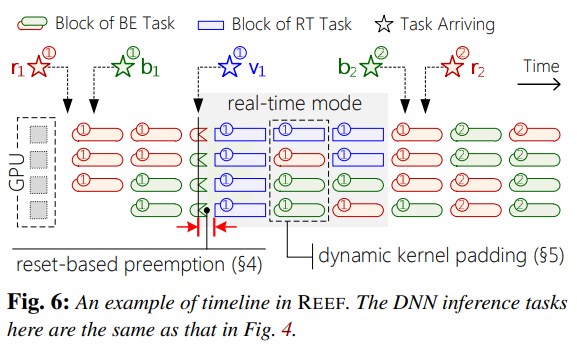
图6:一个时间轴在REEF的例子,此处的DNN推理任务与图4相同。
4 Reset-based抢占
为了实现从Normal Mode到Real-time Mode的快速切换,REEF首先提出了Reset-based Preemption技术来完成微秒级的GPU任务抢占,其核心insight为:DNN的GPU kernel具有幂等性,可以通过kill来实现快速任务抢占,通过re-execute被kill的kernel实现快速任务恢复。
而一个DNN任务,除了GPU中正在执行的kernel,在GPU Runtime中还存在大量未执行的正在排队的kernel,Reset-based Preemption的核心思路就是“Reset”所有位置的kernel,包括GPU中正在执行的和队列里的正在等待的。具体的步骤如下:
- Reset HQs: 用户提交的kernel首先被缓存在GPU Runtime中一个称为Host Queue的链表里,抢占一个任务时首先需要清理掉Host Queue里的kernel,而由于Host Queue是通过链表实现,可以直接替换链表头,实现快速的清理。
- Reset DQs:Host Queue里的Kernel会被异步的提交到一个称为Device Queue的环状数组里,抢占一个任务时也需要清理掉Device Queue里的kernel;与Host Queue不同,Device Queue是CPU和GPU同时读写的内存,清理时需要避免竞争。因此我们选择了一个更安全的方法,即允许Device Queue里的kernel在被抢占后继续提交到GPU中执行,但是在执行开始时直接退出(通过检查一个flag实现)。
- Reset CUs:最后一步就是kill掉正在执行的kernel,这里我们复用了GPU Driver中功能,通过重置所有CU的状态实现kill。
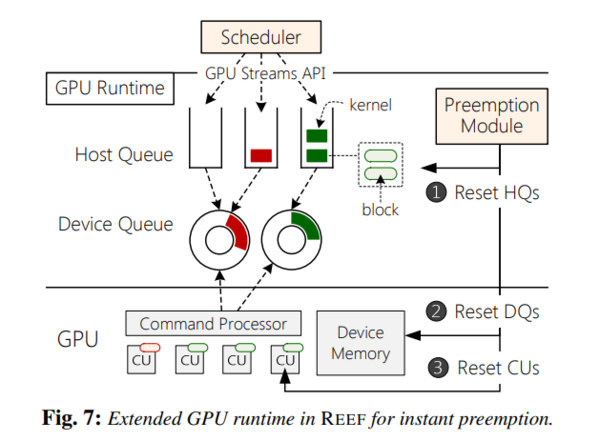
图7:即时抢占的扩展GPU在REEF中的运行时间
5 动态内核填充
为了实现高吞吐量,实时任务和best-effort任务都应该在GPU上并行执行,以实现工作节省。但是,为了避免对实时任务的干扰,best-effort任务只能使用实时任务剩余的GPU资源。遗憾的是,现有的方法都不能在GPU上提供这样的控制并发执行。
使用不同的GPU流来启动实时的、最优的任务无法避免相互干扰。如图8所示,GPU流之间的分发延迟(20-40个μs)可能会延迟实时内核的执行或限制它们的可用资源(例如CUs)。使用额外的流间壁垒在各CUs之间同步内核调度也会导致性能开销。
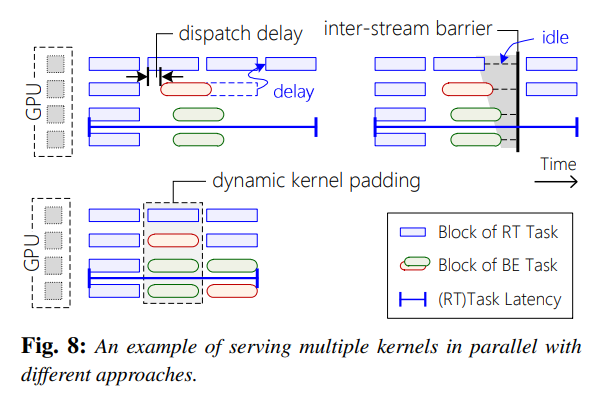
图8:用不同方法并行服务多个内核的示例。
在Real-time Mode,REEF使用动态内核填充(Dynamic Kernel Padding)技术,实现RT/BE 两类Task的并行执行,主要的思路是:以RT为核心,在RT Task执行过程中动态进行CU的划分,优先为RT Kernel分配足够的CU,再将剩余的CU分配给BE kernel。
为了实现动态细粒度的CU划分,我们使用了类似kernel-fusion的方式,将两个不同的kernel合并到一起执行,但不同于kernel-fusion在编译阶段将kernel源代码合并到一起,我们采用function pointer的形式在运行阶段动态跳转到待执行的kernel。
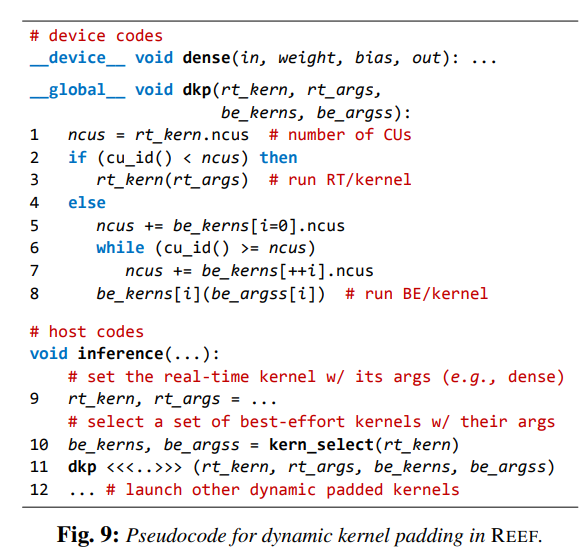
图9:REEF中动态内核填充的伪代码。
图9给出了dynamic kernel padding的伪代码,在运行阶段,dynamic kernel padding在执行一个RT Task时,通过"kern_select"函数依次为每个RT Kernel选择并行执行的BE Kernel,并将这些kernel作为名为dkp的kernel的参数提交到GPU runtime中。dkp是所有kernel的入口,dkp在执行时首先为RT kernel分配足够的CU,再为BE kernel分配剩余的CU。最后通过function pointer的方式跳转到RT/BE Kernel执行。为了降低BE kernel对RT kernel性能的影响,DKP利用了DNN kernel的时延可预测性,只选择执行时延小于RT kernel的BE kernel。
然而上述方式面临一个关键的技术挑战:GPU的function pointer具有极大的性能开销。为了优化GPU中function pointer的开销,本工作提出了global function pointer和proxy kernel的方法,将function pointer的性能开销降低到1%。
该内核选择策略完全满足GPU将实时任务视为一等任务的设计目标。它不仅高效,在少于1个μ s中选择最佳效果的内核,而且有效,将实时内核的延迟开销限制在平均低于1%。但是,该策略也是保守的,因此该约束可能会限制总体吞吐量的改进空间。例如,当best-effort内核的执行时间通常比实时内核的执行时间长(例如图10中的VGG和DenseNet),动态内核填充对吞吐量的提高可能是微不足道的,即使实时任务只使用少量的CUs。
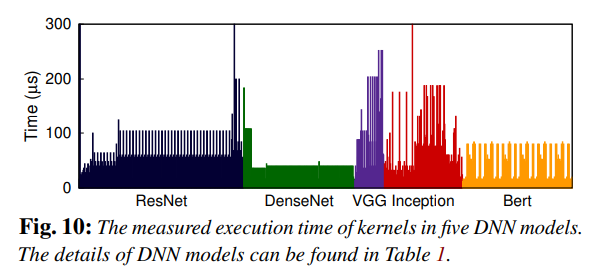
图10:五种DNN模型中核的测量执行时间,DNN模型的详细信息见表1。
6 实现
我们首先在AMD GPU上实现并部署了基于ISA和开源平台的REEF,充分展示了基于复位的抢占和动态内核填充的有效性。REEF是通过扩展Apache TVM和AMD ROCm实现的,大约有5500行c++代码。除此之外,为了进一步证明REEF在闭源GPU上的可行性,我们还在带有CUDA的NVIDIA gpu上移植了基于复位的抢占的受限版本REEF- n。
- Model compiler模型的编译器。REEF对机器学习编译框架Apache TVM进行了扩展,增加了一个代码转换器,主要对DNN推理的源代码进行了两个修改:(1)一个抢占标志,注入内核参数中,惰性地驱逐内核;(2)一组代理内核,它是为填充的内核构造的。
- GPU runtimeGPU运行时。针对AMD GPU, REEF在可移植的GPU运行库和编程库ROCm的HIP上构建抢占模块。类似于NVIDIA CUDA。具体来说,REEF为GPU运行时添加了三个新的API:(1) hip_reset_hq,重置主机队列并将命令移动到GC线程;(2)hip_set_stream_cap,限制GPU流使用的设备队列的容量;(3) hip_reset_kern,在Linux下通过GPU驱动程序,利用硬件机制重置计算单元。
对于NVIDIA GPU, REEF-N截取了内核启动和流管理的三个CUDA API,并添加了以下操作:(1)cuStreamCreate,创建一个vHQ并链接到已创建的CUDA流;(2)cuKernelLaunch,在vHQ中缓冲启动的内核,并在后台传输给GPU运行时(即CUDA);(3) cuStreamSynchronize,等待GPU运行时完成CUDA流的所有启动内核。最后,REEF-N提供了一个新的API cuResetHQ,通过对所有缓冲内核退出队列来重置vHQ。
7 评估
REEF首先部署在AMD Instinct MI50 GPU,因为其具有开源的GPU Driver、Runtime和ISA。
为了测试REEF的综合性能,本文还提出了一个面向实时场景的DNN推理测试基准(DISB),DISB使用了多个具有代表性的DNN模型,并提供了五个具有不同特性的负载。在DISB中,client按照固定的频率或者随机提交推理请求,不同的负载具有不同数量的client或者不同的client任务提交频率,如下表2所示:
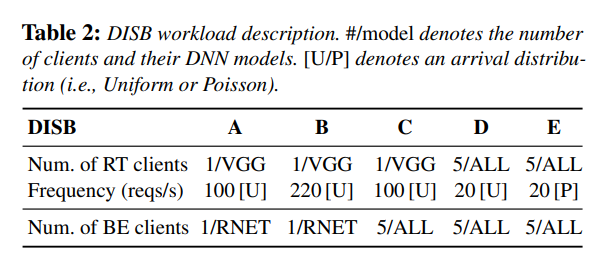
表2:DISB工作负载描述:#/model表示客户端数量及其DNN模型。[U/P]表示到达分布(即Uniform或Poisson)。
本工作对比了REEF与以下三个任务调度方式:
- SEQ:非抢占式顺序调度DNN任务,但是在提交时优先选择RT任务。
- GPUStreams:使用多个GPU Stream并发执行多个任务。
- RT-Only:只执行RT任务,作为最优的rt latency参考
图11给出了REEF与以上三个调度方式在DISB上的测试结果,本工作主要关注两个性能指标,首先是RT任务的端到端时延(end-to-end real-time task latency),以及系统的整体吞吐(overall throughput)。在DISB测试中,相比RT-Only,REEF在只提高RT任务2%时延的前提下,可以提高1.14~7.7倍的吞吐量。
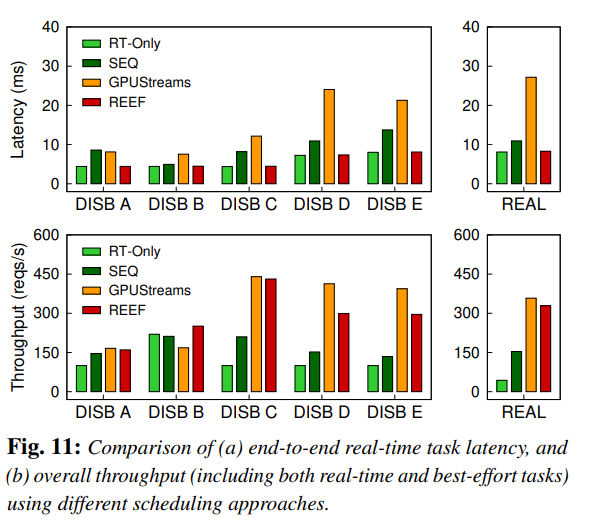
图11:使用不同调度方法的(a)端到端实时任务延迟和(b)总体吞吐量(包括实时任务和BE任务)的比较。
图12给出了REEF提出的任务抢占技术(Reset-based)与现有方法(Wait-based)的性能对比,在DISB测试中,REEF可以在百微妙内抢占并发的DNN任务,相比现有方法抢占时延降低了15倍~18倍。
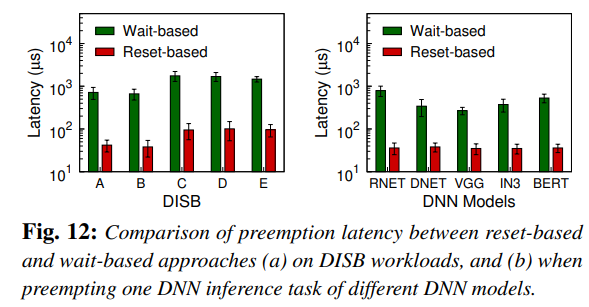
图12:基于重置和基于等待的方法(a)在DISB工作负载下的抢占延迟比较,(b)在抢占不同DNN模型的一个DNN推断任务时的抢占延迟。
为了进一步研究不同模型属性对抢占延迟的影响,我们模拟了具有不同启动内核数量和内核执行时间的DNN模型。默认情况下,我们将启动的内核数量和内核执行时间分别设置为100个和100个µs。如图13所示,基于等待的方法的抢占延迟线性增加,而我们的基于重置的抢占方法在非常低的延迟(小于40µs)时保持稳定。对于基于等待的方法,抢占延迟与启动内核的数量和内核执行时间显著正相关,因为它必须等待启动内核的退出和运行内核的完成。相比之下,基于重置的方法在GPU运行时主动重置主机和设备队列,以及CUs,其中的成本与模型属性无关。
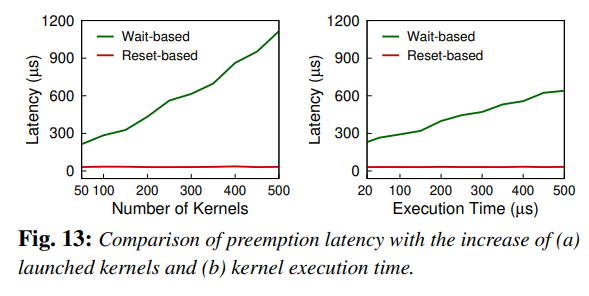
图13:抢占延迟随(a)启动内核和(b)内核执行时间增加的比较。
在基于重置的抢占方法上,我们提出了两种优化方法,即异步内存回收和队列容量限制。为了展示优化的效果,图14展示了随着BE客户端(RNET)的增加而增加的抢占延迟,以及单个BE客户端的延迟崩溃。通过启用两个优化,抢占延迟显著降低了92%(从87%),如图14(a)所示。作为参考,即使没有优化,基于重置的方法仍然比基于等待的方法高出3.0×(从1.7×)。
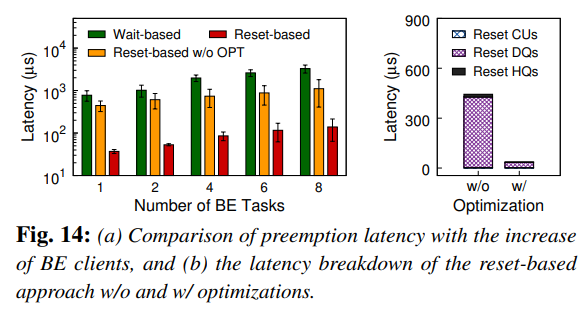
图14:(a) BE客户端增加时抢占延迟的比较,(b)基于重置的方法有w/o和w/优化时的延迟分解。
我们限制设备队列的容量,以减少由于惰性地清除队列中剩余内核而产生的开销。然而,减少队列容量也会增加正常的执行时间和CPU利用率。图15(a)显示了随着队列容量的增加,服务RNET推断时的抢占延迟和正常执行时间。当设备队列容量从1个增加到4个时,执行时间从14.3 ms减少到12.3 ms。然而,当容量进一步增加时,执行时间的变化变得微不足道(小于0.3%)。相反,抢占延迟随队列容量线性增加。因此,作为抢占延迟和正常执行时间之间的合理权衡,REEF在我们的测试平台上为设备队列采用了默认容量4,这对于正常执行几乎是零开销,并提供了可接受的抢占性能(大约30个µs)。最后,使用较小的设备队列也会导致更高的CPU利用率。例如,将队列容量从256减少到4会将CPU利用率从17%提高到31%。
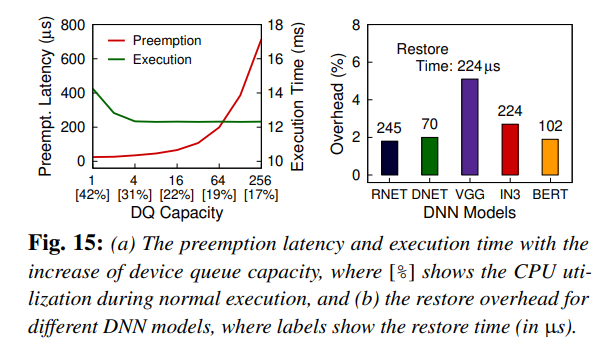
图15:(a)抢占延迟和执行时间随设备队列容量的增加而增加,其中[%]表示正常执行时的CPU利用率,(b)不同DNN模型的恢复开销,其中标签表示恢复时间(以µs为单位)。
为了研究动态内核填充的效果,我们使用一个高争用的工作负载,其中一个RT客户机和一个BE客户机同时以足够高的频率发送请求,以保持GPU繁忙。RT-Only只服务于实时任务,以确保最佳的(实时)任务延迟,而GPUStreams同时服务于两种类型的请求,以实现最高的总体吞吐量。与之不同的是,动态内核填充也只服务于实时任务,但会填充最努力的任务,以避免饥饿并提高总体吞吐量。图16报告了5个DNN模型在上述工作量下一对一组合的实验结果。正如预期的那样,由于并发最佳工作任务的严重干扰,GPUStreams将实时任务延迟平均放大了1.35×,范围从1.04×到1.70×。然而,REEF能够为实时任务提供几乎最优的延迟,平均开销仅为1%(最高3%)。
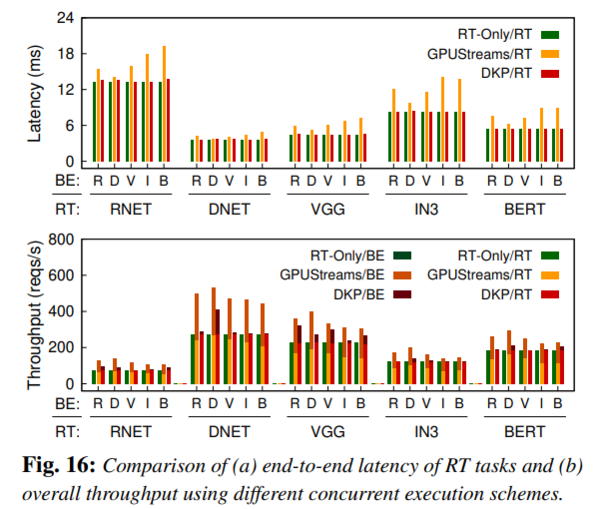
图16:比较(a) RT任务的端到端延迟和(b)使用不同并发执行方案的总体吞吐量。
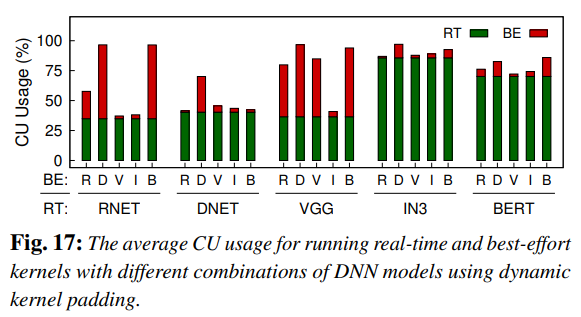
图17:使用动态内核填充的不同DNN模型组合运行实时和最佳努力内核时的平均CU使用量。
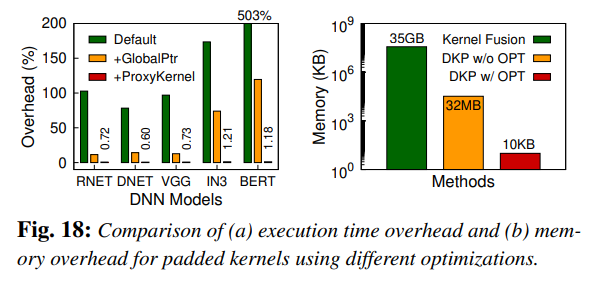
图18:比较(a)执行时间开销和(b)使用不同优化的填充内核的内存开销。
图19(a)显示了动态内核填充过程中DISB a - e选择内核的平均时间。对于具有单个BE客户端的工作负载(DISB a和B), REEF需要大约0.2个µs来为给定的实时内核选择最佳性能的内核。对于有多个BE客户端(DISB C、D、E)的工作负载,由于备选项增多,选择时间增加到0.4 μ s。通常,内核选择的成本非常小,很容易被内核执行所隐藏。为了进一步研究内核选择的准确性,我们评估了实时内核的执行时间开销,这是由于在所有DISB工作负载上填充最佳努力内核。如图19(b)所示,超过37%的实时内核不会受到最佳努力内核并发执行的负面影响,超过90%的实时内核的开销仍然小于4个µs。执行时间的增加主要是由于GPU内存和共享L2缓存的争用。
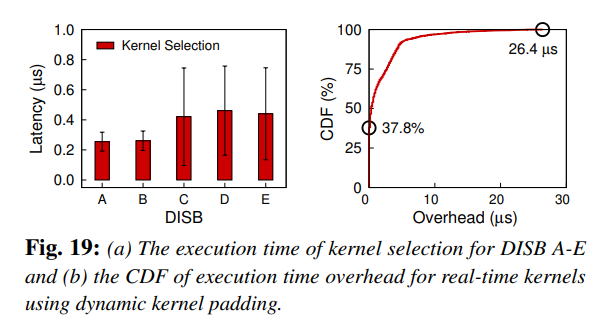
图19:(a) DISB a - e内核选择的执行时间,(b)使用动态内核填充的实时内核的执行时间开销CDF。
最后,我们评估了reff - n,这是一种使用DISB工作负载在NVIDIA和AMD GPU上基于重置抢占的受限版本,并分别与基于等待的方法和REEF进行了比较。如图20所示,即使REEF-N不重置CUs以主动杀死运行中的内核,抢占延迟也只是在71 - 288 μ s之间,在NVIDIA GPU上仍然比基于等待的方法性能高12.3×(从6.3×)。通过比较REEF- n和AMD GPU上的REEF,我们观察到,主动杀死运行的内核进一步提高了平均2.0×抢占延迟的速度,特别是在抢占并发任务时(如DISB C为2.3×),此外,REEF- n在两个GPU上的性能接近。
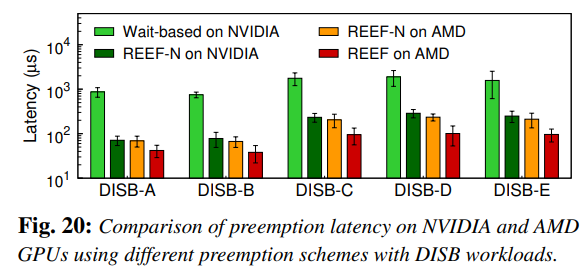
图20:DISB工作负载下,NVIDIA和AMD GPU使用不同抢占方案的抢占延迟比较。
8 讨论
- Assumption of idempotence 幂等性的假设。REEF中基于重置的抢占是基于DNN推理中的每个核都应该是幂等的假设。目前,我们遇到的所有DNN推理核(来自11个模型的320个核)都是幂等的。然而,读者可能会对我们的方法是否仍然适用于没有幂等假设的核感兴趣。严格地说,基于重置的抢占要求内核总是为相同的输入产生相同的输出,而不管它是否被重试。因此,如果需要,可以使用事务化方法将非幂等核转换为幂等核。此外,由于在REEF中只有best-effort内核可能会被抢占,这种转换只是牺牲了转换后的内核(即best-effort内核)的性能,以确保实时内核可以在到达时立即执行,而不会损失性能。在我们真正遇到非幂等DNN核之前,我们将这项技术的结合留到以后的工作中。
- Restrictions on kernel selection 内核选择的限制。当前的内核选择策略是有效但保守的,因为REEF的主要目标是避免对实时任务的性能干扰。一个明显的限制是,最佳内核的执行时间必须比填充的实时内核短,这限制了总体吞吐量的改进空间。我们发现GPU内核可以通过在模型编译过程中使用更多的线程块来定制更短的每个块的执行时间。例如,Apache TVM自动调优线程块的数量以提高整体性能,但也允许开发人员对其进行定制。目前,REEF的总体吞吐量提高主要归功于启用了即时内核抢占,这使得空闲的GPU可以执行最佳性能的任务。因此,我们把克服内核选择的限制留给未来的工作。此外,该策略不考虑实时内核和最佳努力内核之间的GPU内存争用,因为它仍然足以运行多个DNN推断任务。我们也把它留给未来的工作。
- Future GPU APIs and runtime未来的GPU API和运行时。我们利用GPU运行时的一些微妙的技巧,在普通GPU上启用基于重启的µs规模的抢占。我们的工作也为未来的GPU API和运行时的设计提供了参考。首先,考虑到普通GPU通常能够重置计算单元(CUs),一个单独的GPU API来精确重置CUs是可行的,这将有助于杀死和恢复所有运行的内核。其次,我们提出了一个新的GPU API,它指示命令处理器丢弃已获取的内核,并停止从设备队列(DQs)中获取更多的内核。在此基础上,DQs可以通过软硬件协同设计主动重置,取代我们的纯软件解决方案(即懒惰驱逐)。最后,GPU运行时可以为开发者提供一个高级的API来重置GPU流,通过丢弃内核缓冲在内部数据结构(例如,主机队列)和通过两个新的API重置GPU。我们相信这些扩展可以极大地简化实现,甚至在闭源GPU上完全实现基于重置的抢占,并进一步提高性能,例如在10个µs内立即抢占GPU。
9 相关工作
- DNN inference serving systems DNN推理服务系统。以前的模型服务系统主要关注于满足服务水平目标(SLO),通常在几十毫秒内实现,并提高数据中心应用程序的总体吞吐量。Clockwork利用DNN推断的延迟可预测性来实现低尾延迟。它在专用的GPU上顺序地运行推断,以提供可预测的性能。Clipper和Nexus支持在同一个模型上进行批处理推理,以提高GPU利用率和推理吞吐量。Abacus通过准确预测重叠算子的延迟,实现了同时进行DNN推理。INFaaS可以为每个推断自动选择具有不同优化的正确变体,以满足不同的SLOs。然而,数据中心应用程序的延迟SLOs比实时系统的要轻松得多,例如,它们的单独运行延迟是2倍。因此,使用非抢占式调度或批处理方案对数据中心应用程序是有效的,但对实时场景(如自动驾驶汽车)则无效。此外,REEF的设计与上述分布式服务系统正交。REEF中的两个关键机制也可以集成到它们中,以提高每个GPU的吞吐量,并为实时推断保持低延迟。
- GPU kernel preemption GPU内核抢占。除了软件抢占技术,之前的工作还提出了硬件增强以支持GPU抢占调度。一个直观的解决方案是支持GPU上的上下文切换。然而,由于大的上下文(例如,大量的寄存器),GPU上的开销要比CPU大得多。Zhen等人提出了轻量级上下文切换来避免不必要的寄存器保存。Tanasic等人扩展了硬件,通过停止发出新的线程块来被动抢占GPU的流多处理器(SM)。Chimera进一步建议在检测幂等执行时立即抢占SM刷新。不同的是,我们的方法改进了现有的硬件机制,不需要修改GPU来实现即时抢占。
- GPU multitasking GPU多任务。为了获得高吞吐量,已经进行了很多努力来并发执行多个GPU内核。对于DNN计算,Rammer在编译时采用了一种全面的方法来利用内核间和内核内的并行性,它使用静态内核融合来强制并发内核的CU赋值。然而,静态的核融合要求在编译时知道融合的核,这不适用于REEF中的动态任务调度。REEF提出了动态内核填充,允许在运行时做出调度决策。之前的工作还提出了一些方法来建模和预测并发内核执行的减速。DASE对并发内核的内存争用进行建模。Themis使用神经网络来预测性能干扰。预测可以帮助做出调度决策,以匹配实时内核的延迟需求。然而,预测并不总是准确的,减速确实发生了。不同的是,REEF中的动态内核填充强制并发内核只使用实时内核剩余的GPU资源。目前,REEF主要关注GPU计算资源(即CUs),并假设其他资源(如GPU内存和带宽)足够,我们把它留作以后的工作。
10 结论
本文提出了首个面向商用GPU的DNN推理服务系统REEF。在GPU调度中实现微秒级的内核抢占和控制并发执行,实现实时性和工作节省。首先,REEF可以通过在微秒级上主动杀死和恢复最佳内核来启动GPU上的实时内核。其次,REEF可以用适当的最佳内核动态填充实时内核,以完全利用GPU,而开销可以忽略不计。此外,我们为DNN推断服务构建了一个新的基准(DISB),它包含不同的工作负载和真实的跟踪。通过DISB和微基准测试验证了REEF在AMD和NVIDIA GPU上的有效性和有效性。
原文链接:https://www.usenix.org/conference/osdi22/presentation/han
