摘要
量子嵌入学习是量子机器学习应用于经典数据的重要一步。在本文中,我们提出了一种量子少样本嵌入学习范式,该范式学习了对训练下游量子机器学习任务有用的嵌入。至关重要的是,我们识别了混合神经网络中的电路旁路问题,其中学习的经典参数不能有效地利用希尔伯特空间。 我们观察到,与其他方法相比,少样本学习嵌入可以推广到不可见类,并且受电路旁路问题的影响较小。
1.引言
近年来,量子计算已在机器学习的背景下进行了研究,并被认为在增强现有机器学习算法方面具有巨大潜力。量子优势的核心证明在利用量子输入的方法中得到了证明,包括用于量子纠错和量子相位识别的量子卷积神经网络和加速线性代数子程序的量子核方法。另一方面,对于经典输入,参数化量子电路 (PQC) 通常用于编码经典信息,然后是变分处理电路和用于分类的测量电路。人们相信,这样的模型可能比它们的经典模型更具表现力和可训练性。 许多研究已经检验了这种编码—过程—测量范式,并论证了潜在的量子优势。
最近,寻找可以促进经典数据机器学习的混合量子经典机器学习架构受到了广泛关注。特别是 PQC 因其在近期设备上的可行性而受到重视。然而,这些方法也充满了理论证明的挑战。为了使量子机器学习具有优势,经典数据嵌入和量子数据嵌入之间需要有显著的几何差异,量子嵌入必须以比经典嵌入更低的复杂度映射到正确答案。此外,监督量子机器学习可以被视为一种核方法,其中变分处理电路被视为仅仅是测量的扩展,最重要的方面是嵌入电路。基于此,Lloyd等人提出了一种学习最大限度分离不同类别的量子嵌入的混合算法。
在本文中,我们提出了一种量子少样本嵌入学习范式,该范式学习了从经典数据到量子嵌入的映射,这对于训练下游量子机器学习任务很有用。 至关重要的是,我们确定了混合神经网络中的电路旁路问题,其中学习的经典参数与量子嵌入没有很大的几何差异。 我们观察到,与其他方法相比,少样本学习嵌入可以高精度泛化到看不见的类别,并且受电路旁路问题的影响较小。
为了进行这项研究,我们开发了一个量子机器学习库 QTensorAI,用于大规模机器学习研究。 由于模拟困难,讨论潜在量子优势的大量数值模拟和实验研究了小系统尺寸。 这种关注尤其成问题,因为已知一些具有少量量子比特的学习算法表现更好,但那些具有超过 10 到 15 个量子比特的学习算法明显更差,因为嵌入方案无法实现指数级大希尔伯特空间的大几何差异。 我们将高度并行的张量网络量子电路模拟与标准深度学习框架无缝集成,并能够模拟具有大量量子比特的电路。 这种能力使我们能够自信地验证我们的数值结果。
2.经典少样本学习
少样本学习 (FSL) 是一种机器学习范式,旨在解决一类监督学习问题,其中用户对监督数据的访问有限。 这种范式可能有助于类人学习的实验、从罕见案例中学习以及减少数据收集工作和计算成本。 FSL 与其他监督学习方法的主要区别在于使用先验知识。典型的FSL论文分类是基于如何使用先验知识来帮助解决问题:
- 数据方法:增加样本数量(数据增强,如旋转、裁剪等)
- 模型方法:约束假设空间(多任务学习、嵌入学习等)
- 算法方法:改变假设空间中的搜索策略(细化现有参数,细化元学习参数,学习优化器)
在这项工作中,我们研究了原型网络,这是一种使用嵌入学习的模型方法。 这使得原型网络(和其他嵌入学习方法)与我们的量子嵌入学习目标特别相关。
考虑一组 N 个图像
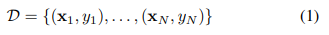
使用C类。 我们可以随机选择 个类,从每个类 中抽取 张图片组成支持集 ,再抽取多张图片组成查询集 。 目标是根据 中的标签预测 中图像的标签。 我们将此任务称为 ,这是一个 向 次射击的分类任务。
由于存在多种采样类和图像的方法,所以 遵循所有可能任务的分布。在验证过程中,只要从 中采样验证任务,算法就应该能够用少数几个例子正确地标记图像,即使对于训练期间从未见过的类也是如此。 我们通常需要大量的图像类来产生许多小样本任务。 总体而言,该算法必须学会提取通常对所有任务 有用的特征,而不是仅对一项特定任务有用的特征。
在原型网络和匹配网络中,使用神经网络提取单个图像的嵌入 。 对于原型网络,为每个类 生成一个原型嵌入:
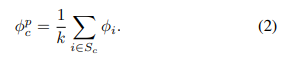
查询样本被分类到与查询嵌入的距离 最小的类中。 将查询样本 分类为 类的概率分布是在查询嵌入和所有类的原型嵌入之间的距离上的 softmax 函数:
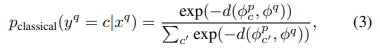
其中 是查询嵌入。 损失 是真实类 的负对数概率:
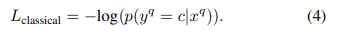
Euclidean距离 和相似样本的 更小。 Softmax 给出了 的目标并接受概率解释。
3.量子少样本学习
正如我们所提到的,学习最大程度地分离的量子嵌入至关重要,而不是依赖于固定的嵌入方案和训练处理电路。如果我们在一个特定的任务上训练网络,学习到的嵌入很可能是任务依赖的,在其他任务中不是很有用。传统上,嵌入学习可以通过使用无监督学习技术来实现,例如自动编码器,其中可以使用从编码器的瓶颈编码重新生成原始输入的解码器。虽然已经提出了自动编码器的量子变体,但据我们所知,它们并不是为学习经典数据的量子嵌入而开发的。
我们提出FSL作为量子嵌入学习的一个范例,因为它对数百或数千个任务进行了采样,因此生成的嵌入不是特定于任务的。最重要的是,我们观察到,与分类或回归嵌入相比,学习嵌入不形成一个低维流形,这一点我们将在结果(4.2节)的学习前量子嵌入小节中详细阐述。此外,学习的嵌入可以推广到不可见类。我们强调,我们不主张对 FSL 进行量子增强,尽管它本身就值得探索。 相反,我们在这个阶段专注于量子嵌入的少量增强及其局限性。
3.1量子嵌入
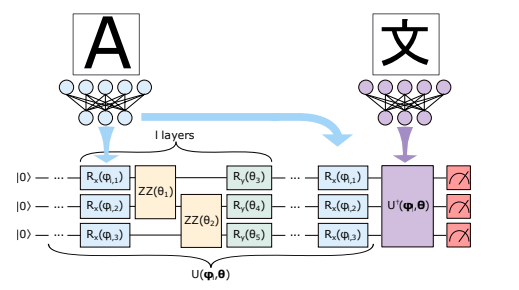
图 1. 量子 FSL 示意图。 两个字符的图像用经典神经网络处理,输出作为度量学习量子电路的φ参数。 该电路使用反演测试计算两个字符的量子嵌入之间的保真度,该测试测量 状态的幅度。
为了学习经典输入的量子嵌入,我们将算法中的距离估计部分替换为参数化的量子电路,如图1所示。对于每个输入样本 ,经典神经网络 ,其中除最后一层外,所有层都具有 ReLU 激活 ,将输入处理到距离评估部分,给出经典值
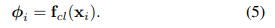
经典值用作量子电路 的旋转角度,将样本的经典嵌入转换为量子特征向量,该量子特征向量是电路产生的状态向量。 我们将这些学习到的经典旋转角度称为前量子嵌入。
考虑一个量子电路,它采用前量子嵌入 和独立于前量子嵌入的附加参数 。 嵌入的量子态是
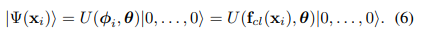
对于嵌入样本之间的距离度量,我们使用对应量子态之间的保真度:
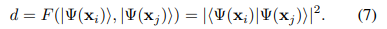
然而,在原型网络中,支持样本和查询样本之间的距离不是成对评估的。 相反,网络会生成一个类中所有支持样本的原型向量,这是所有向量的平均向量。 经典地,通过取所有经典值的平均值来获得原型向量是微不足道的。 然而,由于我们的嵌入是量子状态向量,因此在量子嵌入空间中构建原型向量并不容易。单纯地取经典前量子嵌入的平均值不会导致量子特征向量的线性和。 但是,由于我们只需要查询向量和 c 类原型向量之间的内积,并且内积是线性的,因此我们可以通过对所有支持向量和查询向量之间的各个内积求和来获得所需的内积:
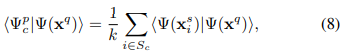
其中 是类的原型向量, 是第 个支持样本, 是查询样本。 如果我们想获得最终的内积,则必须获得各个内积的完整复振幅,而不仅仅是绝对值。 我们可以通过使用广义 Hadamard 测试来做到这一点,该测试在方法部分 (V-C) 中进行了讨论。 请注意,如果我们使用元学习的匹配网络范式,我们可以直接使用成对内积的绝对值,而不必担心复振幅,因为它不构造原型向量。
3.2损失函数
对于我们的量子模型,内积允许自然的概率解释,而不需要 softmax。 归一化的分类概率和损失为
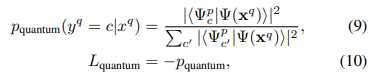
事实上,数值模拟表明,如果我们使用 softmax 概率和负对数概率损失,性能会稍差一些。
3.3量子电路ansatz
我们使用Lloyd等人提出的量子电路ansatz将量子前嵌入编码为量子特征向量。在他们的ansatz中,他们将所有的量子比特初始化为 状态,重复一个编码层 次,然后添加一层在量子前嵌入参数化的 门。对于单个编码层,他们执行单层 门,其角度为量子前嵌入,然后是一系列单独参数化的成对 门(对于我们的模拟,我们只包括最近邻 相互作用),然后是一层单独参数化的 门。 门和 门的参数与量子前嵌入无关,并且在不同的输入中保持不变,但它们在训练期间会更新:它们是量子电路独有的参数。 我们将这些参数表示为 。
我们将Lloyd等人提出的ansatz称为度量学习ansatz。我们还研究了初始化决定电路纠缠程度的θ参数的影响。在规定的范围内均匀初始化 。当初始化范围为 时,电路相当于仅由单量子比特旋转门组成的电路。我们可以将这个范围增加到 来提高电路的纠缠度。
在非纠缠情况下,得到的 n-qubit 状态是
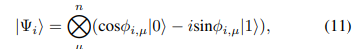
由于在多个层中顺序应用 旋转,角度的乘法因子最多。 两个样本对应的两个状态之间的内积为
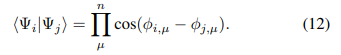
这是一个合理的结果,因为我们期望具有相似角度的输入具有较大的内积。 此外,我们可以轻松地编码 个相互正交的状态。 当然,由于我们没有使用纠缠,这只是一种受量子启发的、经典易处理的表示。 弱纠缠的 ansatz 试图将其带入更经典的难以处理的表示。
相比之下,经典的余弦距离只能编码 个正交向量。对于Euclidean距离,我们可以编码无穷多个“近似正交”的向量,因为我们可以简单地将它们在一个大(但只有 维)空间中展开,而ssoftmax 函数中的负指数会使它们的混淆概率很小。
4.混合学习结果
4.1少样本学习基准
对于经典网络,我们研究了Euclidean距离和余弦距离度量的性能。众所周知,欧氏距离优于余弦距离;并且由于量子内积更类似于余弦距离,我们认为余弦距离是更公平的比较。
我们使用的数据集是Omniglot数据集。Omniglot由50个字母中的1623个手写字符组成,每个字符有20个示例。我们按照Snell等人的默认设置,在60路5发任务上训练,在5路5发任务上测试。我们评估了大小为64的前量子嵌入模型的性能,这些模型对应64个量子比特。性能对比如图2所示。我们最好的量子模型达到了98%以上的分类测试精度,这是显著的。我们强调,测试精度是在训练中从未见过的字符类型上计算的,这表明量子嵌入方案具有很强的泛化能力。
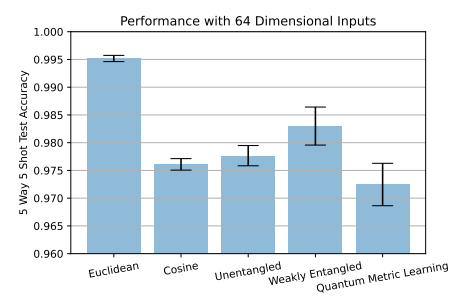
图 2. Omniglot 数据集基准模型的性能。 所有模型都训练了 10 个 epoch。 训练期间的最高测试准确度取自每次试验,平均超过 10 次试验。
量子学习的结果比使用Euclidean距离的经典学习结果略差。这并不奇怪,因为Euclidean距离允许模型将许多集群打包到一个维度中,只要它们是分开的。另一方面,内积类型度量只能通过角度分离来区分向量。然而,量子变体确实优于经典余弦距离对应物。事实上,我们可以从图3中看到,当我们稍微打开纠缠时,模型性能实际上在再次下降之前有所提高。未来的工作可以通过更智能的ansatz设计、初始化和训练过程来改进这一点,以更好地利用希尔伯特空间。
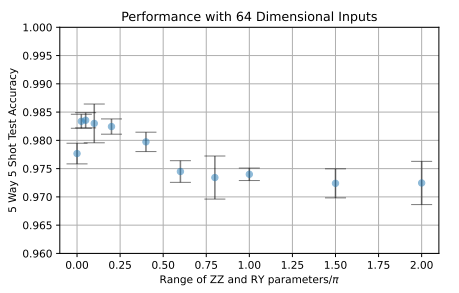
图 3. 模型性能与初始化时的纠缠量。 Ry 和 ZZ 门由 θ 参数化,从一个范围内均匀采样。 范围越大,电路越纠缠。 除图 2 中已显示的结果外,结果是3个试验的平均值。
4.2学习的前量子嵌入
正如我们从量子 FSL 的结果中看到的那样,某些问题阻碍了量子编码器的大希尔伯特空间的有效利用。 我们试图通过检查学习的前量子嵌入来提高我们对潜在原因的理解。
(1)低维任务:为了简单起见,我们首先考虑在分类、单变量回归和双变量回归任务中学习的前量子嵌入,而不是FSL。实现的细节可以在方法部分(5.2节)中找到。结果分别如图4、5、6所示。
对于分类任务,我们发现前量子嵌入集中在两个点上。每个点对应一个不同的标签。这表明经典神经网络学习对样本进行分类并简单地输出会产生正确测量值的前量子嵌入值。
对于单变量回归任务,前量子嵌入形成一条直线。此外,这条线在特征空间的一个区域上,这样预期的测量结果将跨越一个范围的值,这是回归所需要的:我们注意到,在这个和其他试验中,前量子嵌入倾向于跨越白色区域,从蓝色到红色。这表明经典网络学习输出能导致正确预测的前量子嵌入。
对于双变量回归任务,我们使用两个量子电路,每个负责预测值的一个组成部分。对于已知的前量子嵌入的解释比较困难。然而,我们期望它需要占据一个二维区域才能给出不同的二维输出。
总的来说,我们观察到如果目标输出是 维的,学习到的前量子嵌入将占用一个 维流形。如果我们希望利用量子神经网络的潜在优势,这就尤其成问题。本质上,经典神经网络只关心让量子神经网络给出正确的输出,而不是利用量子电路,本质上绕过电路,把它当作一个奇怪的非线性处理。我们称之为电路旁路问题。前量子嵌入空间的低维实际上如图 5 所示。但当时并不认为这是一个问题。在他们的工作中,学习到的前量子嵌入形成0-D点进行分类,这表明我们关于电路旁路问题的陈述也出现在更复杂的结构和问题中。
更形式化地说,设输出空间为 ,并假设在 维空间 中训练的预量子嵌入点云是使用单位球上支持的概率度量 进行采样的。 我们假设对于未经特殊处理的混合网络训练,存在子流形 使得 ,其中 从分布测量流形的误差, , 是 维子流形族, 中的单位球体积 且达到率 , 是约束流形复杂度的超参数, 是相关常数。换句话说,前量子嵌入近似占据一个 维流形 。
此外,对于满足条件的最小 , 可能是微分同胚,其中 是从流形到输出空间的函数,以流形中的点作为输入。 这与使用量子增强特征空间学习的量子优势条件形成对比,其中多对一映射是特征。
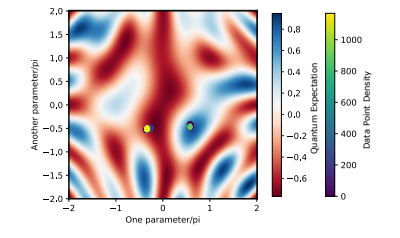
图 4. 在量子特征空间中嵌入数据点进行分类。 跨越整个域的蓝红色图像是学习到的量子电路的特征空间。 这些图显示了具有不同前量子编码输入的量子电路的测量期望。 蓝黄色密度散点图显示给定所有可能输入的预量子嵌入的密度。
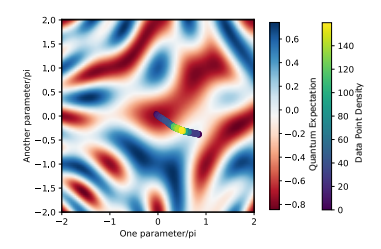
图 5. 在量子特征空间中嵌入数据点以对一个变量进行回归。
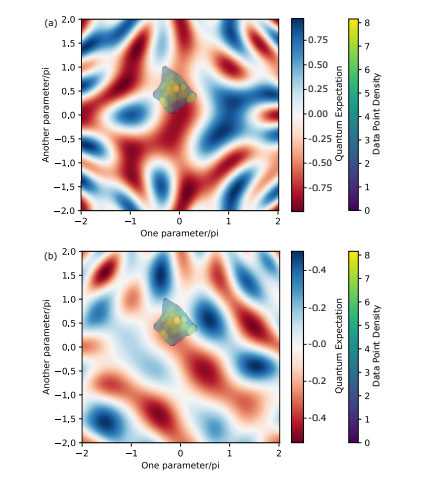
图 6. 在量子特征空间中嵌入数据点以进行两个变量的回归。
(2)少样本学习:我们现在回到少样本学习。 一般来说,需要区分数百个类别的图像意味着学习的嵌入应该尽可能地占据嵌入空间以减少混淆,因此通常在高维流形上(受嵌入空间的维度限制) . 事实上,我们验证了 Omniglot 数据集的学习前量子嵌入确实占据了多个维度。 我们对前量子嵌入进行主成分分析,并在图 7 中显示了相对于成分数量的解释方差。 我们观察到需要大约 15 个维度来解释 90% 的方差,这表明嵌入不是低维的。
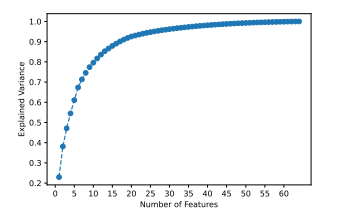
图 7. 解释了前量子嵌入组件数量的方差。
为了深入检查嵌入,我们随机选择 10 类字符,并在图 9 中使用 t-SNE在 2D 中可视化它们的嵌入。 我们观察到前量子嵌入根据它们的类分配形成集群。 为了检查量子嵌入,我们不是直接计算希尔伯特空间状态向量,这对于 64 个量子位来说非常困难,我们使用图 8 中的MDS根据它们的成对距离将量子嵌入投影到 2D 平面上。具体来说, 我们使用内积平方的负对数作为成对相异性。 可以清楚地看到,前量子嵌入空间的结构几乎保留在量子嵌入空间中。 这种情况不能承认量子嵌入和经典嵌入之间存在很大的几何差异,从而排除了量子优势。
我们认为这个问题类似于低维流形问题。由于量子电路很好地保留了数据点之间的几何关系,函数 可能是微分同胚,其中 是前量子嵌入的最小近似流形, 是量子希尔伯特空间。 因此,我们也在电路旁路问题下确定了这个问题。
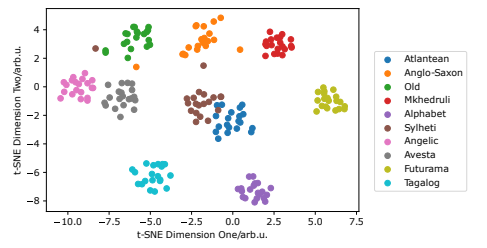
图 8. FSL 的前量子特征空间嵌入。
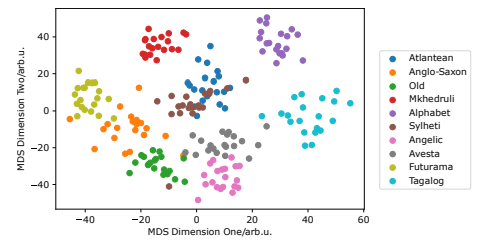
图 9. FSL 的量子特征空间嵌入。
5.研究方法
5.1并行算法和高性能模拟
在深度学习中,训练神经网络需要成千上万的样本,经常需要并行计算。通常,一批训练样本被传递到神经网络并并行处理以加快训练速度。训练量子神经网络更加困难,因为随着量子比特数量的增长,模拟量子电路的成本是指数级的。我们采用两种方法来加速量子神经网络:张量网络方法和用于量子模拟的批并行。其结果是,我们为浅层电路带来了量子位数量的线性成本,并能够有效地利用所有可用的GPU资源。
(1)张量网络模拟器:张量网络模拟器将量子电路视为一张图。 使用张量网络模拟器最直接的方法是评估电路在两个计算基态之间的转换幅度。 这种幅度的评估对应于将张量网络收缩为零秩张量。 在大 和小 的限制下,张量网络在层方向将具有较小的横向尺寸,并且可以在纵向量子比特方向上收缩以最小化需要存储的张量的最大秩。 由于内存成本与张量的秩成指数关系,因此找到最小化秩的收缩顺序至关重要,并且通常不会归结为沿量子比特方向收缩等启发式方法。
我们的模型评估了编码电路准备的两个量子态之间的保真度,即:
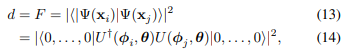
当将样本 的编码电路与样本 的逆编码电路连接时,它可以精确地根据 状态之间的转换幅度来计算。 对于这项工作,我们使用一个张量网络模拟器平台QTensor来研究量子近似优化算法。 (QAOA) 在高性能计算环境中。 它基于 QTree 模拟器。
(2)AI 的批量并行性和 GPU 优化:QTensor 旨在一次评估单个大型电路。在深度学习任务中,我们通常仅限于较小的电路,但需要在整个批次或其他并行维度(即卷积引起的维度)上使用不同的参数化来评估它们。由于需要更新 QAOA 参数,QTensor 已经配备了反向传播,并且它有一个 PyTorch 后端来支持它。因此,原则上它对并行化很友好,我们开发了库 QTensorAI,通过将量子神经网络的组件包装为 nn 来实现并行性和与 PyTorch 模型的便捷接口。模块对象。因为给定模块的相同电路将被执行数千甚至数百万次,所以优化电路收缩顺序以在模型初始化时积极地最小化最大张量等级然后重用此收缩顺序以供将来执行是有利的。
此外,通过使用 PyTorch CUDA Graphs,我们进一步加快了模拟速度。 对于需要许多收缩步骤的电路,CPU 需要启动 GPU 内核数百或数千次,从而产生大量开销。 跟踪 CUDA 图形允许捕获和重放静态图形,从而将 CPU 调用减少到单个图形启动操作。
5.2低维任务的细节
除量子电路之前的层外,所有用于低维任务的经典神经网络都有 8 个具有 ReLU 激活的全连接层。 对于分类或回归任务,我们不需要将自己限制在内核方法中,而是使用需要成对评估的度量学习 ansatz。 相反,这里使用的所有电路都有两个量子位,并遵循 Abbas 等人使用的 ansatz。其中输出是测量预期。 具体来说,来自经典神经网络的两个输入值被馈送到编码电路,然后是三个变分层,其参数分别进行优化。
我们对所有任务使用二维输入。对于分类任务,如果第一个分量大于第二个分量,我们分配标签 。否则,它被分配 。 对于单变量回归任务,目标值与两个分量之间的差异成正比。 对于二元回归任务,一个目标值与差值成正比,另一个与两个分量之和成正比。
5.3Hadamard测试
为了获得真实设备上量子嵌入的内积的复数值,我们可以使用Hadamard测试。该测试通过图10所示的电路估计 (或修正后的 )。估计值由在 中测量附属物的概率差异给出。
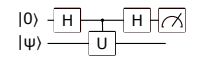
图 10. Hadamard 测试电路。
在我们的例子中,
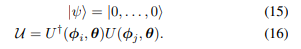
此外,为了实现度量学习 ansatz 的受控 ,我们只需要单量子比特受控门:我们已经控制了依赖于 的 门,如果ancilla在 和 门不执行, 依赖的 和 门将相互抵消。
6.结论与展望
我们研究了量子少样本学习范式作为学习通用量子嵌入的方法。 我们发现我们的弱纠缠量子嵌入表现出优于经典余弦距离的性能。 尽管由于欧几里德距离产生了更好的结果,因此该结果并未对小样本学习提供量子增强,但与替代方法相比,通过小样本学习获得的量子嵌入具有最理想的特性。 首先,学习到的嵌入可以很好地泛化到看不见的类。 其次,与基于分类的嵌入学习方法相比,量子少样本嵌入不占用低维流形。
我们确定了可能困扰混合量子嵌入学习方法和其他混合架构的电路旁路问题,使它们无法实现高几何差异,因此无法实现量子优势。然而,通过惩罚低维流形的形成或最大化几何距离来规范前量子嵌入空间的方法可以解决这个问题。最近,一种鼓励低维流形的正则化已经被开发出来,它计算流形维数并将其添加到损失函数中。在我们的设置中,我们可以减去流形维度来强制嵌入占据高维流形。此外,可以显式计算经典前量子和量子嵌入之间的几何差异并将其添加到损失函数中,从而鼓励非平凡的量子编码。这些方向具有缓解电路旁路问题并保证未来的研究的潜力。
原文链接:https://arxiv.org/pdf/2204.04550.pdf
---煤油灯科技victorlamp.com翻译整理---
