摘要
本论文展示了 BulletArm,这是一种用于机器人操作的新颖基准和学习环境。BulletArm 围绕两个关键原则设计:可重复性和可扩展性。我们的目标是通过在模拟中提供一组标准化的基准任务以及一组基线算法来鼓励机器人学习方法之间更直接的比较。该框架由 31 个不同难度的不同操作任务组成,从简单的到达和拣选任务到更现实的任务,如装箱和托盘堆垛。除了提供的任务之外,BulletArm 的构建便于轻松扩展,并提供了一套工具来帮助用户在向框架中添加新任务时提供帮助。此外,我们介绍了一组五个基准,并使用一系列最先进的基线算法对其进行评估。
1.引言
受近期深度学习在计算机视觉领域取得成功的启发,旨在将深度学习算法应用于各种学科的工作出现了爆炸式增长。例如,深度强化学习已被用于学习在各种游戏中实现超人级别表现的策略。近年来,机器人技术也出现了类似的激增,特别是在机器人操作强化学习领域模仿学习和多任务学习。然而,目前的机器人学习研究与过去将深度学习应用到其他领域的工作之间存在着关键的区别,目前还没有一个被广泛接受的标准来比较基于学习的机器人操作方法,例如在计算机视觉中,ImageNet基准测试一直是我们最近看到的图像分类算法爆发的一个关键因素。
虽然在类似于机器人操作的领域有策略学习的基准,比如OpenAI Gym和DeepMind control Suite中的连续控制任务,但它们并不适用于我们对机器人感兴趣的更多现实任务。此外,不同的机器人实验室在现实世界中使用截然不同的系统,使用不同的机器人、传感器等。因此,研究人员经常开发自己的训练和评估环境,使得比较不同的方法非常困难。例如,即使是像块堆积这样的简单任务,在不同的工作之间也可能有很大的可变性,包括不同的物理模拟器,不同的操作器,不同的对象大小等等。
在这项工作中,我们介绍了一个基于两个关键组件的机器人操作学习新框架Bullettarm。首先,我们提供了一个灵活的、开源的框架,它支持许多不同的操作任务。与之前的工作相B比,我们引入了不同难度的任务,要求不同的操作技巧。这包括监督 Covid 检测等长期计划任务,以及需要精确推送或推动行为的接触丰富的任务。目前,Bullettarm由31个独特的任务组成,用户可以轻松地定制这些任务,以模拟他们在现实世界中的实验室设置(例如,工作空间大小,机械臂类型等)。此外,Bullettarm的开发重点是可扩展性,因此可以根据需要轻松创建新任务。其次,我们将五个不同的基准与一组标准化基准一起包含,以供用户快速地对他们的工作进行基准测试。我们对这些基线的实现,希望新用户将它们应用于他们对现有任务的定制以及他们创建的任何新任务。
我们的贡献可以概括为三点:首先,我们提出了一个基准和学习框架,它包含一组21个开环操作任务和10个闭环操作任务。我们在之前的许多工作中开发了这个框架。其次,我们提供了最先进的基线算法,使其他研究人员能够在不可避免地向基线添加新任务时,轻松地将他们的工作与我们的基线进行比较。第三,BulletArm提供了广泛的工具套件,允许用户根据需要轻松创建新任务。我们的代码可在https://github.com/ColinKohler/BulletArm获得。
2.相关工作
- 强化学习的环境 在比较不同的强化学习算法时,标准化环境是非常重要的。许多之前的作品都开发了各种电子游戏环境,包括《 PacMan》《吃豆人》、《Super Mario》《超级马里奥》、《Doom 》《毁灭战士》和《StarCraft》《星际争霸》。OpenAI Gym为代理和环境之间的通信提供了一个标准API,以及各种不同环境的集合,包括来自街机学习环境(ALE)的Atari游戏和一些使用MuJoCo实现的机器人任务。DeepMind控制套件(DMC)提供了一组类似的连续控制任务。尽管OpenAI Gym和DMC都有一小组机器人环境,但它们都是玩具任务,并不能代表我们对机器人感兴趣的真实世界任务。
- 机器人操作环境 在机器人操作中,有许多监督学习背景下的抓取基准,例如Cornell数据集、Jacquard数据集和GraspNet 1B数据集。另一方面,在强化学习的背景下,之前的大多数框架都专注于单个任务,例如开门、家具组装和手灵巧操作。另一组先前的工作提出了包含各种不同环境的框架,如robosuite 、PyRoboLearn和Meta-World,但通常仅限于短水平任务。Ravens传送器引入了一组包含复杂操作任务的环境,但将末端执行器限制为吸盘夹持器。RLBench 提供了一个与我们的学习框架类似的学习框架,但有一些关键的区别。首先,RLBench是围绕PyRep接口构建的,因此构建在V-AREP 之上。此外,RLBench在工作空间场景、机器人等方面的限制比BulletArm更严格。
- 机器人操纵控制 有两种常用的末端执行器控制方案:开环控制和闭环控制。在开环控制中,代理既选择末端执行器的目标位姿的目标位姿,又选择某个动作原语在该位姿上执行。开环控制通常具有较短的时间范围,允许代理解决需要较长轨迹的复杂任务。在闭环控制中,代理设置末端执行器的位移,这使代理更容易从故障中恢复,这在延迟与接触丰富的任务是至关重要的。BulletArm提供了两种设置下的环境集合,允许用户根据自己的研究兴趣选择其中一种。
3. 架构
我们学习框架的核心是PyBullet模拟器。PyBullet是一个用于机器人仿真和机器学习的Python库,专注于模拟到真实的转换传输。PyBullet构建在Bullet Physics SDK之上,提供正向动力学模拟、逆动力学计算、正向和逆运动学、碰撞检测等访问。除了物理模拟,还有许多用于场景渲染和可视化的工具。BulletArm建立在PyBullet的基础上,提供了一套适合机器人操作模拟的多样化工具。
3.1 设计理念
我们框架背后的设计理念集中在四个关键原则上:
1. 可重复性:在开发新的学习算法时,一个关键挑战是很难将它们与以前的工作进行比较。在机器人领域,这个问题尤其普遍,因为不同的研究人员有截然不同的机器人设置。这些差异可以很小,比如工作空间的大小或物体的退化,也可以很大,比如用于进行实验的机器人。转移到模拟允许这些因素的标准化,但可能会影响训练过的算法在现实世界中的性能。我们的目标是通过提供一个灵活的模拟环境和一些基线来鼓励作品之间更直接的比较。
2. 可扩展性:尽管我们包含了许多任务、控件类型和机器人,这些领域总是需要进一步发展。使用我们的框架,用户可以轻松地添加新任务、机器人和对象。我们选择不限制任务,允许用户更自由地创建有趣的域。图1显示了使用我们的框架创建新任务的示例。
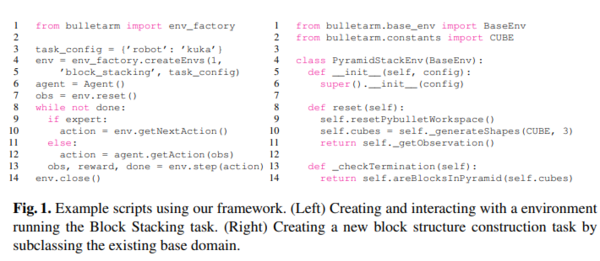
图 1:使用我们框架的示例脚本:(左)创建运行 Block Stacking 任务的环境并与之交互,(右)通过对现有基域进行子类化来创建新的块结构构建任务。
3.性能:深度学习方法通常是耗时的,过程缓慢,加上物理模拟器可能会导致较长的训练时间。我们花了大量的时间来确保我们的框架不会通过优化模拟和允许用户并行运行多个环境来限制训练。
4. 可用性:一个好的开源框架应该易于使用和理解。我们提供了详细介绍框架关键组件的大量文档,并提供了一组演示如何使用环境和如何扩展环境的教程。
3.2 环境
我们的模拟设置(图4图5)包括安装在模拟环境地板上的机械臂、机器人前面生成对象的工作空间和传感器。通常,我们使用自上而下的传感器来生成工作空间的高度图。由于我们只将感知数据限制在已定义的工作空间中,所以我们选择不向设置中添加不必要的元素,如手臂所坐的桌子。
环境、配置和情节是我们框架中的三个关键术语。环境是PyBullet模拟器的一个实例,在该环境中,机器人在尝试解决某些任务时与对象进行交互。这包括初始环境状态、奖励函数和终止需求。配置包含任务的附加规范,如机械臂、工作空间的大小、物理模式等。情节是通过在环境中采取行动(步骤)生成的,直到情节结束。集合轨迹τ包含一系列观测o、动作a和奖励 : =【(o,a ,r ),…,(o ,a ,rT_T )】。
用户通过EnvironmentFactory和Environmenttrunner类与学习环境交互。EnvironmentFactory是入口点,它创建作为输入传递的Configuration所指定的Environment类。EnvironmentFactory可以创建单个环境,也可以创建要并行运行的多个环境。在这两种情况下,都会返回一个Environmenttrunner实例,并提供与环境交互的API。这个API是根据OpenAI Gym推广的典型代理环境RL设置建模的。
我们提供的基准任务有一个稀疏的奖励函数,当任务成功完成时返回+1,否则返回0。虽然我们发现这个奖励函数是有利的,因为它避免了由于奖励形成而产生的问题,但我们并不要求新任务符合这个函数。在定义新任务时,奖励函数默认为稀疏,但用户可以很容易地为新任务定义自定义奖励。我们根据操作空间将任务分为两类:开环控制和闭环控制。这两种控制方式是机器人操作研究中常用的控制方式。
3.3 专家演示
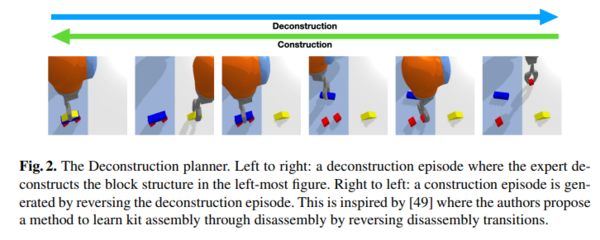
图2:解构计划器。从左到右:解构情节,专家解构最左边的人物的块状结构。从右到左:通过反转解构情节生成构建情节。这是受到[form2fit]的启发,作者提出了一种通过反向拆卸过渡来学习套件组装的方法。
专家演示对许多机器人学习领域都至关重要。例如,模仿和基于模型的学习等方法直接从专家演示中学习。此外,我们发现,在强化学习的背景下,由于探索大型状态行动空间的困难,用专家演示来播种学习是至关重要的。我们提供了两种类型的规划器来促进专家数据的生成:路径点规划器和解构规划器。
路径点规划器是一种在线规划方法,它通过工作空间中的一系列路径点移动末端执行器。我们将路径点定义为wtw_{_t} =(ptp_t ,ata_t ),其中ptp_t 是末端执行器的期望姿态,ata_t 是在该姿态上执行的动作原语。这些路径点可以是工作空间中的绝对位置,也可以是相对于工作空间中的对象的位置。在开环控制中,规划器返回路径点wtw_t 作为t时刻执行的动作。在闭环控制中,规划器将连续返回来自当前末端执行器位姿的小位移作为t时刻的动作。这个过程不断重复,直到到达路径点。解构规划器是一种更有限的规划方法,它只能应用于以特定方式排列对象的取放任务。例如,我们将此计划器用于本工作中检查的各种块构造任务(图2)。当使用此计划器时,工作区将使用目标配置中的对象进行初始化,然后将对象逐个删除,直到达到任务的初始状态。这个解构轨迹,然后被反转,产生一个专家构建轨迹,τexpert\tau_{\exp ert} =reverse(τdeconstruct)reverse\left(\tau_{deconstruct}\right) 。
3.4 机器人
不同的机械臂可以导致截然不同的政策。为了方便模拟到真实的转换,我们提供了一些不同的常见机械臂。我们提供了四种不同的机器人手臂(图3):KUKA IIWA , Frane Emika Panda , Universal Robots UR5带有平行爪, Universal Robots UR5带有Robotiq 2F-85爪。在提供机器人模型的情况下,可以根据需要相对容易地添加其他机械手。
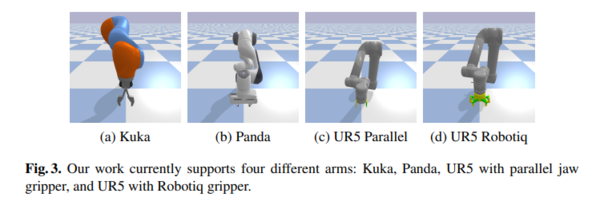
图 3:我们的工作目前支持四种不同的手臂:Kuka、Panda、带有平行颚式夹具的 UR5 和带有 Robotiq 夹具的 UR5。
4.环境
任何好的基准测试的核心都是它的环境。在机器人操作中,尤其重要的是要涵盖广泛的任务难度和多样性。为此,我们介绍了包括开环和闭环控制的各种技能的任务。此外,我们的环境的可配置参数使用户能够选择不同的任务变体(例如,用户可以选择工作空间中的对象是否将以随机方向初始化)。目前,bullettarm提供了21个开环操作环境的集合和10个闭环环境的集合。然而,如第3节所示,用户也可以使用我们的框架轻松创建新环境。
4.1 开环环境
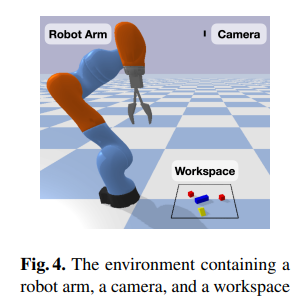
图 4:包含机械臂、摄像头和工作空间的环境
在开环环境中,代理控制末端执行器的目标位姿,从而使复杂任务的时间范围缩短。开环环境由机械臂、工作空间和工作空间上方的摄像机组成(图5)。动作空间定义为夹持器运动AgA_g ={pick,place}与夹持器针对该运动的目标姿态APA_{_P} , AA =AgA_g ×ApA_p 。状态空间定义为SS =(II ,HH ,GG )∈SS (图5),其中II 为工作空间的自上而下高度映射;GG ∈{holding,empty}表示夹持器状态;HH 是手握图像,显示当前被握住的物体。如果最后一个动作是pick,那么HH 是前一个时间步中以pick位置为中心的高度图的裁剪。如果最后一个动作是place, HH 被设置为零值图像。
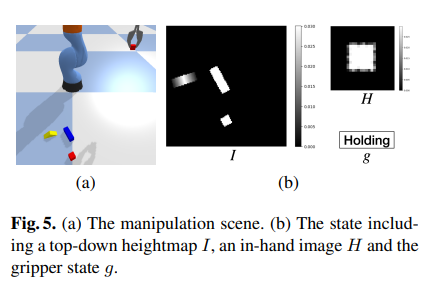
图 5: (a) 操作场景。(b) 状态包括一个自上而下的高度图I,一个手持图像H和夹具状态g。
Bullettarm为ApA_p 提供了三个不同的动作空间:ApA_p ∈{AxyA^{xy} ,AxyθA^{xy_{\theta}} ,AseA^{se} }。第一个选项( x,yx,y )∈AxyA^{xy} 仅控制夹持器位姿的( x,yx,y )分量,其中夹持器的旋转是固定的。zz 使用启发式函数选择,首先读取周围区域的最大高度( x,yx,y ),然后为位置动作添加正偏移量,或为拾取动作添加负偏移量。第二个选项( x,y,θx,y,\theta)∈AxyθA^{xy\theta} 增加了对沿zz 轴旋转θ\theta 的控制。第三个选项(x,y,z,θ,φ,ψx,y,z,\theta,\varphi,\psi )∈AseA^{se} 控制完整的6自由度姿势的夹持器,包括旋转沿y轴φ和沿x轴ψ的旋转。AxyA^{xy} 和AxyθA^{xy\theta} 适用于只需要自顶向下操作的任务,而AseA^{se} 适用于解决涉及平面外旋转的复杂任务。
图6显示了可以使用自顶向下操作解决的12个基本开环环境。这些环境可以分为两个集合,一组是块结构任务(图(6)a-(6)g),一组是更现实的任务(图(6)h和(6)l)。块结构任务要求机器人使用块构建不同的目标结构。更现实的任务需要机器人完成一些现实世界的问题,例如,安排瓶子或监督 Covid 检测。我们在所有开环环境中使用默认的稀疏奖励函数,即达到目标时奖励为+1,否则为0。
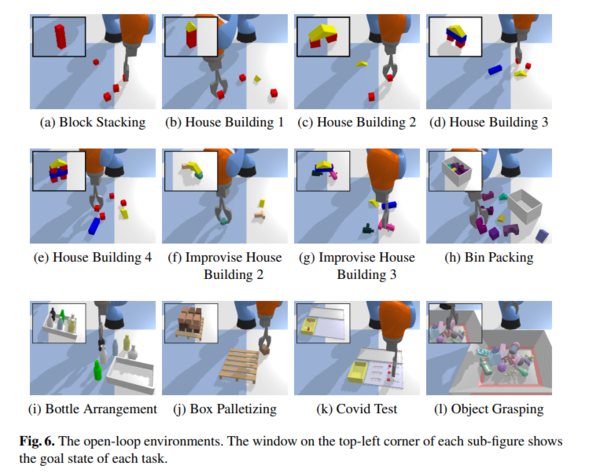
图 6:开环环境。每个子图左上角的窗口显示每个任务的目标状态。
4.4.1 6Dof扩展
到目前为止,我们介绍的环境只要求机器人执行自上而下的操作。通过在斜坡环境或凹凸环境中初始化这些环境,我们将这些环境扩展到6个自由度(图7)。在这两种情况下,机器人需要控制由斜坡或凹凸引入的平面外方向,以便操作对象。我们提供了7个斜坡环境(用于每个块结构建设任务),和2个凹凸环境(房屋建筑4和箱子码垛)。
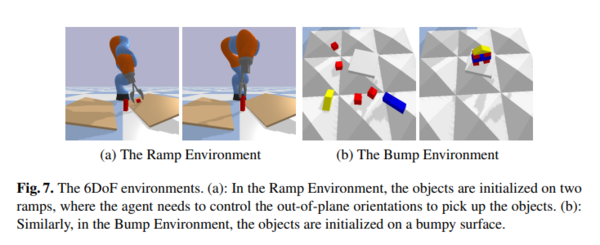
图 7: 6DoF 环境。(a):在斜坡环境中,物体在两个斜坡上初始化,代理需要控制平面外方向来拾取物体。(b):类似地,在凹凸环境中,对象在凹凸不平的表面上进行初始化。
4.2 闭环环境
闭环环境要求代理控制末端执行器的delta位姿,允许代理有更多的控制,使我们能够解决更多接触丰富的任务。这些环境的设置与开环域类似,但为了避免手臂造成的遮挡,我们使用两个侧视摄像机指向工作空间(图(8)a)。首先从两个摄像机获取融合的点云(图(8)b),然后执行正交投影(图(8)c),生成高度图I。这个正投影以夹持器为中心。在实践中,这一过程可以通过在夹持器的位置放置一个模拟正投影相机来取代,以加快模拟速度。状态空间定义为元组sSS =(II ,GG )∈SS ,其中gg ∈{holding,empty}是夹持器状态,表示夹持器是否持有一个对象。动作空间定义为夹持器开幅AλA_{\lambda} 与夹持器的三角运动AσA_{\sigma} 的叉乘,AA =AλA_{\lambda} ×AσA_{_{_{\sigma}}} 。
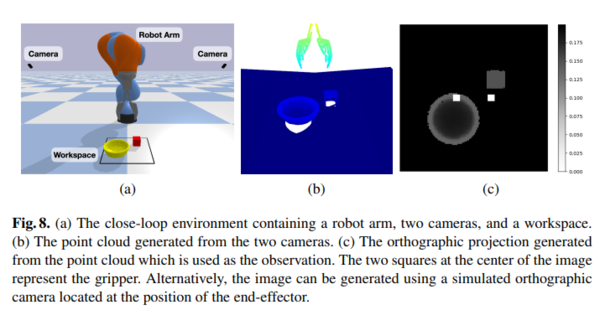
图 8: (a) 包含一个机械臂、两个摄像头和一个工作空间的闭环环境。(b) 两台摄像机生成的点云。(c) 从点云生成的正投影,用作观测。图像中心的两个方块代表抓手。或者,可以使用位于末端执行器位置的模拟正交相机生成图像。
图9显示了10个闭环环境。我们为所有环境提供一个默认的稀疏奖励函数。
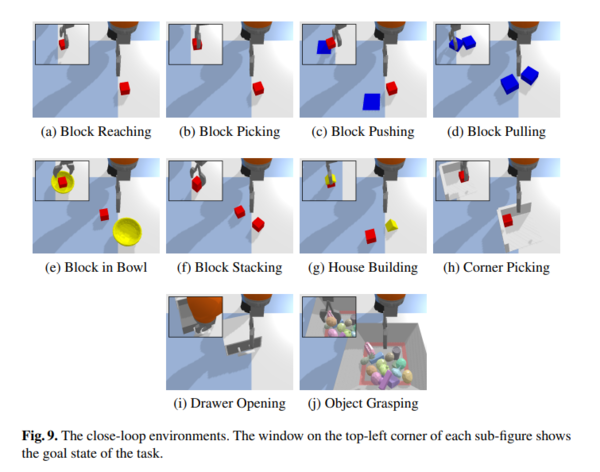
图 9:闭环环境。每个子图左上角的窗口显示任务的目标状态。
5 基准
Bullettarm提供了一组涵盖各种环境和动作空间的5个基准测试(表1)。在本节中,我们详细介绍了开环3D基准测试和闭环4D基准测试。
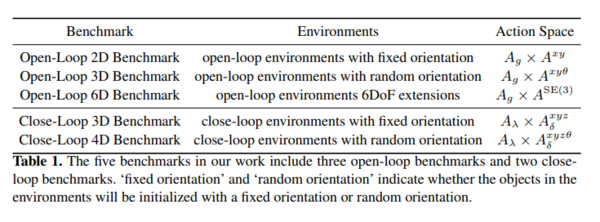
表 1:我们工作中的五个基准包括三个开环基准和两个闭环基准。“固定方向”和“随机方向”表示环境中的对象将被初始化为固定方向还是随机方向。
5.1 开环3D基准测试
在开环3D基准测试中,代理需要使用AgA_g ×AxyθA^{xy\theta} 操作空间解决图6中所示的开环任务(参见4.1节)。我们提供了一组基线算法,显式控制(x,y,θx,y,\theta )∈AxyθA^{xy\theta} ,并使用以下启发式选择夹持器运动:如果g=empty将执行一个拾取动作,如果g=holding将执行一个放置动作。基线包括:(1)DQN, (2) ADET, (3) DQfD, (4) SDQfD。这些不同方法的网络体系结构可以互换使用。我们提供以下网络架构:
- CNN ASR:一种按顺序选择(x,y)和θ的两层结构。
- Equi ASR):与ASR类似,但不是使用传统的CNN,而是使用等变可导向CNN来捕获任务的旋转对称性。
- FCN:一种完全卷积网络(FCN),它为每一个离散旋转输出一个n通道的动作值映射。
- Equivariant FCN:类似于FCN,但不是使用传统的CNN,而是使用等变可导向CNN。
- Rot FCN :一个具有1通道输入和输出的FCN,旋转是通过旋转每个θ的输入和输出来编码的。
在本节中,我们将展示SDQfD的性能(它优于DQN、ADET和DQfD。DQN、ADET和DQfD的性能见附录E)配备CNN ASR、Equi ASR、FCN和Rot FCN。我们在图6所示的12个环境中评估SDQfD。表2给出了开环基准实验的对象数量、每集最优步数和每集最大步数。在训练开始之前,专家数据被填充到回放缓冲区中。图10显示了结果。等变ASR(蓝色)在所有环境中具有最好的性能,然后是Rot FCN(绿色)和CNN ASR(红色),最后是FCN(紫色)。请注意,等变ASR是唯一能够解决最具挑战性任务的方法(例如,临时搭建房屋和Covid测试)。
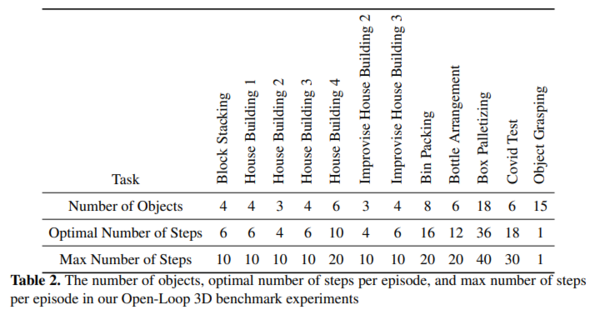
表 2:我们的开环 3D 基准实验中的对象数量、每集的最佳步数和每集的最大步数
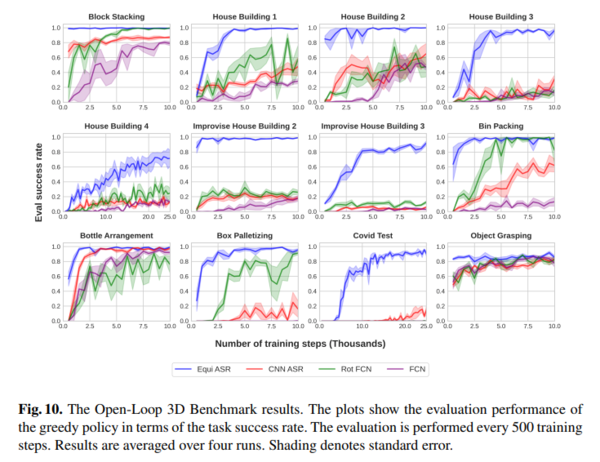
图10.开环3D基准测试结果。图中显示了贪婪策略在任务成功率方面的评价性能,每500个训练步骤执行一次评估,结果是四次运行的平均值,阴影表示标准误差。
5.2 闭环 4D 基准测试
闭环4D基准要求代理在(λ,x,y,z,θ\lambda,x,y,z,\theta )∈Aλ_{\lambda} ×Aδ_{\delta}xyzθ^{xyz\theta} 的五维动作空间中解决图9所示的闭环任务,其中代理控制着夹持器的位置位移(x,y,zx,y,z ),夹持器沿z轴的旋转位移(θ),夹持器的开宽(λ)。我们提供了以下基线算法:(1)SAC ,(2) Equivariant SAC, (3) RAD ,SAC:带有数据增强的SAC, (4) DrQ SAC:与(3)类似,但在计算Q-target和损失时执行数据增强,(5)FERM:使用数据增强的SAC和对比学习的结合。此外,我们还提供了SAC的变体SACfD,它将辅助的L2损失应用到行动者网络的专家动作上。SACfD还可以与(2)、(3)和(4)结合使用,形成等变SACfD、RAD SACfD、DrQ SACfD和FERM SACfD。
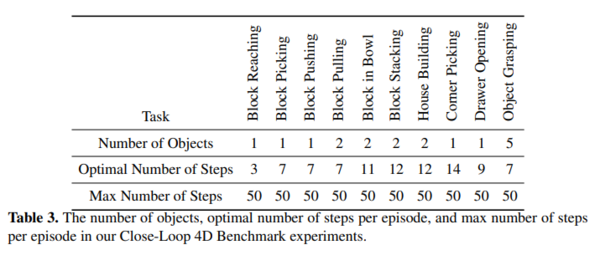
表 3:我们的闭环 4D 基准实验中的对象数量、每集的最佳步数和每集的最大步数。
在本节中,我们展示了SACfD、Equi SACfD、使用优先级经验重放(PER)和数据增强(Equi SACfD + PER + Aug)和FERM SACfD的性能。我们使用一个连续动作空间,x, y, z∈(−0.05米,0.05米)。我们在图9所示的10个环境中评估各种方法。表3显示了对象的数量,解决每个任务的最佳步骤数,以及每个章节的最大步骤数。在所有任务中,我们在回放缓冲区中预加载100集专家演示。
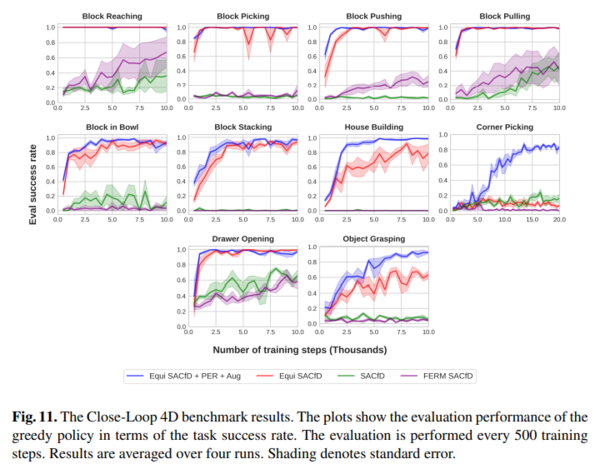
图 11:闭环 4D 基准测试结果。这些图显示了贪婪策略在任务成功率方面的评估性能,每 500 个训练步骤执行一次评估,结果在四次运行中取平均值。阴影表示标准误差。
图11显示了基线的性能。具有PER和数据增强的等变SACfD(蓝色)具有最佳的综合性能,其次是标准的等变SACfD(红色)。与其他不编码旋转对称的算法如CNN SACfD和FERM SACfD相比,等变算法表现出了显著的改进。
6 结论
在这篇论文中,我们提出了BulletArm,这是一种针对机器人操作的新型基准和学习环境。通过在我们的基线算法旁边提供一些操作任务,我们希望鼓励新方法之间进行更直接的比较。这种通过直接比较的标准化一直是改进深度学习方法研究的关键方面,无论是计算机视觉还是强化学习。我们的目标是在可预见的将来维护和改进这个框架,随着时间的推移添加新的特性、任务和基线算法。我们希望在社区的帮助下,这个存储库将随着时间的推移而增长,以包含大量有趣的任务和最先进的基线算法。
