介绍
机器学习模型的泛化是指模型对新数据进行分类或预测的能力。当我们在数据集上训练一个模型时,如果该模型提供了训练集中没有的新数据,那么它可能会执行得很好。这样的模型是可泛化的。它不必作用于所有数据类型,但可以作用于类似的域或数据集。
两个模型可能分别从两个问题领域学习,并且在使用相同的变量和约束行为时独立学习。
最初,泛化是由于模型构建中的失误或仅仅是巧合造成的。在当今的模式中,这被认为是一种优势,应该加以最大化和控制。广义模型可以通过从头再训练一个新模型来节省生产成本。如果一个模型能够进行预测,那么这个模型就被开发得非常高效;能够预测另一个问题是任何人都想要的好处,使模型普遍化应该是每个工程师和研究人员都要考虑的事情。
什么是不可见数据?
了解什么是看不见的数据很重要。不可见的数据是模型中新添加的数据,而不是训练的一部分。模型在之前观察到的情况下表现得更好,为了获得更多的好处,我们应该尝试拥有能够在看不见的数据上执行的模型。
泛化的好处
有时,泛化可以是一个提高性能的过程。在深度学习中,模型可以分析和理解数据集中的模式,它们也容易过拟合。利用泛化技术,可以对这种过拟合进行管理,使模型不过于严格。它可以帮助深度学习预测以前从未见过的模式,泛化表示模型在训练集中经过训练后,如何对新数据做出正确的预测。
深度学习清楚地展示了使用泛化的好处,它成为一种复杂的能力,因为我们不想训练模型去填充图像,当我们带来一个不在狭窄记忆中的图像时,它就失败了。如果我们将图像放在公共集合之外,我们希望经过训练的模型能够做得很好。
100%的准确性可能意味着所有的图像都被很好地填充,把照片拿到外面,模型就会失效。一个好的模型应该能够处理更普遍的图片,泛化技术应保证深度学习模型的训练不存在过拟合。
各种方法可以分为以数据为中心和以模型为中心的泛化技术,它们确保对模型进行了训练,以概括验证数据集并从训练数据中查找模式。
模型泛化的要素
由于泛化是一个更大的优势,因此有必要在模型的设计周期中看到一些可能影响泛化的因素。
- 以算法/模型为中心的方法的本质
所有的模型都有不同的行为,它们处理数据的方式和优化性能的方式是不同的。决策树是非参数的,这使得它们容易过拟合。为了解决模型中的泛化问题,应该有意地考虑算法的性质。有时模型的表现具有很高的复杂性,当它们很复杂时,过拟合变得很容易。可以使用模型正则化创建一个平衡来实现泛化和避免过拟合。对于深度网络,通过减少权重或网络参数(即权重值)的数量来改变网络结构可以达到目的。
- 数据集的本质
另一边是用于训练的数据集。有时数据集过于统一,它们彼此之间几乎没有差别。自行车的数据集可能过于统一,以至于无法用来检测摩托车。为了实现一般化的机器学习模型,数据集应该包含多样性。应添加不同的可能样本,以提供较高的范围,这有助于用最好的泛化来训练模型。在训练过程中,我们可以使用交叉验证技术,例如K-fold,即使在以泛化为目标时,也需要看到我们的模型的意义。
模型的非泛化
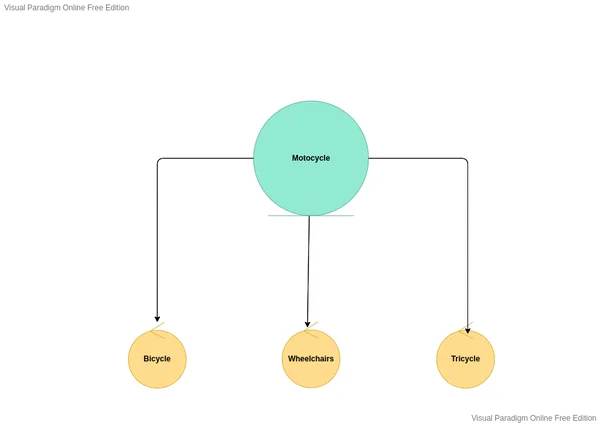
可见,模型不需要泛化。模型应该只做他们被严格期望做的事情,这可能是最好的,也可能不是。我可能希望我的模型训练摩托车的图像,以能够识别所有类似的车辆,包括自行车,甚至轮椅,这可能非常强大。在另一个应用程序中,这可能不是很好,我们可能希望用摩托车训练我们的模型来严格识别摩托车,它不应该识别自行车。也许我们要在没有自行车的停车场里数摩托车。
利用上述影响泛化的因素,我们可以决定和控制什么时候需要或不需要泛化,尽管泛化可能包含风险。因此,如果方法可用,非泛化应高度优化。如果有办法,应该开发一种新的自行车模型和另一种轮椅模型,在时间和数据集等资源较少的情况下,可以利用泛化技术。
模型的非泛化/泛化与过拟合
非泛化与过拟合条件关系最为密切。当一个模型不可泛化时,它可能与过拟合有关。如果过拟合得到解决,泛化就更容易实现。我们不想要过度装配的型号,一个已经学习了训练数据集而不知道其他任何东西的模型,它在训练数据集上执行,但在新的输入上表现不佳。另一个例子是欠拟合模型,这将是一个不理解问题的模型,在训练数据集上表现不佳,在新的输入上也不能执行。我们不想要这个。另一种情况是良好适应模式,这就像机器学习中的一个普通图。该模型适当地学习训练数据集,并将其泛化为新的输入。
当我们想要一个可以一般化的模型时,良好的拟合是我们需要的目标。
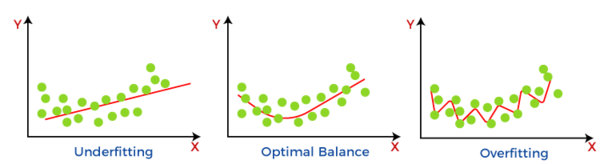
欠拟合、最佳模型和过拟合
偏差和方差对泛化的影响
影响模型推广的其他因素是方差和偏差。模型将分析数据,发现数据中的模式并做出预测。在训练过程中,它学习数据集中的模式,并在测试中使用它们来进行预测,并测量准确性。在预测过程中,预测值与实际值之间的差异称为偏差误差,高偏差模型不能进行泛化。
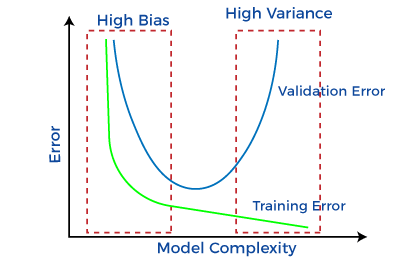
错误 v 模型复杂度
方差是指一个变量与它的期望值相差多少。我们做一个随机变量,并将其与我们期望的结果进行比较,预计模型的相对差异不会太大,模型应该能够理解输入和输出之间的隐藏映射。方差越低,预测误差越小,方差越大,对目标函数的预测误差越大。
显示高方差的模型不能对不可见的数据集进行泛化,这意味着在开发可以很好地泛化的模型时,方差水平必须处理得很低。
结论
我们已经深入了解了泛化的概念,它描述了模型对来自与模型初始数据集相同分布的新数据的响应。我们看到了相反的情况,即非泛化。数据集和算法是影响泛化能力的因素。我们发展了一种过度拟合的感觉,以及它与铁饼主题的关系。简单地说,方差是模型预测变化的能力,或者ML函数根据输入数据集可能变化的程度,具有许多特征和高度复杂性的模型是变化的来源。高偏差模型的方差最小。最后,具有低偏差的模型将具有高方差,这将无法泛化。
