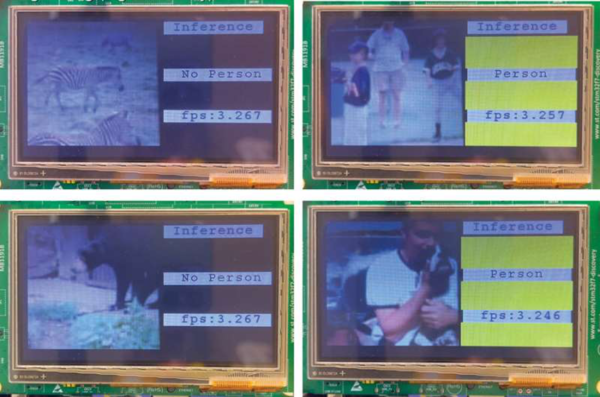
研究人员测试框架。通过训练计算机视觉模型检测图像中的人像,经过10分钟训练,设备成功完成了任务。
从IoT设备到汽车中的传感器,运行简单指令的MCU和小型计算机是几十亿联网设备的基础。但是,低价、低功率MCU的内存极其有限,而且没有操作系统,对于需要独立于中心计算资源来工作的边缘设备来说,训练人工智能(AI)模型将是一大挑战。
在智能边缘设备上训练机器学习模型,就是让其适应新数据,并做出更好的预测。例如,在智能键盘上训练模型,就是让键盘从用户输入中不断学习。然而,这个训练过程需要大量内存,通常先在数据中心的高能计算机上进行训练,然后将模型配置到设备上。
为解决这个问题,MIT研究人员研究出一种新方法,仅使用不到1/4M内存就能实现内置设备训练。而设计用于联网设备的其他训练方案占用内存高达500M,远远超出了大多数MCU的256K内存容量。
MIT团队开发的智能算法和框架减少了训练模型所需要的运算数量,使得训练过程更快,内存效率更高。用这些技术在MCU上训练机器学习模型,整个过程只需几分钟。
这项技术还具有隐私保护功能,数据则保留在设备上,这对医疗应用等敏感型数据非常有益。另外,这项技术也可用于定制基于用户需求的训练模型。
与其他训练方法相比,该框架保持或提高了训练模型的精度。作为TinyML计划的一部分,MIT团队之前曾提出在小型边缘设备上运行机器学习模型时存在的内存和计算瓶颈。
权重训练
最普通的机器学习模型就是大家熟悉的神经网络。这些模型与人脑之间是一种松散关联关系,包含多层的互联节点(或神经),可用来处理数据和完成任务,例如识别照片中的人像。这些模型必须经过训练,包括向其展示上百万案例,让其理解任务。按照所学到的,该模型会增加或降低神经之间的连接强度,这就是权重。
学习中,模型可能需要数百次升级,每一次升级的中间激活值(intermediate activation)必须保存下来。在神经网络中,这个激活值就是中心层的中间结果。相对一个已经训练就绪的模型,训练一个新模型要进行上百万权重和激活,需要占用大量内存。
为使训练过程更高效和占用较少内存,MIT团队采用了两种算法方案。
第一种是稀疏更新法(sparse update),每一轮训练中,该算法只更新非常重要的权重。训练时,算法开始依次冻结正在进行的权重,直到其精度下降到设定的阈值,然后停下来。这样,剩余权重更新了,与被冻结权重相关的激活过程不需要保存在内存中。
MIT团队表示,由于激活数量庞大,升级整个模型的代价非常昂贵,人们倾向于只升级最新层,但这会损伤精度。MIT方法是选择性的升级非常重要的权重,确保精度完整无损。
MIT团队采用的第二种方案涉及量化训练(quantized training)和权重简化,通常采用32位MCU。再用算法对权重进行整数取舍,通常只需8位,采用大家熟悉的量化处理,缩减用来训练和推理的内存数量。推理是将模型应用到数据集并产生预测的过程。接着,该算法采用一种量化感知训练(quantization-aware scaling, QAS)技术,这好比一个用来调节权重和变化率的比率的乘法器,可避免来自量化训练的任何精度损失。
MIT团队还开发了一个“微型训练引擎(tiny training engine)”系统,可在没有操作系统的简单MCU上运行这些算法的创新成果。该系统改变了训练过程的步骤和顺序,在将模型配置到边缘设备之前,很多工作可在汇编阶段完成。
MIT团队目前已经推出多种计算,例如自动区别和图像优化,并积极削减冗余操作以支持稀疏更新(sparse update)。一旦投入运行,这些设备的运行负荷将变得非常小。
实验结果
MIT团队实现的最佳结果是在157kB内存MCU上训练机器学习模型,而其他设计者提出的方法需要300M-600M内存。
该团队测试框架的方法是训练计算机视觉模型,让其检测图像中人像。仅仅经过10分钟训练,就能学会并成功完成任务。该方法训练模型的速度比其他方法快20倍。
目前,该团队已经成功演示了这些方法在计算机视觉模型方面的成功,并希望将来会应用到语言模型和不同类型的数据中,例如时间序列数据。同时,研究人员还希望通过所学到的,在不牺牲精度的前提下进一步缩减较大模型的尺度,这有助于减小训练大规模机器学习模型的碳足迹。
原文链接:
https://techxplore.com/news/2022-10-technique-enables-on-device-quarter-megabyte.html
---煤油灯科技victorlamp.com翻译整理---
