如今,数据科学被广泛用于创建数字孪生——这是现实世界物理系统或过程的数字对应物,可用于模拟、预测输入行为、监控、维护和规划等。虽然这样的数字孪生在日常应用程序中很常见,比如认知客户服务机器人,但在本文中,我们将比较用于建模两种不同类型的数字孪生的数据科学技术,并以行业中的实例进行说明。
本文讨论的两个用于数字孪生广泛使用的数据科学领域如下:
- (a)诊断和预测分析(Diagnostic and Predictive Analytics):给定一系列输入,数字孪生应该能够诊断出原因或预测系统的未来行为。基于物联网的机器学习模型用于创建智能机器和工厂,实时分析来自传感器的输入,以诊断、预测,从而在未来问题和故障发生之前预防它们。
- (b)规定性分析(Prescriptive Analytics):在给定一组需要遵守的变量和约束条件下,模拟整个网络,从大量候选方案中找出最优或可行的解决方案,通常以最大化既定的业务目标为目标,如吞吐量、利用率、输出等。这些优化问题被广泛用于供应链计划和调度,例如,当物流供应商为其资源(车辆、人员)创建一个计划,以最大限度地准时交货或制造商创建一个计划,以优化利用机器和操作员,以实现最大的OTIF交货。这里使用的数据科学技术是约束数学优化,使用强大的求解器来解决复杂的决策驱动问题。
综上所述,ML模型根据历史记录预测给定输入特征集的可能结果,优化模型帮助您决定如果预测结果发生,您应该如何计划解决/减轻/利用它,考虑到业务有几个可能相互竞争的目标,您可以选择使用您所支配的有限资源来实现这些目标。
数据科学的这两个领域虽然共享一些工具,如Python库,但部署的数据科学家具有完全不同的技能集,通常需要不同的思考和建模业务问题的方法。因此,让我们试着理解和比较所涉及的方法,以便在一个领域有经验的数据科学家能够理解,交叉利用可能适用于另一个领域的技能和技术。
数字孪生模型应用案例
为了进行这一比较,让我们考虑一个基于ML的生产根本原因分析(RCA)过程的孪生过程,其目的是诊断在成品或制造过程中发现的缺陷或异常的根本原因。这将帮助生产线经理根据工具的预测来排除最可能的根本原因,明确地识别问题并实施CAPA(纠正和预防措施),快速且不需要花费大量的人力去查看所有机器维护记录、操作员历史、流程sop、物联网传感器的输入等。目标是尽量减少停机时间、生产损失和提高资源利用率。
从技术上讲,这可以被认为是一个多类分类问题,在给定缺陷的情况下,模型试图预测一组可能的根本原因标签中的每一个的概率,比如与机器相关的、与操作员相关的、与工艺说明相关的、与原材料相关的或其他东西,在这些第1级类别中,还有诸如机器校准、机器维护、操作员技能、操作员培训等颗粒原因。尽管这种情况的最优解决方案需要对几个复杂的ML模型进行评估,但出于本文的目的,让我们假设这是一个多项逻辑回归问题(原因将在下一节中说明)。
为了进行比较,考虑生产计划过程的优化孪生过程,它生成一个进度表,在给定机器、操作人员、工艺步骤、持续时间、原材料到达计划、有效期等情况下,试图最大化产出或收入等目标。这样的自动化时间表有助于组织快速调整其资源,以应对来自市场的新机会(如COVID-19引起的药品需求),或通过改变其原材料、供应商、物流供应商和客户/市场组合组合,最大限度地减少不可预见事件的影响,如最近的供应链瓶颈。
在对任何业务问题建模的基本层面上,开发这种数字孪生有以下因素:
- A.输入特征或尺寸
- B.输入数据——这些维度的值
- C.输入到输出的转换规则
- D.输出或目标
让我们在ML和约束优化模型中更深入地分析和比较这些因素:
A.输入特征:这是系统中的数据维度,包括ML和优化。对于试图诊断生产过程中的问题的ML模型,要考虑的特征可以是物联网输入、机器维护历史、操作员技能和培训、原材料质量、遵循的SOP等。
类似地,在约束优化中,设备可用性、操作人员可用性、原材料可用性、工作时间、生产力、技能都是制定最优生产计划所需的典型特征
B.输入数据:这是两种方法以显著不同的方式使用特征值的地方。ML模型需要大量的历史数据进行训练,然而,在将数据提供给模型之前,通常需要进行与数据准备、管理和规范化相关的大量工作。需要注意的是,历史记录是实际发生的事件的记录(例如,机器故障,或导致输出不足的操作员技能问题),但通常不是这些特性所能接受的所有可能值的组合。换句话说,事务历史记录包含更多的频繁发生的场景记录,较少的其他场景记录,很少的很少发生的场景记录。训练模型的目标是,它应该能够学习特征和输出标签之间的关系,并预测准确的标签,即使是对训练数据中很少或不存在的特征值或组合。
另一方面,对于优化,特征值通常保留为它们的实际值,例如,天数,批次,截止日期,按日期的原材料可用性,维护计划,机器的更换时间,工艺步骤,操作员技能等。与ML模型的关键区别在于,输入数据处理需要生成主数据特征值的每一个可能的有效组合(例如;天数、技能、机器、操作员、工艺类型),变成索引表,可以形成一个可行的解决方案的一部分。例如,流程的第1步由技能水平为S1的操作员A在每周的第1天使用机器M1执行,或者第1步由技能水平为S2的操作员B在第2天使用机器M1执行。如此类推,对于操作员、机器、技能水平、天数等每一种可能的组合,都不考虑这些组合是否在过去实际发生过。这将导致提供给优化引擎的非常大的输入数据记录集。优化模型的目标是选择符合规定约束的特征值的特定组合,同时最大化(或最小化)一个目标方程。
C.输入到输出的转换规则:这也是两种方法的显著区别所在。虽然ML和优化模型都基于高等数学,但与ML相比,在优化中充分地对复杂的业务问题进行数学建模和编程通常需要付出更多的努力,这将在以下部分中得到证明。
原因是在ML中,使用像scikit-learn这样的库、Pytorch或Tensorflow这样的框架或任何云提供商的ML/深度学习模型,将输入转换为输出的规则留给模型去寻找,包括损失校正来派生最优规则(权重、偏差、激活函数等),数据科学家的主要责任是确保输入特征及其值的质量和完整性。
但在优化中,关于输入如何相互作用并转化为输出的规则必须使用详细的方程来编写,然后将其提供给Gurobi、CPLEX等求解者以找到最优或可行的解决方案。此外,将业务问题表述为数学方程需要对被建模过程中的相互关系有深入的领域知识,并需要数据科学家与业务分析师密切合作。
让我们用下面的问题RCA应用逻辑回归模型图来说明这一点:
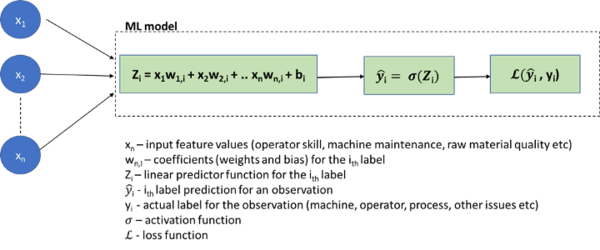
逻辑回归ML模型
注意,在这种情况下,从输入生成结果(Zᵢ)的规则留给模型来推导,而数据科学家通常忙于使用定义良好的混淆矩阵、RMSE等度量来可视化预测精度。
将此与优化生成生产计划的方式进行对比:
(1)第一步是定义封装规划过程的业务规则(约束)。
以下是生产计划示例:
首先,我们定义一些输入变量(其中一些可以是决策变量,用于驱动目标):
Bᵦ,p,ᵢ——二进制变量,表示产品p(产品表中)的批次β(批次表中)是否安排在第i天。
Oₒ,p,ᵢ——二进制变量,表示索引o处的运算符(在运算符表中)是否计划在第i天处理一批产品p。
Mm,p,ᵢ——二进制变量,表示索引为m的机器(在机器表中)是否计划在第i天处理一批产品p。
以及一些系数:
TOₒ,p——操作员o处理一批产品p所花费的时间。
TMm,p——机器m处理一批产品p所花费的时间。
OAvₒ,ᵢ——运营商在第i天索引o的可用小时数。
MAvm,ᵢ——第i天索引为m的机器可用小时数。
在这种情况下,一些约束(规则)可以使用如下方式来实现:
(a)在计划中,特定批次只能启动一次。
其中,对于每批产品,Bt是批次总数,Pr是产品总数,D是计划中的天数:
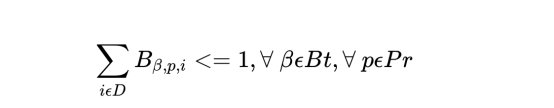
(b)一个产品每天只能在一个操作员或机器上启动一次。
对于每个产品的每一天,其中Op是所有操作员的集合,Mc是所有机器的集合:
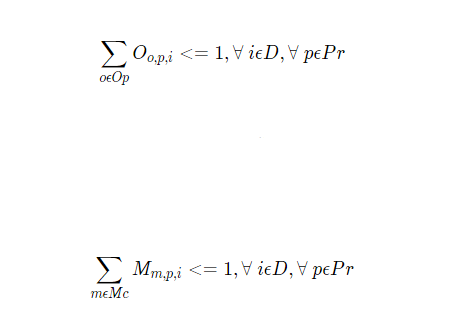
(c)批次(所有产品)花费的总时间不应超过当天操作员和机器的可用小时数。
对于每个操作员而言,存在如下约束:
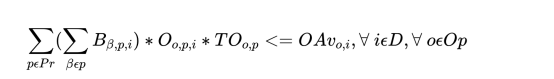
对于每台机器的每一天而言,存在如下约束:
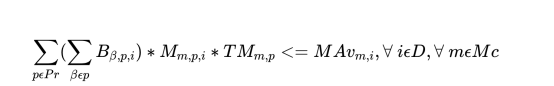
(d)如果操作员在计划的前5天内处理一批产品,则必须将同一产品的所有其他批次分配给同一操作员。这可以保持运营商的连续性和生产力。
对于每个操作员和每个产品,每天d(从第6天起)存在如下约束:
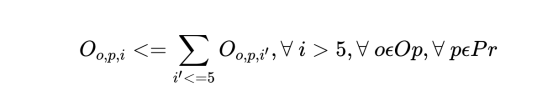
为了将实际生产调度场景的业务规则表述为数学方程,需要在程序中编写数百个约束,上述约束只是其中的一小部分。注意,这些约束是线性方程(或者更具体地说,混合整数方程)。然而,与Logistic回归ML模型的复杂性差异明显。
(ii) 一旦定义了约束条件,就需要定义输出目标。这是一个至关重要的步骤,可能是一个复杂的过程,下一节将对此进行解释。
(iii) 最后,将输入决策变量、约束条件和目标发送给求解器,得到一个解决方案。
描述基于优化的数字孪生的图如下:
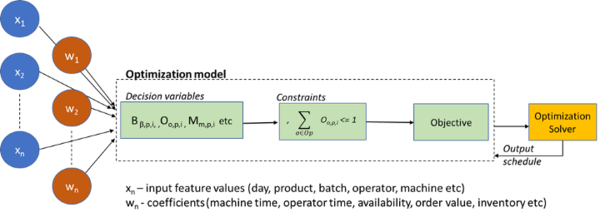
优化模型
D.产出或目标
对于ML模型,基于问题的类型(分类、回归、聚类),输出和度量其准确性的指标已经建立得相当好。尽管我们不会在本文中深入讨论这些问题,但鉴于现有的大量信息,值得注意的是,有一个高水平的自动化可用来评估各种模型的输出,例如那些由领先的CSP (AWS Sagemaker, Azure ML等)提供的模型。
评估优化模型是否生成正确的输出更具挑战性。优化模型通过尝试最大化或最小化一个被称为Objective的计算表达式来工作,与“约束”一样,“目标”留给数据科学家根据业务试图实现的目标进行设计。这是通过将奖励和惩罚附加到决策变量,优化器试图最大化它们的总和来实现的。对于现实世界的问题,需要多次迭代才能找到不同目标的正确权重,以便在有时矛盾的目标之间找到良好的平衡。
为了说明生产调度的例子,两个这样的目标可以是:
(a)时间表应预先加载;应尽快安排批次,计划中剩余的产能应在计划的末尾。为此,我们可以为一个批次附加一天罚款,该批次在计划中的每一天都会逐渐增加。
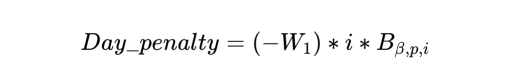
(b)另一方面,我们还希望对同一产品的批次进行分组,以便资源(操作员和机器)得到最佳利用,前提是批次满足交货期限,并且分组不超过一次运行的机器容量。因此,我们定义了一个Batch_group_bonus,它提供了一个显著更高的奖金(因此在下面表达式中的指数),如果分批调度的组比小的组大。需要注意的是,这有时会与之前的目标背道而驰,因为一些本可以在今天启动的批次可能会与几天后可用的更多批次一起启动,可能会将一些未充分利用的资源放在日程安排的更早。
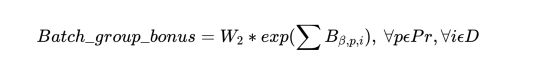
由于求解器的工作方式,实际的实现将需要一个批处理组决策变量,但这传达了如下概念:
求解器将最大化目标= Batch_group_bonus + Day_penalty
目标的上述两个组成部分中,哪一个对附表某一天的影响更大取决于权重W₁、W₂以及附表当天,因为日罚款将在附表后面部分逐渐变大(i值更高)。如果在某一点上,天数惩罚大于Batch_group_bonus,求解器将发现不调度批处理是谨慎的,因此,调度的惩罚为零,并产生净负惩罚,从而最大化目标,即使调度中还有剩余的资源容量,这些问题需要数据科学家进行故障排除和解决。
ML与优化项目的相对工作量
根据上面的讨论,可以推测,一般来说,优化项目比ML项目花费更多的精力。在开发过程的几乎每个阶段,优化都需要大量的数据科学工作。总结:
(a)输入数据处理:在ML和优化中,这都是由数据科学家完成的。ML数据处理需要选择相关特征、标准化、离散化等。对于文本等非结构化数据,可以包括基于NLP的方法,如特征提取、标记化等。在许多语言中都有大量的库可用于特征的统计分析以及降维方法(如PCA)。
在最优化中,每个业务和进度都有细微差别,需要将这些细微差别带入模型中。优化问题不处理历史数据,而是将每一个可能的数据变化和已识别特征的组合制定为决策变量和约束必须基于的索引。虽然与ML不同,但数据处理需要大量的开发工作。
(b)模型开发:如上所述,优化模型的制定需要数据科学家和业务分析师付出大量努力来制定约束条件和目标。该求解器运行数学算法,虽然它的任务是同时求解数百个,甚至数千个方程,以找到一个解决方案,但它没有业务背景。
在ML中,模型训练是高度自动化的,算法被打包成开源库API,或者云服务提供商提供的API。高度复杂的、预先训练过的神经网络模型基于特定于业务的数据,将训练任务简化到仅最后几层。AWS Sagemaker Autopilot或Azure AutoML等工具甚至自动化了输入数据处理、特征选择、不同模型的训练和评估以及输出生成的整个过程。
(c)测试和输出处理:在ML中,可以用最小的处理利用模型的输出。它通常是很容易解释的(例如,作为不同标签的概率),尽管可能需要一些努力来引入其他方面,如结果的可解释性。输出和错误可视化可能也需要一些努力,但这些与输入处理相比并不多。
在这里,优化问题也需要经过训练的计划专家进行迭代的手动测试和验证,以评估进度。虽然求解者试图最大化目标,但从进度质量的角度来看,目标本身通常没有什么意义。与ML不同,不能说目标值高于或低于阈值包含正确或不正确的进度。当发现计划没有满足业务目标时,问题可能与约束、决策变量或目标函数有关,需要仔细分析以找到大型复杂计划中异常的原因。
此外,还需要考虑将求解器的输出解释为人类可读格式所需的开发。求解器输入决策变量,这些决策变量是调度中实际物理实体的索引值,例如,批处理组索引、批处理优先级索引、操作员和机器索引,并返回已选中的决策变量。需要进行反向处理,将这些来自各自数据帧的索引值转换为一个一致的时间表,以便由专家可视化地表示和分析
(d)最后,即使在操作阶段,与训练阶段相比,ML模型生成观测预测所需的计算和时间也要少得多。然而,调度是每次从零开始构建的,每次运行都需要相同的资源。
下图是ML和优化项目按阶段相对工作量的粗略说明:
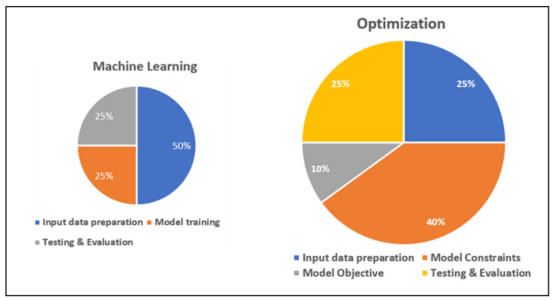
ML与优化相对工作量比较示意图
ML和优化可以协同工作吗?
机器学习和优化为企业解决互补的问题,因此它们共存,ML模型的输出为优化提供支持,反之亦然。AI/ML应用如物联网支持预测性维护和故障检测,AR/VR远程维护和这里提到的生产过程RCA是制造商连接工厂战略的一部分。
优化应用形成了供应链规划的基础,可以认为是连接业务战略和运营。它们帮助组织响应和计划不可预见的事件。例如,如果在一条线路中检测到一个问题,RCA工具将帮助线路管理人员快速缩小可能的原因并实施必要的操作。然而,这有时可能导致计划外的机器停机或操作人员重新分配。因此,可能需要用可用的减少的产能重新制定生产计划。
ML中的某些技术可以应用于优化吗?反之亦然。
从ML项目中学习到的知识可以应用到优化中,反之亦然。例如,对于优化输出至关重要的目标函数有时并没有像约束(约束是必须遵守的规则,因此通常是众所周知的)那样被业务定义为数学建模。为了说明这一点,业务目标可以如下:
(a)应在保证交货期限的前提下,按优先顺序尽可能早地安排批次
(b)进度表应前置式;在尽可能少的缺口和资源利用不足的情况下
(c)批次应分组,以有效利用能力
(d)对高价值产品具有较高技能水平的操作人员最好分配这样的批次。
其中一些可能是需要适当平衡的竞争优先级,这导致数据科学家编写影响因素(奖金和惩罚)的复杂组合,通常通过试错,这似乎适用于最常见的规划场景,但有时很难在逻辑上理解和维护缺陷。由于Optimization Solver是一个第三方产品,其代码对于构建模型进行调试的数据科学家来说是不可用的,因此不可能看到某些奖金和惩罚在计划生成期间的任何特定点上的值是什么,这使得编写令人满意的Objective表达式非常重要。
因此,它有助于采用奖金和罚款的规范化,这是一种广泛使用的ML实践。然后,可以使用配置参数或其他方式以受控的方式对规范化值进行缩放,以控制每个因素的影响、它们之间的关系以及它们与每个因素中前面和后面的值之间的关系。
结论
机器学习和优化都是高度数学化的方法,可以解决组织和我们日常生活中不同的问题,它们用于部署物理设备、流程或网络的数字孪生。虽然这两种类型的应用程序遵循类似的高级开发阶段,但ML项目可以利用库和云原生算法中可用的高级自动化,而优化则需要业务和数据科学家的密切合作,以充分建模复杂的规划过程。一般来说,优化项目需要更多的开发工作,而且资源密集。ML和优化工具在企业中协同工作,这两种技术对数据科学家来说都很有用。
---煤油灯科技victorlamp.com翻译整理---
