“如果技术的直接目的是减少稀缺性,那么技术的最终目的是消除死亡率。”——Balaji S. Srinivasan
每当科技公司推出新产品时,他们都会将其描述为具有更高的密度和更高的效率。这意味着为更多人提供更实惠的产品,从而减少稀缺性。我们拥有的最稀缺的资源是时间,它受生物学支配。作为技术建设文明,我们的共同命运是重新设计我们自己的生物学,通过延长我们自己的寿命来减少时间的稀缺。我们应该怎么做?
所有现代技术的 3 个基本组成部分是字节、原子和基因。所有数字信息的基本单位是字节。所有物质的基本单位是原子。而所有生物学的基本单位是基因。我们在基于这三个基本现实构建块创建产品方面取得了巨大的进步;从火箭到晶体管,再到 DNA 测序硬件,而它们的融合将帮助我们延长寿命。
就像加密货币运动拒绝了遗留金融系统的基本前提,即只有政府印刷的货币才有价值一样,日益增长的寿命发展拒绝了遗留医疗系统的基本前提。也就是说,逆转衰老过程是不可能的,这将整个生物医学技术堆栈分支到一个新的方向。这个新的技术堆栈将包含 4 种指数技术的融合;深度学习、多组学、区块链和量子计算。让我们逐一介绍吧!
1.深度学习
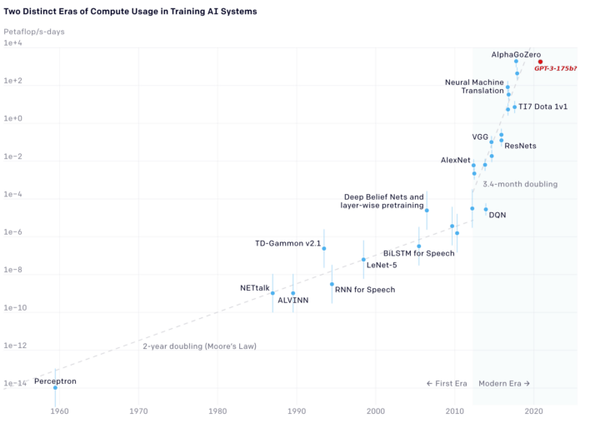
令人震惊的是,深度学习在做出比其他机器学习技术好得多的预测方面仍然做得更好。“更多计算”的假设仍然没有已知的上限。我们为语言模型、图像分类器和视频生成器提供的计算和高质量数据越多,它们的准确性就越高。深度学习是一种新的计算范式,我们不再给机器规则,而是让它们学习规则。这是我们在自动系统方面取得的进步的指数级变化,从特斯拉这样的自动驾驶汽车到帮助心理健康患者的聊天机器人,再到立即为您提供最相关结果的搜索引擎。生物数据可能过于复杂,无法发现任何人类或人类群体的未知模式,无论他们拥有多少领域知识。
但是深度学习可以发现这些模式比任何人类都可能发现的更高维度,它可以解释仅存在于 1000 多维空间中的关系。这些深度学习模型将帮助我们取代目前过时的医疗保健状况,即每年就诊。我们不会在出现症状时进行测试,而是让这些模型不断监测来自智能健康传感器的生物标志物形式的多种分析物,即多组学数据。他们将能够预测生活方式建议以在疾病发生之前预防疾病,从而最大限度地延长我们的寿命。这些深度学习模型将帮助我们取代目前过时的医疗保健状况,即每年就诊。我们不会在出现症状时进行测试,而是让这些模型不断监测来自智能健康传感器的生物标志物形式的多种分析物,即多组学数据。他们将能够预测生活方式建议以在疾病发生之前预防疾病,从而最大限度地延长我们的寿命。
这些深度学习模型将帮助我们取代目前过时的医疗保健状况,即每年就诊。我们不会在出现症状时进行测试,而是让这些模型不断监测来自智能健康传感器的生物标志物形式的多种分析物,即多组学数据。他们将能够预测生活方式建议以在疾病发生之前预防疾病,从而最大限度地延长我们的寿命。
2.多组学

“组学”是一个分子术语,指的是对一组分子的研究。在过去的几十年里,我们看到了硬件和软件方面令人难以置信的进步,这些进步使医学研究人员能够在最小的尺度上研究人类健康,在微小的分子水平上。更强大、更实惠的显微镜、测序技术和计算能力已经产生了数 PB (约10.7亿MB)的数据。
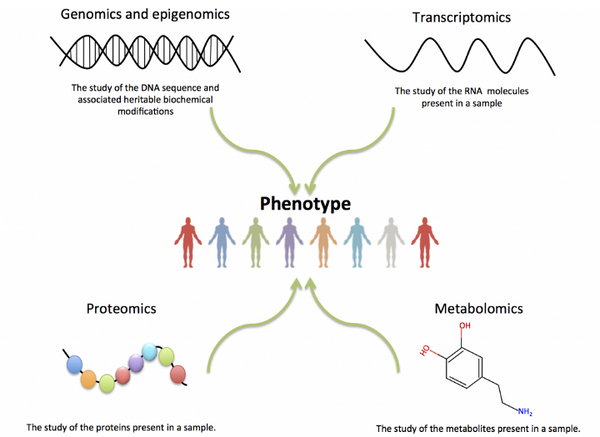
基因组学是第一个出现的学科,它是对整个基因组(也称为 DNA)的研究。我们都是基因组生物,我们 700 兆字节的源代码由一个由 As、Cs、Ts 和 Gs 组成的 30 亿个字母字符串组成。我们都是由这种生物学编程语言产生的个性特征、身体能力、精神毅力和饮食习惯的独特组合。它的原语是 4 个字母而不是 1 和 0。这些原语结合起来会产生由化学信使执行的功能,通过蛋白质和脂质等巨大、高度复杂的结构传递信息。
由于某些基因由于年龄或暴露于环境因素而开启或关闭,这些 DNA 序列发生变化的方式会导致一系列有趣的活动。这些被称为表观遗传变化,其研究被称为表观基因组学。
但是,虽然 DNA 拥有数据,但它并不适用于特定的任务。为了提取数据,将其作为信息发送到正确的位置,比如制造蛋白质,DNA 被转录成称为 RNA 的信使分子。对所有这些 RNA 转录本或翻译的总和的研究称为转录组学。
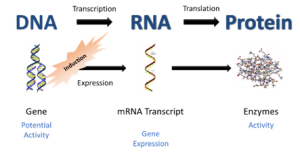
从这些过程中产生的成千上万的蛋白质分别负责身体中的数千个关键任务。对这些蛋白质如何产生、降解和表达的研究称为蛋白质组学。
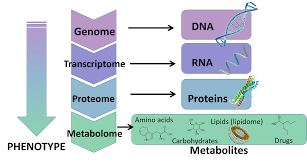
蛋白质降解成一组称为代谢物的分子,包括碳水化合物和脂质。这是基因转录的最终下游结果,它代表了生物系统的当前状态,对这些的研究称为代谢组学。
现代医学的挑战是将所有这些数据整合成一幅完整的健康图景,称为多组学分析。在计算机科学术语中,基因组是硬盘,它存储数据。表观基因组是磁盘读取器。转录组是解释者。代谢组是过程监控器,蛋白质组是应用程序。
衰老是信息的丢失。随着时间的推移,硬盘,基因组,被划伤。通过研究所有组学层,我们可以更准确地了解信息的流动,并最终学习如何保存和恢复这些信息,有效地逆转老化过程。
我们可以使用不同类型的神经网络架构来对所有这些基础数据进行预测。通过分析不同组学提供的级联信息来发现分子生物标志物。生物标志物在为患者规划预防措施和决策方面发挥着重要作用,可分为诊断性、预后性或预测性。诊断性生物标志物用于确定患者是否存在疾病,而预后性生物标志物可提供有关使用或不使用标准治疗的总体结果的信息。预测性生物标志物用于识别谁有结果风险。 所有这些生物标志物也可用于确定哪种治疗最适合特定患者。
不幸的是,大多数多组学数据目前由少数组织私人持有。但我们看到越来越多的匿名开源组学数据集可供使用。其原因是区块链。
3.区块链
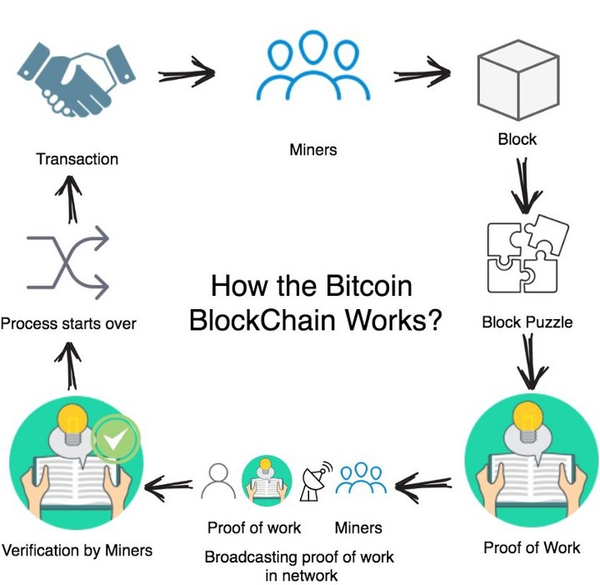
区块链是不可变的公共真相来源,从 13 年前世界上第一个加密货币比特币开始。中国最近关闭了几乎所有的比特币挖矿设施,但网络仍然存在。那是因为它是一个数字有机体,比所有人类都强大。它需要的计算能力比世界上 500 台最快的超级计算机摧毁比特币网络的总和还要多。这是因为它使用所谓的工作量证明算法让节点解决随机生成的数学问题。这个共识层是同类中的第一个,通过区块链技术的发展,我们将开始创建没有中心故障点并自由共享数据集并由社区管理的新组织。
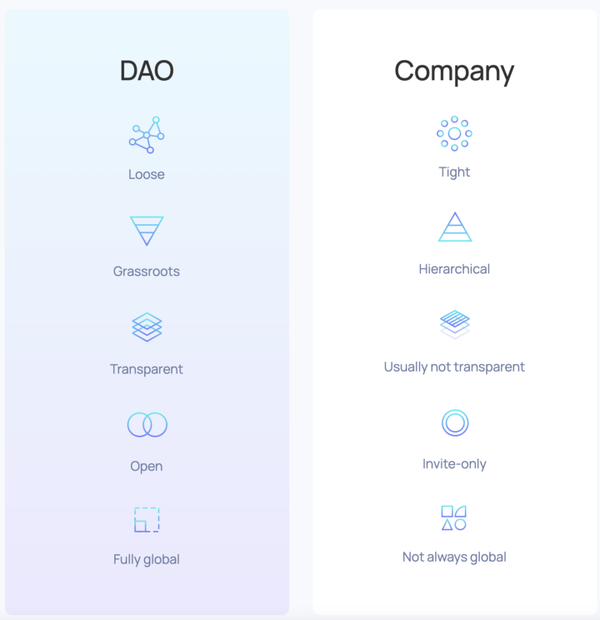
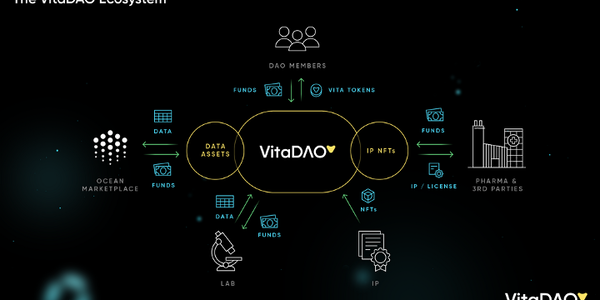
一个很好的例子是 VitaDAO,一个为早期长寿研究提供资金的去中心化集体。VitaDAO 的所有研究、交易和数据都是公开的。通过使用它的原生代币,成员可以加入、对提案进行投票,并以开源方式访问它的所有信息。我们将开始看到越来越多以健康为重点的 DAO,它们公开发布更多组学数据集并通过区块链确保所有权。但是,如果我们真的想逆转衰老过程,仅来自组学数据集的深度学习模型的生活方式建议是不够的。我们将需要能够在分子水平上针对和逆转与年龄相关的衰退的药物。为了做到这一点,我们需要将药物发现过程加快几个数量级。如何?答案在于量子计算。
4.量子计算
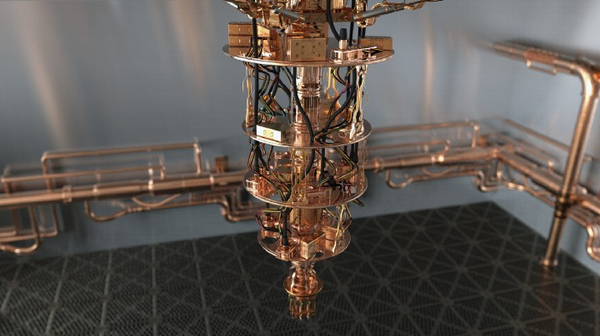
目前,中国、美国、加拿大已经实现了量子计算的优越性,这证明存在一个量子计算机优于经典计算机的单一任务。量子领域的竞赛还在继续,数亿美元投入到这些机器的研发中,这些机器有可能以指数级更快的速度超越任何传统计算机。利用量子力学,即上世纪才发现的叠加和纠缠的概念,这些机器能够以前所未有的方式重新排列物质和信息。量子计算可以成倍地提高深度学习的准确性,围绕这一点,一个新的领域正在兴起,即量子深度学习。这些量子模型不仅有望能够提高预防性建议和诊断的准确性,而且能够帮助发现全新的长寿药物。
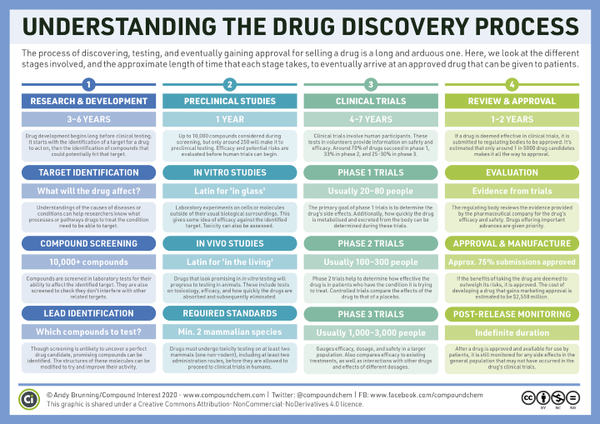
药物发现是一个长达十年的过程,需要超过 10 亿美元才能将一种药物推向市场。如果量子计算机运行得足够好,我们也许可以完全在计算机上模拟生化反应,准确地模拟量子力学,就像它在我们的现实中发挥作用一样。我们不仅可以发现新药,而且可以在计算机上而不是在湿实验室中进行测试。随着药物开发的设计和测试阶段的这种数量级的改进,我们可以比以往更快地创造出更多的新药。‘’
---煤油灯科技victorlamp.com翻译整理---
