摘要
1. 为了评估矩阵求逆方法的相对有效性,对计算的逆矩阵中的误差有一个先验界限是有用的。本文确定了一些最有效的直接方法的误差范围。为了充分说明我们所使用的技术,我们对浮点计算和定点计算分别进行了一些分析。在所有情况下,都假定计算是使用 个二进制位的精度执行,但应该了解,在同时具有固定和浮点设备的计算机上,定点数中允许的位数要大于浮点数尾数的位数。用于分析浮点计算的技术本质上是[8]中的技术,并且假设读者已经熟悉该论文。
2. 用向量范数和矩阵范数来表示误差界是最方便的,除了明确指出相反的情况外,我们自始至终都使用欧几里得向量范数和谱矩阵范数。 为方便起见,在第9节中给出了这些规范的主要性质。
在最近的一篇论文中,我们分析了在求解方程时产生的舍入误差的影响
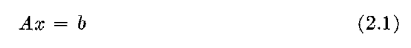
通过高斯消元法与“尺寸旋转”。我们证明了计算出的解是

我们可以得到 和 的范围,前提是对连续简化矩阵的最大元素与AA 的最大元素之比做了假设。本文讨论的所有方法都依赖于将原始矩阵A(1)A^{\left(1\right)} 转化为矩阵A(2),A(3),⋅⋅⋅,A^{\left(2\right)},A^{\left(3\right)},\cdot\cdot\cdot,A(k)A^{\left(k\right)} 的连续变换,使得每个A(3)A^{\left(3\right)} 等价于A(1)A^{\left(1\right)} ,最终A(k)A^{\left(k\right)} 是三角形。在任何方法的先验分析中,一个基本要求是对数量rr 有一个界限,定义为
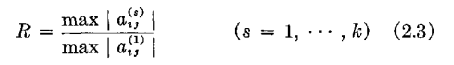
对于基于高斯消元的方法,只有在每个阶段使用尺寸旋转时,我们才能够获得一般非对称矩阵的合理上限。这个界限远不是明确的,但至少导致了一个有用的结果,并且证明了限制RR 大小的因素。对于一些在实践中很重要的矩阵类,给出了RR 的一个更小的界限,并且这个界限即使在采用有限形式的大小旋转时仍然成立。最后,我们证明了对于正定矩阵R≦1R\leqq1 ,即使交换“尺寸旋转”也可以。
为了与这种高斯类型的方法进行比较,我们对基于通过正交矩阵的等效变换将AA 简化为三角形的方法进行了分析。对于这些,很容易证明对于任何矩阵R<nR<\sqrt{n} ,这样大小的控制就得到了保证。由于对RR 大小的限制,一般矩阵的正交约简得到的误差范围小于消除方法得到的误差范围。 然而,正交约简比消除需要更多的计算,并且由于在实践中RR 的值远远低于我们获得的界限,因此我们认为使用正交变换很少,如果有的话,是合理的。
3. 我们并不声称我们给出的先验界限在任何方面都是“最好的”,并且在许多情况下,我们知道它们可以通过更详细的论证而有所减少。 然而,我们认为错误分析的本质简单性可能会被过多的细节所掩盖。 在任何情况下,界限都不考虑统计效应,在实践中,这总是通过一个比详细阐述论点所能达到的更为重要的因素来减少真实误差。我们还提出了一些论点,这些论点部分解释了为什么在实践中计算的逆运算比预期的要准确得多,即使考虑到统计效应也是如此。
误差的所有先验界限都明确包含因子∥A−1∥\lVert A^{-1}\rVert 。这意味着在得到计算的逆之前,我们几乎不可能利用这些结果。 分析的性质使得如何使用计算的逆来获得其误差的后验上限变得很明显,但结果的主要价值是表明给定方法在计算中给定精度的适用范围, 因此应根据这一点进行判断。
高斯消元法中RR 的上限
4.当一般矩阵通过高斯消元法简化为三角形时,我们首先推导出RR 的上限,在每个阶段选择整个剩余方阵中最大模数的元素作为关键元素。 我们将此称为“完全”旋转尺寸,而不是在每个阶段选择前导列中的最大元素,我们称之为“部分”旋转尺寸。
用A(n)A^{\left(n\right)} 表示原始矩阵,用A(n−1),A(n−2),…,A(1)A^{\left(n-1\right)},A^{\left(n-2\right)},\ldots,A^{\left(1\right)} 表示简化矩阵(使A(x)A^{\left(x\right)} 是rr 阶矩阵),用prp_r 表示A(r)A^{\left(r\right)} 的关键元素的模,使得
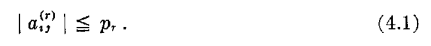
然后我们得到

另一方面,Hadamard 定理给出了
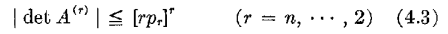
因为A(r)A^{\left(r\right)} 的每一列的长度都以r½prr^½p_r 为界。 我们写作
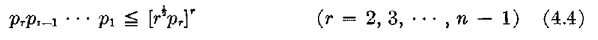
但保留
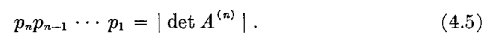
取关系式 (4.4) 和 (4.5) 的对数并写作

我们得到
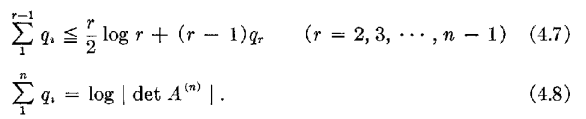
当r=2,3,⋅⋅⋅n−1r=2,3,\cdot\cdot\cdot n-1 时,将( 4.7 )除以r(r−1)r\left(r-1\right) ,( 4.8 )再除以(n−1)\left(n-1\right) ,观察到
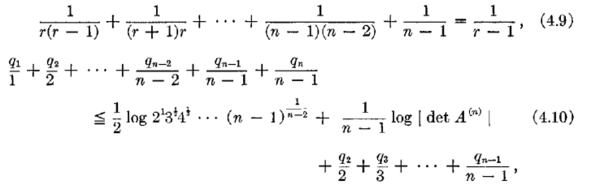
给出
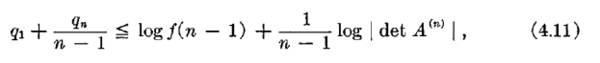
其中
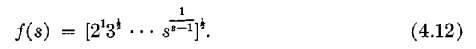
将∣detA(n)∣\lvert\det A^{\left(n\right)}\rvert 代入(4.3)(其中r=nr=n )得到
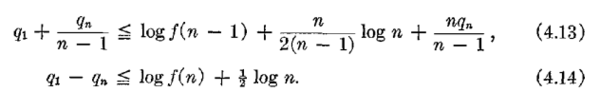
因此
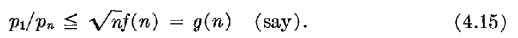
这给出了最后一个基准值与第一个基准值之比的上限。特别是,如果pn≦1p_n\leqq1 ,则p1≦g(n)p_1\leqq g(n) 。
另一方面,如果我们写
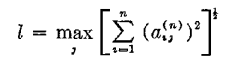
因此,A(n)A^{\left(n\right)} 的所有列的长度都以ll 为界限,则
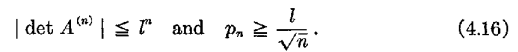
因此根据(4.11)
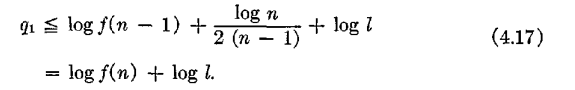
特别是当l≦1l\leqq1 时
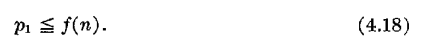
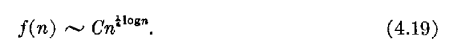
函数f(n)f(n) 和g(n)g(n) 的增长相对缓慢,这很容易证明
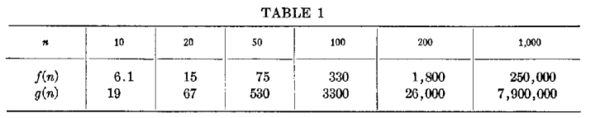
在表 1 中,我们给出了代表nn 值的f(n)f(n) 和g(n)g(n) 的值。
标准化的两种形式将在本文中使用,分别称为规范化(I)和规范化(II)。(4.15)和(4.18)对于任何以适当方式归一化的矩阵都成立,实际上它们的真实性决不依赖于(4.20)和(4.21)中的左侧不等式。然而,在我们看来,只有当原始矩阵的所有行和列都具有可比较的范数时,旋转尺寸才是合理的策略。
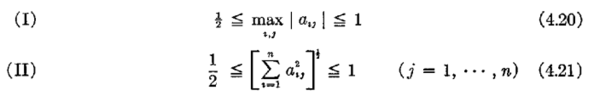
对于规范化 (I),这可以通过缩放所有行和列来实现,以便它们至少包含一个满足12≦aij∣<1{1\over 2}\leqq a_{ij}\rvert<1 的元素。对于规范化 (II),这之后应该对列进行额外的缩放,因此满足(4.21)。F. L. Bauer 建议将此类矩阵称为“平衡”矩阵。 在实践中,没有必要确保精确的平衡,而只是没有完全由“小”元素组成的行或列。 严格来说,在选择枢轴之前,应在还原的每个阶段进行平衡,但这些后来的平衡并不重要。
5. 不等式 (4.15) 肯定不有效。 因为只有当 (4.4) 中的等式对所有rr 都成立时,等式才能成立。 如果这是真的,我们可以证明,正如我们对r=nr=n 所做的那样,那么
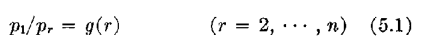
因此
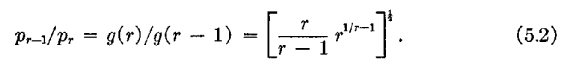
除了小rr 之外,这个比值仅略大于1。这意味着关键序列pn,pn−1,⋅⋅⋅p_n,p_{n-1},\cdot\cdot\cdot 起初增长相当缓慢。现在,等式(4.4)只有在A(r)A^{\left(r\right)} 的所有元素都等于±pr\pm p_r 且所有列正交时才成立。对于某些rr 值,例如r=3r=3 ,这显然是不可能的。进一步,如果a(r)ij=±pra{\left(r\right)\atop ij}=\pm p_r ,则所有a(r−1)ija{\left(r-1\right)\atop ij} 为±2pr±2p_r 或为零。因此,如果在任何阶段等号在(4.4)中成立,那么pr−1/pr=2p_{r-1}/p_r=2 或A(r−1)A^{\left(r-1\right)} 都为空,在任何一种情况下(5.2)都无法满足。
这些考虑表明,支点的最小上限可能比我们给出的要小得多。根据我们的经验,最后一个主元远远低于给定的界限,并且在实践中还没有遇到pl/pnp_l/p_n 等于8的矩阵。请注意,我们肯定有

因为prp_r 是(n+1−r)\left(n+1-r\right) 阶矩阵的归约的最后一个支点,但如果plp_l 接近最大值,则初始增长率必须远低于对应于 (5.3) 的增长率 。
正定矩阵
6. 有一些特殊类型的矩阵,可以给出最大主元的更好界限,令人惊讶的是,这些矩阵都不需要完全的主元来确定大小。
最重要的一类是正定矩阵。 我们将证明,当一个正定矩阵通过高斯消元减少而没有任何大小的旋转时,任何减少的矩阵中的元素都不会超过原始矩阵中的最大元素。 现在可以方便地调用原始矩阵A(1)A^{\left(1\right)} 和简化矩阵A(2),A(3),⋅⋅⋅,A(20)A^{\left(2\right)},A^{\left(3\right)},\cdot\cdot\cdot,A^{\left(20\right)} 以使A(r)A^{\left(r\right)} 是有序的
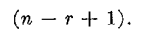
我们首先证明A(2)A^{\left(2\right)} 是正定的。
第一个约简中使用的乘数milm_{il} 定义为
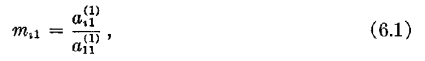
并且a(1)i1a{\left(1\right)\atop i1} 不为零,因为A(1)A^{\left(1\right)} 是正定的。 A(2)A^{\left(2\right)} 的元素由下式给出
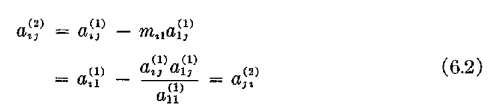
根据A(1)A^{\left(1\right)} 的对称性,我们得到
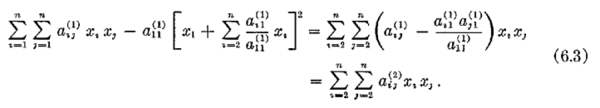
如果A(2)A^{\left(2\right)} 不是正定的,则存在x2,x3,…,xnx_2,x_3,\ldots,x_n 的非空集,使得∑aij(2)xixj≦0\sum\nolimits_{a_{ij}}^{\left(2\right)}x_ix_j\leqq0 。如果我们写
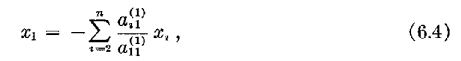
然后有了这个x1,x2,⋅⋅⋅xnx_1,x_2,\cdot\cdot\cdot x_n 我们得到
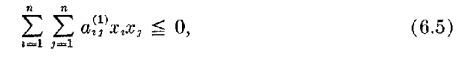
这是不可能的,因为A(1)A^{\left(1\right)} 是正定的。 我们还有进一步
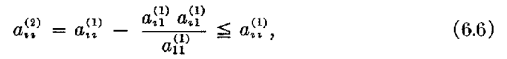
a(2)iia{\left(2\right)\atop ii} 是正的,因为A(2)A^{\left(2\right)} 是正定的。因此,A(2)A^{\left(2\right)} 的对角线项不大于A(1)A^{\left(1\right)} 的对角线项,因为正定矩阵的最大元素位于对角线上
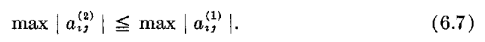
同样地,A(3)⋅⋅⋅A(n)A\left(3\right)\cdot\cdot\cdot A\left(n\right) 是正定的。 特别是如果∣a(1)ij≦1\lvert a{\left(1\right)\atop ij}\leqq1 (所有的i,ji,j ), 那么这对所有a(r)ija{\left(r\right)\atop ij} 都是正确的。
乘数可能很大,例如对于矩阵
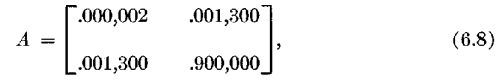
因此,高斯消元要么在浮点运算中执行,要么需要以类似于通常在反向替换中使用的方式引入比例因子。
三角分解
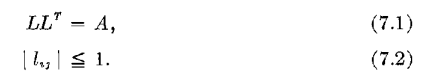
7. 对于正定对称矩阵的对称 Cholesky 分解,我们可以证明一个更令人满意的结果。 我们证明如果AA 是正定的并且∣aij∣≦1\lvert a_{ij}\rvert\leqq1 ,则存在一个下三角矩阵LL 使得
证明使用归纳法。假设对于高达(n−1)\left(n-1\right) 阶的矩阵是正确的。如果AA 是nn 阶正定矩阵,我们可以将其划分为以下形式
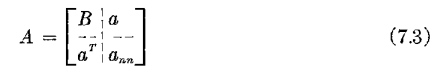
其中BB 是阶(n−1)\left(n-1\right) 的正定矩阵,aa 是阶(n−1)\left(n-1\right) 的向量。 通过假设有一个LL 满足
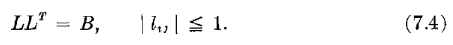
如果我们选择ll 使得

既然LL 是三角形且非奇异的,那么显然可以这样做
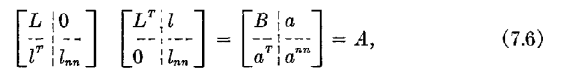
其中

两边都取行列式
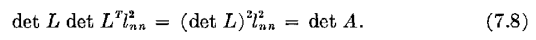
现在detA\det A 是正的,因为AA 是正定的; 因此l2nnl{2\atop nn} 是正的并且lnnl_{nn} 是实数并且可以被认为是正的。 如果ll 的分量用 ln1,ln2,...,ln,n−1l_{n1},l_{n2},...,l_{n,n-1} 表示,则由方程 (7.7)
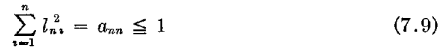
并且每个lnil_{ni} ,满足∣lni∣≦1\lvert l_{ni}\rvert\leqq1 。 等式 (7.6) 和 (7.7) 现在给出了AA 的适当分解,并且三角矩阵的所有元素都在±1±1 之间。 这样做的结果是可以在定点算术中执行LLTLL^T 分解。 顺便说一下,我们已经证明了LL 中任意一行元素的平方和都小于11 ,这个结果在后面会用到。
R<g(n)R<g\left(n\right) 的其他矩阵
8. Hessenberg 形式的矩阵与特征值问题有关。我们现在考虑使用归一化ll 减少上 Hessenberg 矩阵,使用“部分”旋转来确定大小。在每个阶段,简化矩阵的前列中只有两个元素,其中一个元素位于尚未修改的行中。由于即使对大小进行部分旋转也可以确保乘数在±1\pm1 之间,因此很容易看出第rr 个缩减矩阵中的最大元素位于±r\pm r 之间,因此最大的关键值为nn ,这只能通过最后一个主元来实现。进一步,如果我们称最终的三角矩阵为UU , MM 是AA 乘以UU 得到的矩阵,因此

很明显,MM 是下三角,其所有元素的模量都小于或等于1。如果我们用通常的方式写,

那么L=M−1L=M^{-1} ,并且我们已经证明了L−1L^{-1} 的所有元素都在±1±1 之间。
Hessenberg 矩阵的一种特殊类型是三对角矩阵。 根据大致相同的论点,很明显UU 的最大元素现在位于±2±2 之间,并且L−1L^{-1} 的所有元素再次位于±1±1 之间。 此外Σj∣uij∣≦3\Sigma_j\rvert u_{ij}\rvert\leqq3 。
最后,我们考虑具有主导对角元素的矩阵,使得
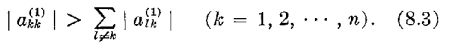
如果我们在不旋转大小的情况下执行消除,那么我们通常在第一阶段
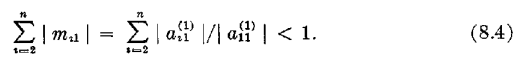
因此
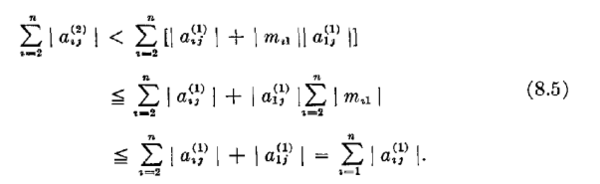
此外
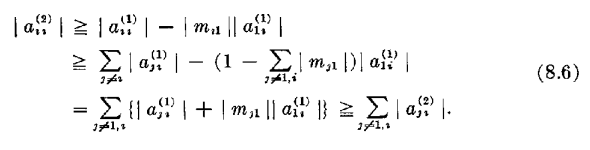
因此,对角线项在所有A(r)A^{\left(r\right)} 中以完全相同的方式占主导地位,并且从(8.5)开始,A(r)A^{\left(r\right)} 中任意列元素的模的和随着rr 的增大而减小。因此
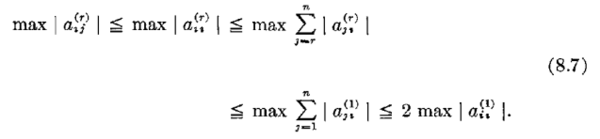
因此这个比值RR 肯定小于22 。通过类似的论证,我们看到,如果我们把约简写成以下形式
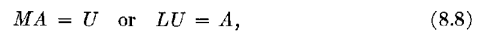
那么MM (或L−1L^{-1} )中的所有元素都小于11 。
即使对角元素不是严格占主导地位的,最后一种类型的行为也很常见。 例如,CnC_n 形式的矩阵,其中
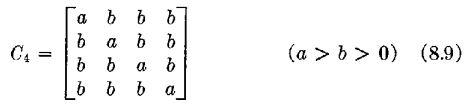
在高斯消元过程中保持这个特征,即使在任何阶段都不满足 (8.3) 时,对角线也会逐渐占主导地位。
在实际中遇到的许多矩阵并不严格属于我们所提到的任何特殊类别,但在性质上与它们相似。根据我们的经验,当使用大小的“完全”主元时,关键序列即使不是单调递减的,通常呈总体下降趋势。对于病态矩阵,这通常是非常明显的。这并不奇怪,因为如(4.11)所示,最后一个主元p1p_1 满足
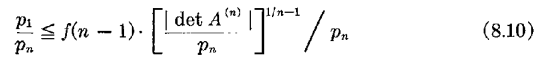
当A(n)A^{\left(n\right)} 是病态时,∣detA(n)∣|\det A^{\left(n\right)}| 通常比pnnp_n^n 小得多。
特殊矩阵的行为可能给人的印象是“部分”旋转大小与“完全”旋转一样有效。 以下示例表明它可能还不够。 考虑以下类型的矩阵BnB_n :
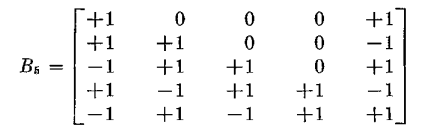
如果我们使用部分主元,那么主元总是在左上角,序列是+1,+1,⋅⋅⋅+1,(−2)n−1+1,+1,\cdot\cdot\cdot+1,\left(-2\right)^{n-1} 。如果使用完全主元,则序列为+1,−2,+2,+2,⋅⋅⋅,+2+1,-2,+2,+2,\cdot\cdot\cdot,+2 。我们稍后将展示如何修改BnB_n ,从而得到一个条件良好的矩阵,对其大小进行部分主元变换后得到完全不准确的逆矩阵。尽管完全旋转并不总是最好的策略,但我们还没能构造出一个例子来证明它是一个非常糟糕的策略,无论如何,第16节的分析给出了误差的上限。
这个例子也说明了平衡的重要性。如果将BnB_n 的最后一列乘以2−n2^{-n} ,那么部分主元法给出的关键选择与完全主元法相同,结果将是灾难性的。(见第29节)
谱范数的一些基本性质
9. 许多结果将需要重复使用,在这里组装它们很方便。我们首先给出我们使用的谱范数的属性。 我们假设AA 自始至终都是实数。
(A)定义:∥A∥=max[λ(AAT)]12\lVert A\rVert=\max\lbrack\lambda\left(AA^T\right)\rbrack^{{1\over 2}}
(B)∥A∥=max∥Ax∥/∥x∥,∥x∥≠0\lVert A\rVert=\max\lVert Ax\rVert/\lVert x\rVert,\lVert x\rVert\ne0 ,因此∥Ax∥≦∥A∥∥x∥\lVert Ax\rVert\leqq\lVert A\rVert\lVert x\rVert
(C)∥A∥\lVert A\rVert 满足矩阵范数的一般关系。
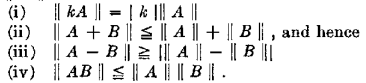
(D)如果A(r)A^{\left(r\right)} 是AA 的任意主子矩阵,则∥A(r)∥≦∥A∥\lVert A^{\left(r\right)}\rVert\leqq\lVert A\rVert (根据(B))
(E)∥abT∥=∥a∥∥b∥\lVert ab^T\rVert=\lVert a\rVert\lVert b\rVert (根据(B))。
(F)如果AA 是对称的,那么∥A∥=max∣λi(A)∣\lVert A\rVert=\max\lvert\lambda_i\left(A\right)\rvert 。
(G)如果A是正定的,∥A∥=maxλi(A)=λi\lVert A\rVert=\max\lambda_i\left(A\right)=\lambda_i ,∥A−1∥=max1/λi(A)=1/λn\lVert A^{-1}\rVert=\max1/\lambda_i\left(A\right)=1/\lambda_n 。
(H)∥A∥=∥AT∥\lVert A\rVert=\lVert A^T\rVert 。
(I)∥AAT∥=∥A∥2\lVert AA^T\rVert=\lVert A\rVert^2 。
(J)nmaxi,j∣aij∣≧∥A∥≧maxi,j∣aij∣n\max_{i,j}\lvert a_{ij}\rvert\geqq\lVert A\rVert\geqq\max_{i,j}\lvert a_{ij}\rvert 。
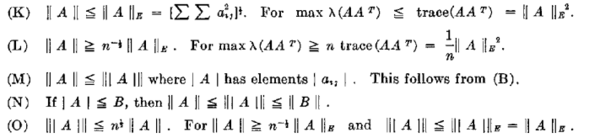
下面的结果是误差分析的基础,将反复使用。
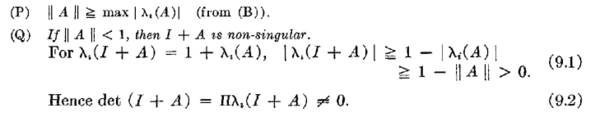
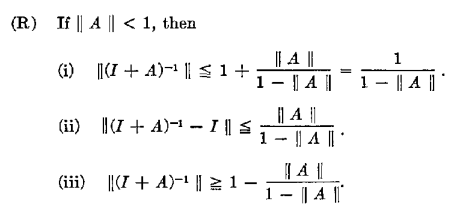
这些结果是由恒等式得出的
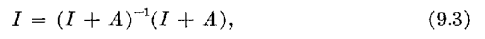
(I+A)−1\left(I+A\right)^{-1} 存在于(Q)\left(Q\right) 之后。 写作(I+A)−1=R\left(I+A\right)^{-1}=R ,
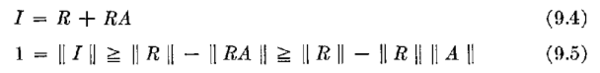
因为(1−∥A∥)\lparen1-\lVert A\rVert) 是正数,所以得到(i)。(9.4)给出
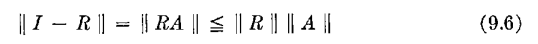
从而得到(ii);从(ii)我们推断
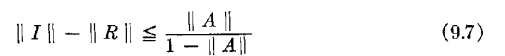
从而得到(iii)。
(S) 如果AA 是非奇异的并且∥A−1E∥<1\lVert A^{-1}E\rVert<1 ,那么(A+E)\left(A+E\right) 是非奇异的,并且我们有
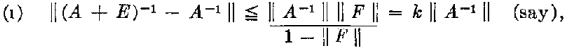
因此
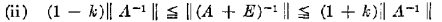
其中F=A−1EF=A^{-1}E ,使得∥F∥<1\lVert F\rVert<1 。
证明如下。我们可以写作
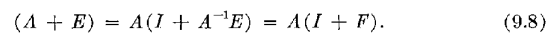
因此
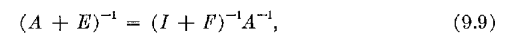
(I+F)−1\left(I+F\right)^{-1} 存在于(Q)\left(Q\right) 之后。 这给出
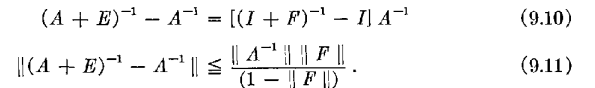
这给出了 (i),并且 (ii) 是一个直接的结果。
仅当(A+E)−1\left(A+E\right)^{-1} 可被视为A−1A^{-1} 的合理近似时才有价值。 通常我们不会知道乘积A−1EA^{-1}E 有什么特别之处,因此必须使用不等式来简化FF

这样做的必要性很可能导致我们估计
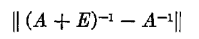
远高于其真实价值。 当进行替换 (9.12) 时,(i) 变为
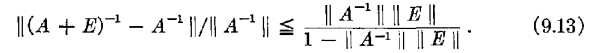
我们将左边的表达式称为(A+E)−1\left(A+E\right)^{-1} 中的相对误差。 请注意,我们得到的这个相对误差的界限包含∥A−1∥\lVert A^{-1}\rVert 本身作为一个因素,而绝对误差的界限包含∥A−1∥2\lVert A^{-1}\rVert^2 。这是否代表真实的事态取决于关键取决于 (9.12) 是否是一个相当尖锐的不等式。
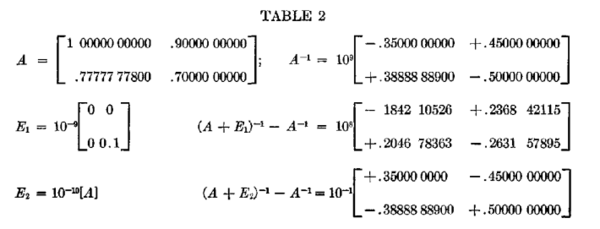
表2中的示例说明了最后一点。我们给出了一个病态矩阵AA ,并展示了在AA 中两种不同扰动E1E_1 和E2E_2 对逆矩阵的影响。这两种扰动具有相同的数量级,但E1E_{_1} 导致了∥A−1∥2∥E1∥\lVert A^{-1}\rVert^2\rVert E_1\rVert 阶扰动和∥A−1∥∥E2∥\lVert A^{-1}\lVert\rVert E_2\rVert 阶扰动。当EE 可以用这种形式表示时,扰动E的行为将与E2E_2 的行为相同
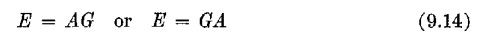
其中GG 与EE 的数量级相同。稍后我们将看到,在误差分析中会遇到这种扰动。 在 (S) 的应用中,我们通常会从头开始限制自己,例如
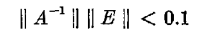
因为否则我们将无法证明计算出的逆函数是真实逆函数的合理近似。
在这个条件下,(i)和(ii)变为
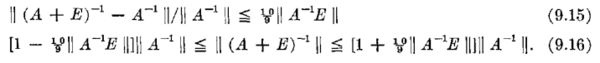
(T) 最终结果将在几乎所有分析中以某种形式使用。 如果 A 是非奇异的并且
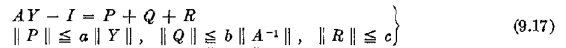
其中a、b和ca、b和c 是标量,如果a∥A−1∥<1a\lVert A^{-1}\rVert<1
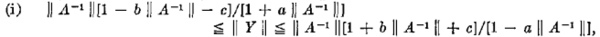
如果右边用k∥A−1∥k\rVert A^{-1}\rVert 表示
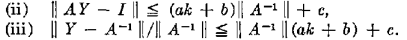
然后在表格中写下(9.17)
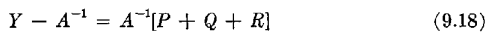
并对双方进行规范。假设所有a∥A−1∥a\lVert A^{-1}\rVert 和 (b∥A−1∥+cb\lVert A^{-1}\rVert+c ) 明显小于单位,(i) 和 (iii) 表明YY 是A−1A^{-1} 的良好近似。 在应用中,PP 总是出现在(9.17)中,但QQ 或RR 或两者都可能不存在。
我们再次强调,如果∥A−1∥∥P∥\lVert A^{-1}\rVert\lVert P\rVert 是∥A−1P∥\lVert A^{-1}P\rVert 的一个很差的近似,那么结果将是悲观的,如果PP 可以用ASAS 的形式表示,其中SS 为与我们PP 相同的数量级(当然,这句话中隐含了一个归一化的AA )。
三角方程组的解
10. 我们分析的所有反演方法都需要求解具有系数三角矩阵的方程组。 这些集合在定点算术中的解通常需要某种形式的缩放,所以我们首先考虑浮点解。 取上三角方程组
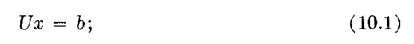
通常,xrx_r 是使用关系从计算的xr+1,…,xnx_{r+1},\ldots,x_n 计算出来的
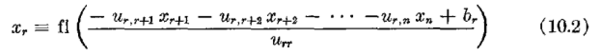
在[8]的符号中。 从中给出的内积结果,我们得到
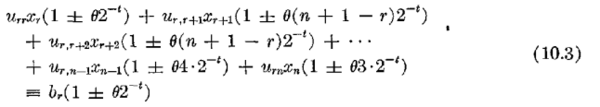
其中每个00 表示一个值,通常每个因子都不同,满足∣θ∣≦1\rvert\theta\rvert\leqq1 。
因此计算的解满足

其中,对于n=5n=5 ,
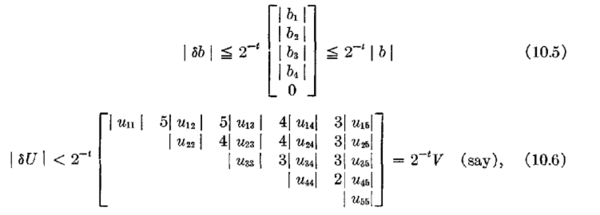
我们可以写作
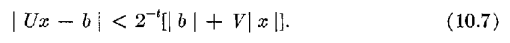
对于nn 组方程的解

对于计算出的XX ,我们得到
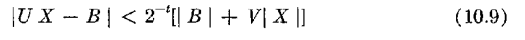
因此
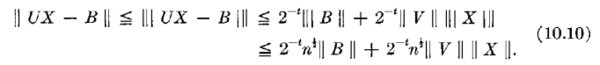
如果我们仅假设 U 具有归一化 (I),那么我们可以通过替换所有 u1 来获得 V 的上层纠缠。 通过统一。 我们得到
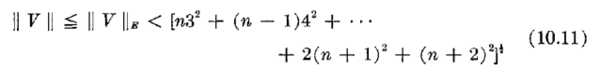
其中我们将VV 的第rr 列中的所有倍数替换为(n+3−r)\left(n+3-r\right) 。
我们推断∥V∥E∼n212\lVert V\rVert_E\thicksim{n^2\over \sqrt{12}} ,事实上

(这里和其他地方的结果都成立,当n<10n<10 时保持的结果并不比n≧10n\geqq10 时的结果更糟,但我们不太关心低阶矩阵。)因此
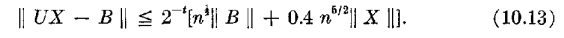
当B=IB=I 时,我们发现计算出的XX 恰好是三角形的,并且没有对应于∥B∥\lVert B\rVert 的项现在出现在 (10.13) 中。 这是因为逆的第 rr 列是Ux=erU_x=e_r 的解,因此 (10.5) 中δb\delta b 对应的误差是零向量。 除了对应于ene_n 的解之外,我们不需要整个优化矩阵VV ,但我们不会试图考虑这一点。因此,对于UX=IUX=I 的计算解,我们有,
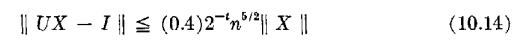
以及第 9 节的 (T),
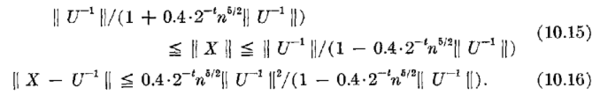
只有当(0.4)2−tn5/2∥U−1∥\lparen0.4)2^{-t}n^{5/2}\lVert U^{-1}\rVert 明显小于1时,我们才能保证XX 是一个好的逆矩阵。
另一方面,如果我们知道(正如我们经常会知道的那样)
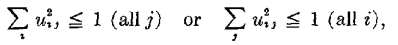
那么我们得到
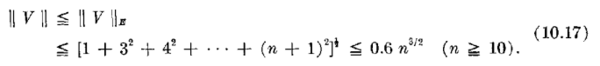
求逆的结果是
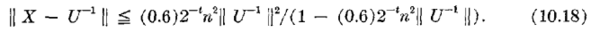
11. 定点运算的相应结果不太确定,因为它们取决于运算工具的细节以及我们是否有关于解大小的先验信息。 为了明确起见,我们假设标量积可以在双精度累加器中精确累加,并且可以划分到这个双精度累加器中。 所有桌面机器和许多高速计算机都提供了这些设施。
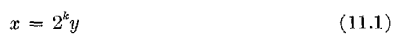
如果我们事先知道计算解在2k−12^{k-1} 和2k2^k 之间,那么我们可以写作
求解

变量yry_r , 由计算出的yr+1,⋅⋅⋅,yny_{r+1},\cdot\cdot\cdot,y_n 通过以下关系确定

其中ℏ\hbar 表示我们取括号中表达式的定点结果。分子是精确累加的,唯一的误差是除法的舍入误差。(我们默认标量积的中间值不需要引入比最终值更大的比例因子。在ACE中,这个困难可以通过精确累加2−p2^{-p} 倍的标量积来避免,其中2p2^p 大于可以处理的最大阶矩阵。因此,在标量积中不会出现溢出,引入的舍入误差(2p−2t2^{p-2t} )远低于其他的水平。我们不再提及这一点。)因此
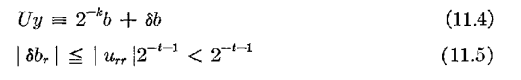
给出

应用于UX=BUX=B 的解,我们得到一个XX 满足
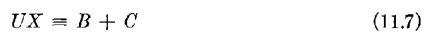
其中
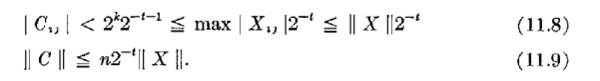
当B=IB=I ,我们得到

其中 (11.9) 得到满足,给出
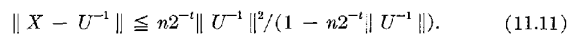
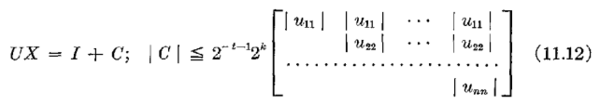
在这一点上,我们默认k≧0k\geqq0 。 如果k<0k<0 ,则不需要比例因子,并且 (11.9) 变为∥C∥<n2−t\lVert C\rVert<n2^{-t} 。 对于反演问题kk 必然满足k≧0k\geqq0 ,因为XX 的一个元素为(1/unn1/u_{nn} )且不小于1。 (11.5) 的最严格应用给出
12.如果事先不知道比例因子,随着计算的进行,XX 的元素会在必要时被密封。如果XX 的第一个计算元素需要整个计算所需的最大比例因子,那么分析就是我们刚才给出的。如果使用了大小的完全旋转,这通常会很容易。否则情况将是这样。假设在即将计算xrx_r 的阶段,当前比例因子为2kr+12^{k_{r+1}} ,我们可以将变量xix_i 的当前密封值表示为x(r+1)ix{\left(r+1\right)\atop i}(i=r+1,⋅⋅⋅,ni=r+1,\cdot\cdot\cdot,n ) ,因此
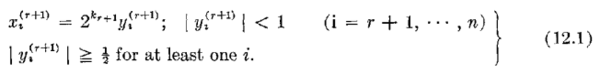
下一步是计算x(r)rx{\left(r\right)\atop r} 并在必要时引入增加的比例因子2kr2^{k_r} ,我们得到
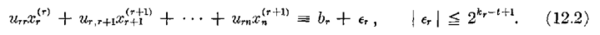
现在可能有必要在任何或所有后续阶段引入更高的比例因子,以便通过四舍五入xr,xr+1,xr+2,⋅⋅⋅,xnx_r,x_{r+1},x_{r+2},\cdot\cdot\cdot,x_n 获得这些变量的最终值x(1)r⋅⋅⋅x(1)nx{\left(1\right)\atop r}\cdot\cdot\cdot x{\left(1\right)\atop n} 到逐渐变少的数字。 可能发生的最坏情况是发生了 (k1−kr+1k_1-k_{r+1} ) 连续舍入。 如果那我们写作

那么
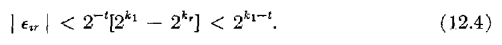
因此,最终值满足
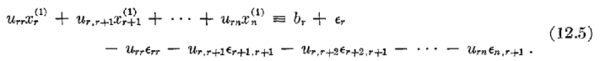
右边的误差项在(n+1−r)2k1−t\lparen n+1-r)2^{k_1-t} 范围内。这比在整个过程中使用最终比例因子2kt2^{k_t} 时获得的因子(n+1−r)\left(n+1-r\right) 更差。尽管如此,我们认为逐步引入比例因子通常会得到更精确的结果,特别是对于条件非常病态的矩阵。我们可以通过考虑矩阵AA 的求逆运算来说明这一点,如下所示,运算到五位数。
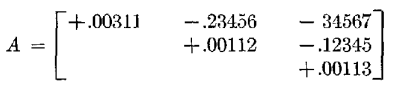
当使用递进的比例因子计算逆矩阵的最后一列时,我们对第一个实例的最后一个元素得到884.96。它随后被四舍五入为885,然后是9×1029\times10^2 ,最后一列是102[74552,975,9]10^2\left\lbrack74552,975,9\right\rbrack 。如果我们从一开始就引入正确的比例因子,我们将计算出最后一列102[75818,992,9]10^2\left[75818,992,9\right] 。 很明显,前者的答案更好,尽管它的残差大约是后者的 100 倍。
矩阵乘法
13.对于浮点矩阵乘法,我们写作

根据浮点标量积的结果,我们得到
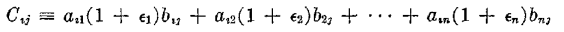
与ϵi\epsilon_i 的通常界限。 因此,对于 4 阶矩阵,我们通常有:
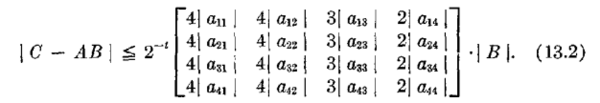
因此自然
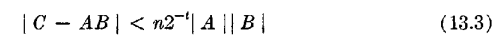
且
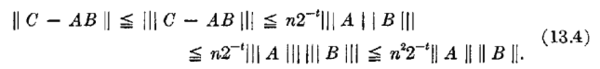
在本文中唯一的应用中,我们有B=ATB=A^T 且
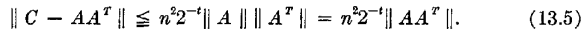
在表格中写作
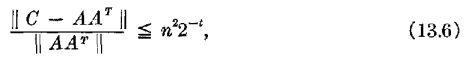
我们看到,计算出的乘积的相对误差的界与乘积无关。请注意,即使是计算出来的CC 也是完全对称的,因此我们只需要构造CC 的上半部分。
对于AATAA^T 的定点计算,即使比例因子是逐步引入的,我们也有
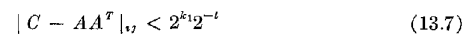
其中2k12^{k_1} 是最终的比例因子。如果先计算对角线上的元素,则会在初始阶段确定最终的比例因子,因为最大的元素在对角线上。由式(13.7)给出
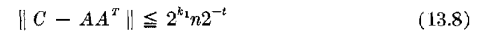
并且因此
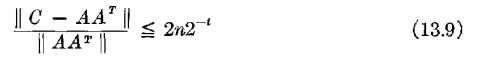
因为∥AAT∥≧max∣(AAT)ij∣≧12⋅2k1\lVert AA^T\rVert\geqq\max\lvert\left(AA^T\right)_{ij}\rvert\geqq{1\over 2}\cdot2^{k_1} 。 这是最令人满意的误差范围。
高斯消元法的一般误差分析
14. 现在考虑一个一般的矩阵AA 的求逆,通过使用一个完整的关键策略的高斯消元法将其还原为三角形式。这种策略只是决定了AA 的行和列的重新排序,如果我们认为AA 以这种方式被重新排序,那么在每个阶段主元素都在左上角,它将简化符号,而不会失去任何通用性。应该强调的是,这种重新排序是事先不知道的。
我们首先给出一个与所使用的算法类型无关的一般分析。我们用a(r)ija{\left(r\right)\atop ij} 表示第rr 个矩阵A(r)A^{\left(r\right)} 的计算元素,用mijm_{ij} 表示计算的乘数。(i,j)\left(i,j\right) 位置的元素历史记录如下。
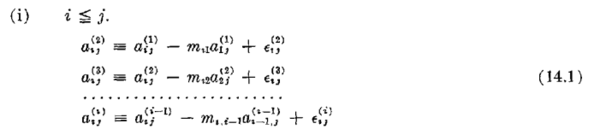
其中ϵ(k)ij\epsilon{(k)\atop ij} 是根据计算出的a(k−1)ij,mi,k−1a{\left(k-1\right)\atop ij},m_{i,k-1} 和a(k−1)k−1,ja{\left(k-1\right)\atop k-1,j} 计算a(k−1)ij−mi,k−1a(k−1)k−1,ja{\left(k-1\right)\atop ij}-m_{i,k-1}a{\left(k-1\right)\atop k-1,j} 时产生的误差。元素a(i)ija{\left(i\right)\atop ij} 是第ii 个关键行的元素,不会发生进一步变化。对方程 (14.1) 求和并消去公共元素,
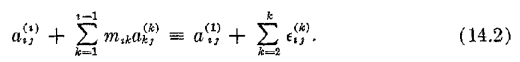
(ii)i>ji>j 。 我们现在有与 (14.1) 相同的方程,
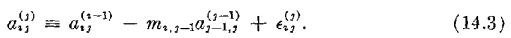
下一个值a(j+1)ija{\left(j+1\right)\atop ij} 被指定为零,并且在后续的归约过程中保持为零。元素a(j)ija{\left(j\right)\atop ij} 用于计算mijm_{ij}
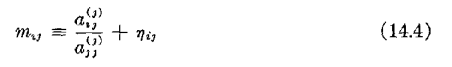
其中ηij\eta_{ij} 是除法中的舍入误差。因此
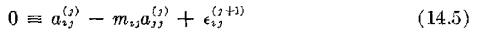
其中
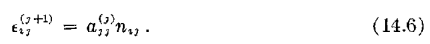
将(14.1)-(14.3)式求和并加上(14.5),
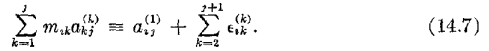
注意,方程(14.2)和(14.7)给出了最终三角矩阵的元素a(r)rsa{\left(r\right)\atop rs} 、元素mram_{ra} 和添加了扰动的元素a(1)rsa{\left(1\right)\atop rs} 之间的关系。 将LL 表示由 mijm_{ij} 形成的下三角矩阵,增加单位对角线,将UU 表示由关键行形成的上三角矩阵,(14.2) 和 (14.7) 给出
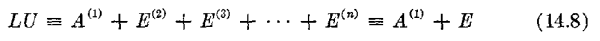
其中E(k)E^{\left(k\right)} 是由ϵ(k)ij\epsilon{\left(k\right)\atop ij} 构成的矩阵。注意,它的第1行到(k−1)\left(k-1\right) 为空,第1列到(k−2)\left(k-2\right) 为空。
我们可以这样描述这个结果。“计算得到的矩阵LL 和UU 是通过正确计算A(1)+EA^{\left(1\right)}+E 得到的矩阵。此外,A(k)A^{\left(k\right)} 是通过精确计算得到的矩阵
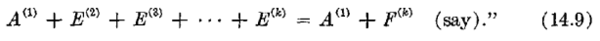
浮点数中的高斯消元法
15. 我们现在假设矩阵是按比例缩放的,因此所有元素都略小于1/g(n)1/g(n) [见第4节]。严格来说,对于浮点计算来说,这种扩展是无关的,但它有助于与其他地方的定点计算进行比较和误差分析。我们还假设矩阵是平衡的,尽管没有利用这一事实。我们认为这是必要的,以证明完整的关键战略。我们知道,对于精确计算,A(k)A^{\left(k\right)} 的元素将被限制在g(k)/g(n)g(k)/g(n) 之间,因此每个A(k)A^{\left(k\right)} 的每个元素都小于1。我们假设计算出的A(k)A^{\left(k\right)} 也是如此。
我们可能会觉得最后一段的结果保证了这一点,因为最终的LL 和UU 确实对应于A+F(n)A+F^{\left(n\right)} 的精确计算。不幸的是,每个A(k)A^{\left(k\right)} 对应于对应的A(1)+F(k)A^{\left(1\right)}+F^{\left(k\right)} 的精确计算,因此,尽管我们可以声称对A(1)+F(n)A^{\left(1\right)}+F^{\left(n\right)} 进行了精确的高斯消元,但不能说我们已经选择了对应于这个固定矩阵的每个阶段的最大主元。我们希望稍后再讨论这一点,但目前这仍然是一个假设。我们明确地假设
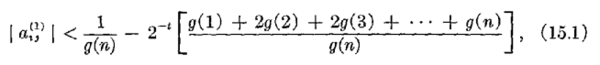
那么
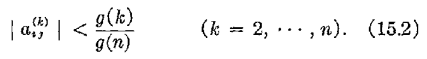
请注意,∣mij∣≦1\lvert m_{ij}\rvert\leqq1 是确定的,因为我们在每个阶段都将计算出的A(k)A^{\left(k\right)} 的最大元素作为基准值。
现在我们得到
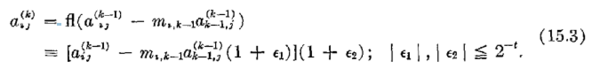
因此
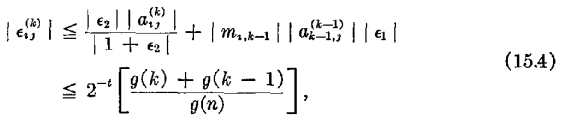
说明,在我们的假设 (15.1) 下,(A+E)\left(A+E\right) 的所有元素都小于1/g(n)1/g(n) 。
因为我们假设所有a(k)ija{\left(k\right)\atop ij} 都小于1,所以很明显
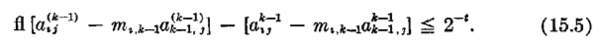
因此,矩阵E(k)E^{\left(k\right)} 的边界通常是n=5,k=3n=5,k=3 ,
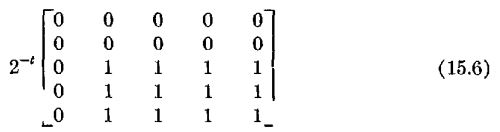
并且EE 为
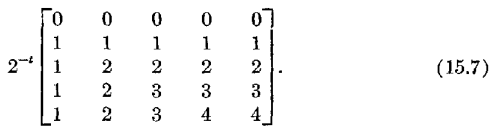
使用欧几里得范数作为近似值,我们得到

这些结果都代表了极端的上限,即使在减少过程中发生了最大可能的增长,也无法获得。通常情况下,随着过程的进行,元素的大小有所减小,则舍入误差肯定小于(∣a(k−1)ij∣+∣a(k−1)k−1,j∣)2−t\left(\lvert a{\left(k-1\right)\atop ij}\rvert+\lvert a{\left(k-1\right)\atop k-1,j}\rvert\right)2^{-t} 在每个阶段,逐渐变小。例如,如果元素在每个阶段都减小2倍,则 E 边界的最后一个元素变为2×2−t/g(n)2\times2^{-t}/g(n) 而不是 (n−1)×2−t\left(n-1\right)\times2^{-t} 。
仍然存在由于A(k)A^{\left(k\right)} 为零而导致进程过早中断的可能性。只有当A+F(k)A+F^{\left(k\right)} 正好是奇异值时才会发生这种情况。现在∥F(k)∥≦(0.41)2−tn2\lVert F^{\left(k\right)}\rVert\leqq\left(0.41\right)2^{-t}n^2 ,因为 F(k) 的每个元素肯定受我们对 E 的限制的限制。因此,如果(0.41)2−tn2∥A−1∥<1\left(0.41\right)2^{-t}n^2\lVert A^{-1}\rVert<1 ,则不会发生分解。如果我们要保证一个好的逆,我们在任何情况下都需要一个更强的条件。
16. 求逆运算通过求解完成
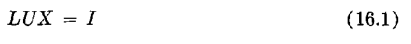
在这两个步骤中执行哪一个

将上述结果应用于三角方程组的浮点解,我们最终得到:
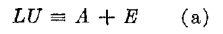
其中根据(15.8)
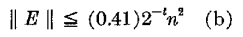
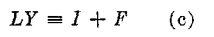
根据(10.14)
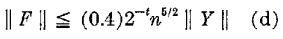
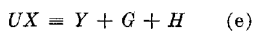
根据(10.13)
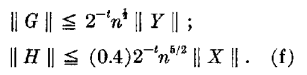
因此
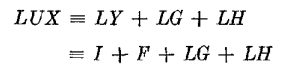
或
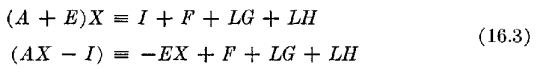
我们需要对右边每一项的范数有满意的界限。 很明显,除非2−tn7/2∥A−1∥2^{-t}n^{7/2}\rVert A^{-1}\rVert 明显小于 1,否则我们无法保证合理的逆。 因此我们假设

而这个条件当然可以保证在还原过程中不会出现故障。 我们进一步假设n≧10n\geqq10 。 联系 (16.4) 意味着AA 是非奇异的。 等式 (a) 和 (b) 给出
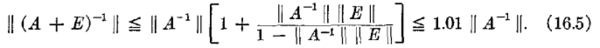
现在根据(a)
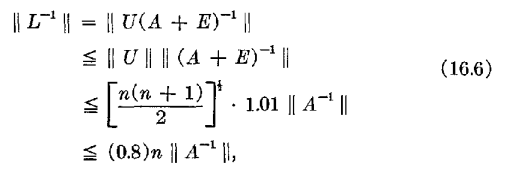
因为UU 的所有元素都小于1。
根据(c)和(d),
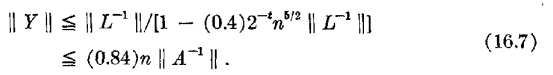
应用这些结果并记住∥L∥≦0.8n\lVert L\rVert\leqq0.8n ,因为它的所有元素都被1约束,我们得到
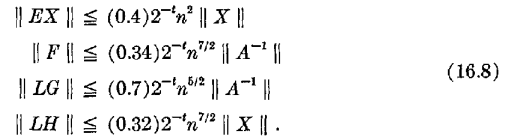
我们现在已经建立了第9节的类型(T)结果
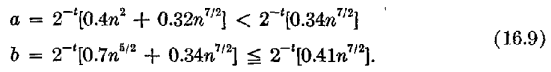
因此
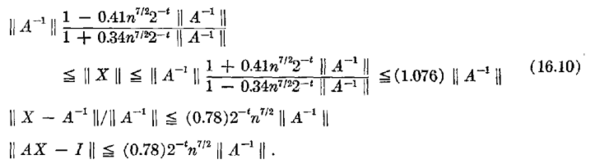
我们可以很容易地推导出元素以1为界限的矩阵的结果。如果BB 是这样的矩阵,那么我们使用A=B/g(n)A=B/g\left(n\right) 。通常情况下,我们会除以大于g(n)g(n) 的最小的 2 次方,这样就不会涉及四舍五入。如果XX 是AA 的逆矩阵,那么将Z=X/g(n)Z=X/g\left(n\right) 作为BB 的逆矩阵,然后我们得到
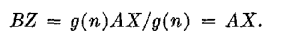
因此
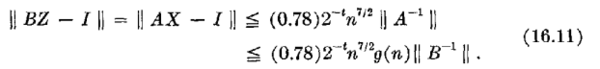
乍一看,术语n7/2n^{7/2} 的出现令人失望。 但是,我们必须记住,Goldstine 和 von Neumann 对于正定对称矩阵的结果包含因子n2∥A∥∥A−1∥n^2\lVert A\rVert\lVert A^{-1}\rVert ,并且∥A∥\lVert A\rVert 可能与nn 一样大。 在我们分析的相应位置,我们用0.8n0.8n 替换了∥L∥\lVert L\rVert 和∥U∥\lVert U\rVert ,这在我们的结果中贡献了一个因子nn 。 因此,我们只有附加因子n12n^{{1\over 2}} ,这个结果是针对一般矩阵的。
因子g(n)g(n) 的存在是不可避免的,但请注意它应该被max[1,R]\max\left[1,R\right] 代替,其中RR 是增长率,在每个特定情况下,在实践中RR 通常小于 1。 对于我们的每一种特殊类型的矩阵,我们都有一个RR 的先验上限,它比g(n)g(n) 小得多。
定点计算
17. 我们不希望对所有类型的不动点计算进行重复分析,我们只介绍一种特定的类型。在描述这一点之前,我们来证明它的选择是合理的。
求解已执行误差分析的非对称方程的替代方法是
(i)将问题转化为正定矩阵[3]的AΛTA\Lambda^T 求逆问题,
(ii) 通过不同类型的正交三角化 (§21-23)。
这些方法都不需要少于2n32n^3 次乘法,而我们刚刚描述的方法需要n3n^3 次。 如果我们准备使用2n32n^3 乘法,则以下策略可提供较高的准确性。
(I)对上述矩阵求逆,从而确定交换和所需的比例因子。
(II)利用(I)中获得的信息,在定点重复计算,尽可能累积标量积。
在 (II) 中,我们直接从LU=ALU=A 确定LL 和UU ,其中Λ\Lambda 的行和列按 (I) 确定的顺序排列。 我们应该计算 ½L½L 以防某些乘数由于不同的舍入误差而刚好大于 1。 由于这项方法,我们得到
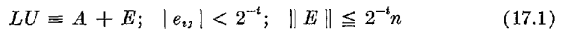
因为½L½L 和UU 的每个元素都是通过除以精确累加的标量积来直接确定的。 类似地,在求解LY=ILY=I 和UX=YUX=Y 时,比例因子是预先已知的。 我们给出的一些边界将根据maxij∣xij∣max_{ij}\lvert x_{ij}\rvert 大于或小于maxij∣yij∣max_{ij}\lvert y_{ij}\rvert 而不同。如果是这样,前一种情况下的边界在左侧给出,而后者在右侧给出。 我们得到
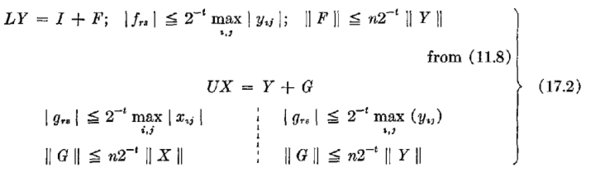
给出
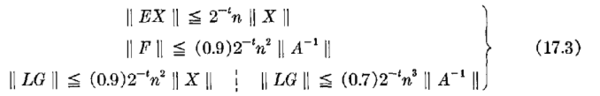
前提是2−tn2∥A−1∥≦0.12^{-t}n^2\lVert A^{-1}\rVert\leqq0.1 。 (常数只保留一位小数。)在这两种情况下,我们都得到第 9 节类型 (T) 的结果,其中
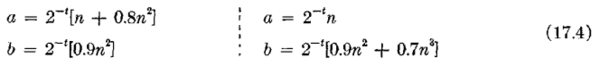
在实践中,第二种情况并不常见,因为XX 的最大元素通常比Y的最大元素大,特别是当AA 处于病态状态时。对于一些特殊的矩阵,我们已经知道maxi,j∣yij∣=maxij∣l−1ij∣\max_{i,j}\lvert y_{ij}\rvert=\max_{ij}\lvert l{-1\atop ij}\rvert 等于1。在任何情况下,maxi,j∣yi,j∣≦2n−1\max_{i,j}\lvert y_{_{i,j}}\rvert\leqq2^{n-1} ,因此对于小矩阵∥Y∥\lVert Y\rVert 不能很大。
因此我们通常会有
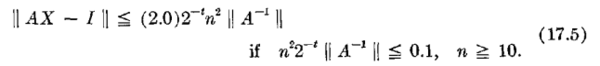
在另一种情况下,我们甚至不能保证XX 是一个近似的逆,除非n32−t∥Λ−1∥≦0.1n^32^{-t}\lVert\Lambda^{-1}\rVert\leqq0.1 ,然后我们得到
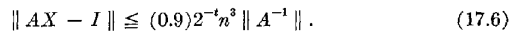
对称ChoIesky分解的误差分析
18. 我们省略了正定矩阵的高斯消元分析,现在可以在没有关键策略的浮点运算中完成。 分析类似于上一节的分析,除了我们知道关键元素的大小没有增长,并且LL 和UU 的范数与AA 的范数更特别相关。我们转而采用在其他情况下很重要的LLTLL^T 分解。
我们考虑对正定矩阵AA 进行LL 的定点计算。我们证明如果
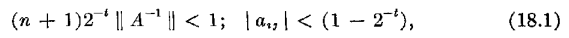
那么LL 的所有计算元素都满足∣lij∣<1\lvert l_{ij}\rvert<1 和
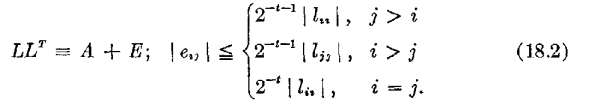
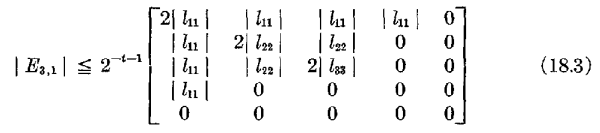
证明使用的是双重归纳法。假设当我们计算LL 的前ss 行和(s+1)\left(s+1\right) 第rr 行元素时,计算得到的元素都是1,并且是由矩阵精确分解(A+EsrA+E_{sr} )得到的。这里的EsrE_{sr} 是一个对称矩阵,除了它的ss 阶主矩阵和它的(s+1)\left(s+1\right) 第一行和列的前rr 个元素中有边界为(18.2)的元素外,其他元素为零。对于n=5,s=3,r=1n=5,s=3,r=1 ,我们通常有:
由式(18.1)和我们的假设,A+ErsA+E_{rs} 是一个元素以1为界的正定矩阵。
现在考虑确定ls+1,r+1l_{s+1,r+1} 。 计算它的方程式是
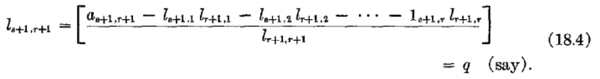
如果这个商被精确地计算出来,它将是对应于(A+Ers)\left(A+E_{rs}\right) 的精确分解的(s+1,r+1)\left(s+1,r+1\right) 元素,并且由于这是一个正定矩阵,其元素以1为界,所以精确商以1为界。 因此,计算出的ls+1,r+1l_{s+1,r+1} 也受单位限制,并且
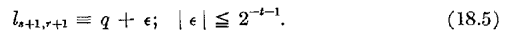
因此
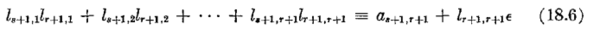
这样就完成了我们对元素ls+1,s+1l_{s+1,s+1} 的归纳。 这是根据关系计算的
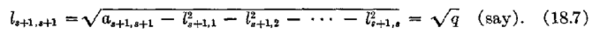
同样,如果精确计算平方根,它将小于1,因为它是A+Es+1,sA+E_{s+1,s} 的精确分解中的一个元素,它是正定的,元素以单位为界。
我们不想深入研究平方根子程序。在 ACE 上,平方根是通过双精度累加器除以牛顿过程计算的,在四舍五入时要注意,计算值是正确四舍五入的值
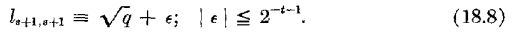
我们将在我们的分析中假设这一点,尽管我们有
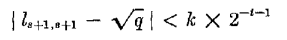
对于任何合理的kk ,AA 的条件不需要从 (18.1) 做太多改变。 由于计算值是正确舍入的值,
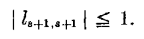
对于1×11\times1 矩阵,结果显然是正确的,因此归纳完成。注意,如果有任意一个ii 很小(并且如果AA 是病态的,几乎可以肯定这是正确的),则误差矩阵(LLT−ALL^T-A )的对应元素远小于2−t−12^{-t-1} 。换句话说,当AA 的元素不能精确地用tt 个二进制数字表示时,分解产生的误差可能远小于对AA 的元素进行初始舍入所产生的误差。LLTLL^T 分解是应用于对称矩阵的 Rutishauser的L−RL-R 技术的基础,也是当AA 为正定时计算det(B−λA)\det(B-\lambda A) 和 det(AB−λI)\det(AB-\lambda I) 的零点的基础。 因此,LLTLL^T 与AA 的接近程度具有重要的实际意义。
逆运算的完成
19.现在可以通过求解来完成反演

然后计算XXTXX^T 。在这部分工作中,我们不能再避免缩放,我们给出了浮点计算的分析,因为这一阶段所犯的错误并不重要。利用三角矩阵求逆的结果,并利用LL 中任意一行元素的平方和不大于一的事实(第7节),我们得到(10.18):
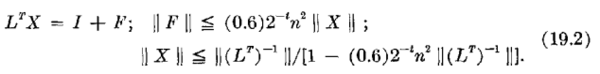
计算出的逆YY 满足
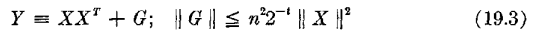
根据(13.5)。我们只需要计算YY 的上半部分,因为即使是计算出来的YY 也是完全对称的。从AA 计算YY 所涉及的乘法总数为12n3{1\over 2}n^3 ,因此该方法充分利用了对称性。
连同等式 (19.2) 和 (19.3)
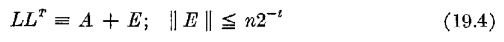
使我们能够评估 Y 的准确性。由于LL 和L−1L^{-1} 的范数与AA 和A−1A^{-1} 的范数之间的密切关系,因此直接计算相对误差比评估∥AY−I∥\lVert AY-I\rVert 更简单;我们在第 20 节对此进行评论。如果我们假设它会简化评估
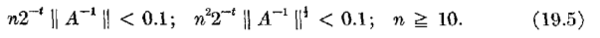
其中第一个或第二个更具限制性取决于∥A−1∥\lVert A^{-1}\rVert 的大小。在任何情况下,第一种方法都足以确保在计算LL 时不发生故障,并且其他任何地方都不会出现故障。
我们将A的对称性和(19.2)到(19.5)的关系的推论归纳在公式(19.6)中:
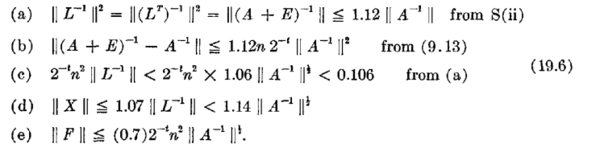
因此
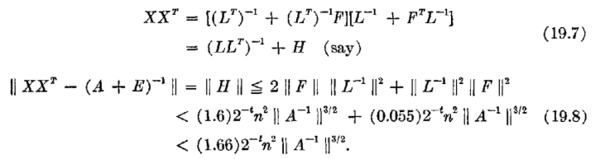
条件 (19.5) 允许我们以多种方式表达∥F∥2\lVert F\rVert^2 中的项,但使用与HH 的主要成分相同的形式更方便。最后我们有
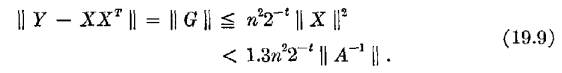
结合(19.6b)、(19.8)和(19.9),YY 的相对误差为:
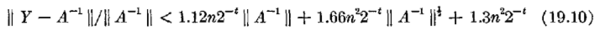
其中右边的三项分别来自L、X和YL、X和Y 的计算。 通过在X和YX和Y 的计算中使用定点运算,我们可以将最后两项中的n2n^2 减少到nn ,但是如果AA 非常病态,以至于∥A−1∥\lVert A^{-1}\rVert 很大,那么无论如何,三角化的误差是最重要的,而计算XXTXX^T 的误差是最小的。
我们可以先解LX=ILX=I ,然后再计算XTXX^TX ,而不是LTX=IL^TX=I 。在这两种情况下,相对误差的界是相同的,当然,计算出的逆函数是不同的。
残差矩阵
20.在大多数误差分析中,我们处理的是残差矩阵(AY−I)\left(AY-I\right) 。值得注意的是,如果我们求解LTX=IL^TX=I ,我们可以获得比求解LX=ILX=I 更好的矩阵边界。此外,计算的各个部分对残差矩阵的贡献与对相对误差的贡献并不相同。
使用LTX=(I+F)L^TX=\left(I+F\right) ,我们有
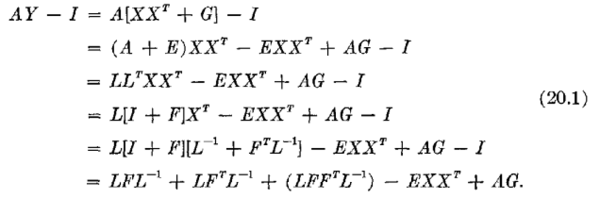
由E、F、GE、F、G 产生的分量范数的界限的数量级分别为
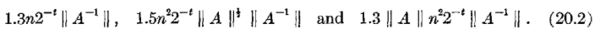
包含FF 和FTF^T 的项做出相同的贡献,而FFTFF^T 项的贡献可以忽略不计。 请注意,GG 对残差的贡献可能很容易是最大的,即使它对逆本身的影响最小也是如此。
另一方面,如果我们使用
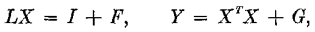
那么F和G是有界的,但是
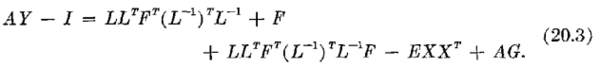
包含FTF^T 和FF 的项的数量级现在是
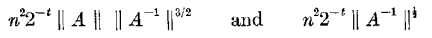
因此,如果A是病态的,那么前一项可能是严重的。然而,除了特殊构造的矩阵,这两项之间的差异在实际中并不会发生。这是由三角矩阵逆的性质决定的,将在第27-28节讨论。
正交化简为三角式
21. 我们现在考虑通过与正交矩阵的预乘将矩阵化简为三角式。 在这种类型的方法中,原始矩阵被连续变换为 ,其中除了前一个矩阵中的那些之外,序列的每个成员在对角线下方至少有一个额外的零。 这些零可以一次产生一个 (Givens),或者一次产生整个子柱 (Householder)。 无论该方法的细节如何,误差分析都具有某些共同特征,正如我们现在将要展示的那样。
我们可以这样定义数学过程。从

生成
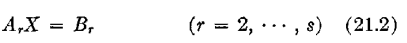
其中
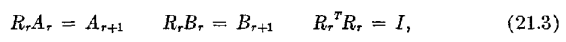
矩阵RrR_r 是连续正交矩阵。
我们现在考虑实际的过程,用ArA_r 表示第rr 个计算矩阵。与此对应的ArA_r (注意,这不是前面阶段中通过精确计算得到的矩阵),该技术定义了一个精确的正交矩阵RrR_r 。计算得到的矩阵Rˉr\bar{R}_r 与此不同,我们可以写成

然后,我们将ArA_r 乘以Rrˉ\bar{R_r} ,并进一步计算误差,使计算出的Ar+1A_{r+1} 和Br+1B_{r+1} 满足:
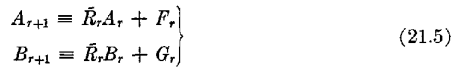
请注意,我们将那些本应为零的元素取为恰好等于零,并且FrF_r 必须包括该假设中隐含的误差。 如果FrF_r 要小,那么RˉrAr\bar{R}_rA_r 必须至少有小元素来代替那些应该为零的元素。
我们现在可以用两种不同的方法进行分析。
(A)我们可以写作
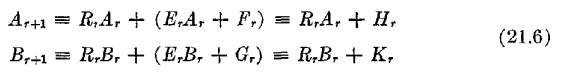
并假设我们可以找到∥Hr∥\lVert H_r\rVert 和∥Kr∥\lVert K_r\rVert 的界限
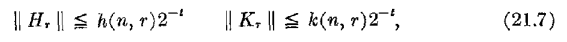
其中hh 和kk 是nn 和rr 的简单函数。
最后一组方程是

一个三角形集,计算出的XX 满足
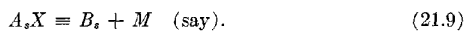
预乘R1TR2T⋅⋅⋅RTs−1R_1^TR_2^T\cdot\cdot\cdot R{T\atop s-1} ,我们有
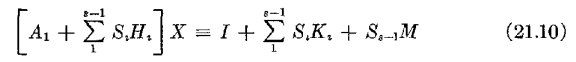
其中

因为所有的RiR_i 和SiS_i 都是正交的,我们得到
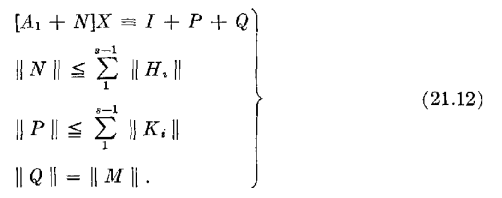
(B)我们可以使用Rˉr\bar{R}_r ,并假设FrF_r 和GrG_r 具有这种形式的边界
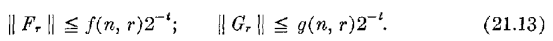
将(21.9)先乘Rˉ−11Rˉ−12⋅⋅⋅Rˉ−1s−1\bar{R}{-1\atop 1}\bar{R}{-1\atop 2}\cdot\cdot\cdot\bar{R}{-1\atop s-1} 我们得到
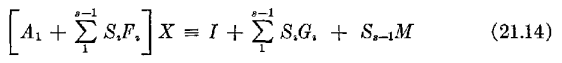
其中

现在SiS_i 不再是完全正交的,但假设我们可以证明∥Er∥≦a<1\lVert E_r\rVert\leqq a<1 。那么我们有
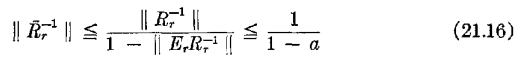
因为R−1rR{-1\atop r} 是正交的。因此,我们就有了与(21.12)相同形式的关系:
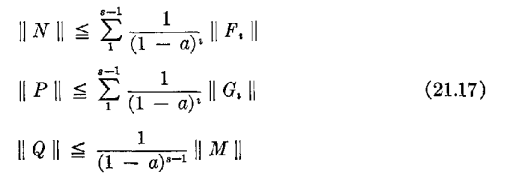
现在观察,我们可以允许aa 的值大大大于2−t2^{-t} 而不会损失太多。 例如假设a=10−4a=10^{-4} 。 现在在 Householder 方法中s=ns=n ,因此即使n=104n=10^4 ,因子1/(1−a)s−11/\left(1-a\right)^{s-1} 也仅等于ee 。 因此我们看到,尽管将ArA^r 与Rˉr\bar{R}_r 预乘时产生的误差应保持尽可能低(2−t2^{-t} 阶),并且确切的RˉrAr\bar{R}_rA_r 应在应产生零的位置具有2−t2^{-t} 阶的元素 ,我们可以容忍矩阵Rˉr\bar{R}_r绝不是正交的工作精度。 我们对Rˉr\bar{R}_r 的真正要求是它的范数和Rˉ−1r\bar{R}{-1\atop r} 的范数都应该合理地接近统一。 (B)分析显然更深入。
这与在对称特征问题中使用正交变换的情况形成了对比。在这里,我们与Rˉr\bar{R}_r 做前乘,用RˉTT\bar{R}{T\atop T} 做后乘,我们假设得到的矩阵仍然是对称的。除非Rˉr\bar{R}_r 是准确正交的,否则这不是一个准确的相似变换。
22. 如果分析要给出令人满意的结果,那么根据我们使用 (A) 或 (B),我们应该能够为HH 和KK 或FF 和GG 的范数获得令人满意的界限是至关重要的。 前者意味着为ErE_r 找到非常好的边界,但后者在这方面要求不是很高。 现在,在高斯消元法中,找到边界的主要障碍是减少矩阵的元素大小逐渐增加的可能性,因为通常当前舍入误差与元素的当前大小成正比。 对于正交(或接近正交)矩阵,这个困难不再存在。A1A_1 的每一列的欧几里德范数通过精确的正交变换得以保留。 因此,如果最初每列中元素的平方和小于 1,则这在所有后来的矩阵中仍然成立。
在实践中,在定点工作时,我们必须缩放A1A_1 ,使舍入误差的累积不会导致任何ArA_r 的任何列的范数超过1。出于同样的原因,我们必须取B1=12IB_1={1\over 2}I 。对于浮点数,我们不需要采取这些额外的预防措施,但在估计HrH_r 和KrK_r 或FrF_r 和GrG_r 的边界时,需要处理可能出现的规范的轻微增加。
对Givens Reduction的详细分析
23. 我们现在对Givens Reduction做一个简要的分析。 我们在浮点中工作,因为在定点工作中积累标量积所带来的收益并不大。 我们取A1A_1 原本进行归一化 (II)。
考虑归约中的一个典型阶段,在该阶段,rr 列已变为三角形且元素 (r+2,r+1);⋅⋅⋅\left(r+2,r+1\right);\cdot\cdot\cdot ; 第 (r+1)\left(r+1\right) 列中的(k,r+1)\left(k,r+1\right) 已设为零,因此通常对于n=5、r=1、k=3n=5、r=1、k=3 ,当前矩阵的形式为
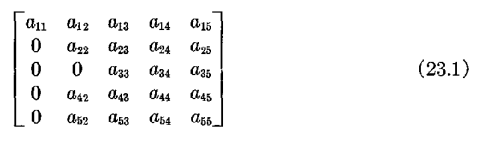
下一步是通过在(r+1,k+1)\left(r+1,k+1\right) 平面中旋转使(r+1,k+1)\left(r+1,k+1\right) 元素为零。 这仅修改行(r+1)\left(r+1\right) 和(k+1)\left(k+1\right) 中的元素,并保持前面的零不变。在这一阶段,我们假设AA 和BB 所有列的欧氏范数有界
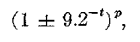
其中pp 是到目前为止已经完成的变换次数,并在下一阶段的分析中验证这个假设。
旋转矩阵的分量可以根据这些关系计算出来
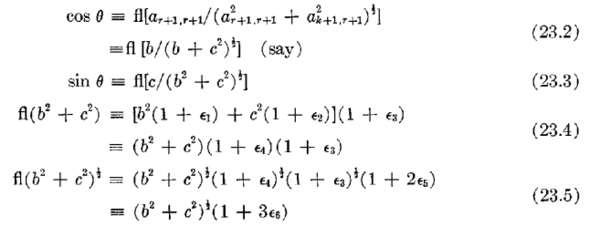
其中所有∣ϵi∣≦2−t\lvert\epsilon_i\rvert\leqq2^{-t} 并且我们假设了一个平方根子程序,它给出的误差小于2t2^t 中的 2 个部分。 因此计算的cosθ\cos\theta 和sinθ\sin\theta 满足
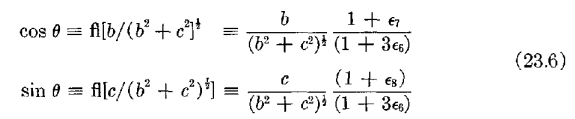
在上一节的表示法中,我们有一些很粗略的不等式,
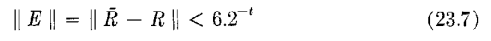
与bb 和cc 的大小无关。 因此,在第 21 节的符号中,我们可以取a=6.2−ta=6.2^{-t} ,很明显,偏离正交性并不重要。
现在我们转向F和G矩阵的确定。除了行(r+1)\left(r+1\right) 和(k+1)\left(k+1\right) 之外,这些都是空值,并且对于FF ,这两行从11 到rr 的位置都是空值。
FF 的元素(r+1,k+1)\left(r+1,k+1\right) 必须特殊处理,但FF 和GG 的每个其他非零元素的边界由下式给出
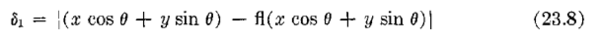
或由
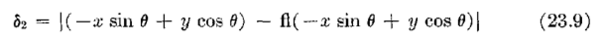
其中xx 和yy 是当前A或BA或B 的某列第(r+1)\left(r+1\right) 和(k+1)\left(k+1\right) 个位置的已有元素。对于δ1\delta_1 ,忽略2−2t2^{-2t} ,
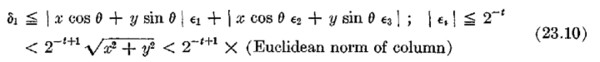
同样的结果也适用于δ2\delta_2 。这使我们能够证明关于转换后的A和BA和B 的列范数的原始假设。因为此转换前后任何列的范数之比肯定介于(1±9×2−t)\left(1±9\times2^{-t}\right) 之间。这已经足够覆盖Rˉ\bar{R} 中的误差以及乘以它所产生的δ1\delta_1 和δ2\delta_2 的误差了。所有转换后的列的所有范数都位于(1±9.2−t)n(n−1)2\lparen1\pm9.2^{-t})^{{n\left(n-1\right)\over 2}} 之间。 这些范数将是统一的,因为我们在任何情况下都需要n2×2−tn^2\times2^{-t} 明显小于统一才能得到有用的逆。RˉA\bar{R}A 的(k+1,r+1)\left(k+1,r+1\right) 元素的模量的精确值为
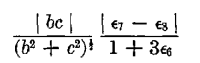
这肯定小于2−t2^{-t} 。 将其替换为零时,我们犯了一个错误,其边界小于我们为行(r+1)\left(r+1\right) 和(k+1)\left(k+1\right) 的其他元素获得的边界。 结合当前FF 和GG 的这些结果,
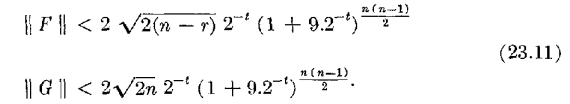
汇总这些结果并取∑1rS12=23r3/2\sum\nolimits_1^rS^{{1\over 2}}={2\over 3}r^{3/2} ,∑1rS3/2=25r5/2\sum\nolimits_1^rS^{3/2}={2\over 5}r^{5/2} ,根据(21.12)和(21.17)我们得到
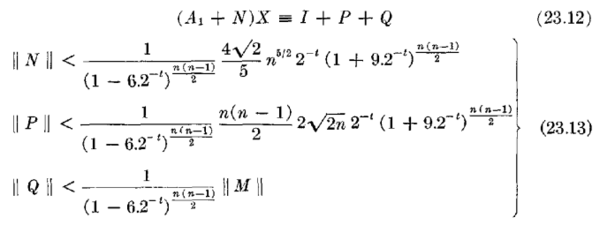
我们用1/(1−a)n(n−1)21/\left(1-a\right)^{{n\left(n-1\right)\over 2}} 替换所有地方的1/(1−a)21/\left(1-a\right)^2 。我们暂时写
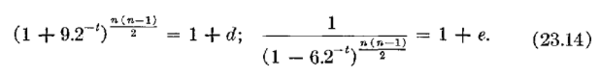
现在MM 是求解最终三角方程组的误差

因此,从(10.10)和(10.17)可知,计算得到的XX 满足

当然在那里
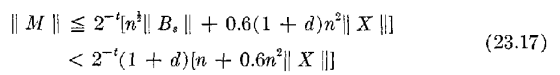
由于AsA_s 和BsB_s 每列的范数小于(1+d)\left(1+d\right) ,因此有
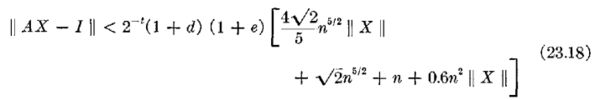
这是标准形式的结果。对于一个相当好的逆函数,我们需要
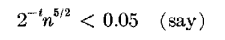
并假设n≧10n\geqq10 这肯定给出
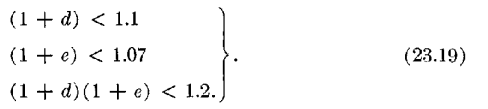
我们将进一步要求
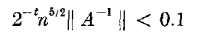
如果我们假设这一点,当n>10n>10 时我们肯定有
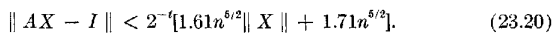
从第9节(T)我们得到
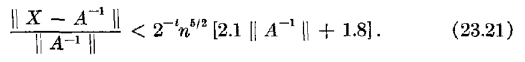
结果是一个归一化(II)的矩阵。对于归一化(I),按照通常的方式,我们立即得到:
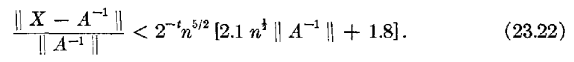
更危险的项是 (2.1)2−tn3∥A−1∥2^{-t}n^3\lVert A^{-1}\rVert ,这主要来自在每个阶段计算RˉA\bar{R}A 时产生的舍入误差。
我们不能通过定点工作获得太多,因为没有阶段可以积累任何大小的标量积。 在计算cosθ\cos\theta 和sinθ\sin\theta 时必须小心。最令人满意的技术是精确地累加(b2+c2)\left(b^2+c^2\right) ,然后按最大22k2^{2k} 缩放它,其中22k(b2+c2)<12^{2k}\left(b^2+c^2\right)<1 。 然后我们从2kb2^kb 和2kc2^kc 计算cosθ\cos\theta 和sinθ\sin\theta 。 计算出的矩阵比浮点计算更接近于正交矩阵,而且在计算(xcosθ+ysinθ)\left(x\cos\theta+y\sin\theta\right) 和(−xsinθ+ycosθ)\left(-x\sin\theta+y\cos\theta\right) 时仅产生一个舍入误差。 精度的提高最多相当于一个小的常数因子,我们不能获得n\sqrt{n} 的因子。
Householder的减少
24. 只有(n−1)\left(n-1\right) 转换涉及到Householder减少。在第一步,我们乘以一个形式为(I−2ωrωrT)\lparen I-2\omega_r\omega_r^T) 的矩阵,其中wrTw_r^T 是这种形式
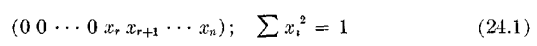
这会在第rr 列的对角线下方产生零。 它保留A和BA和B 的前(r−1)\left(r-1\right) 行和AA 的前(r−1)\left(r-1\right) 列不变,因此AA 的(n−r+1)2\left(n-r+1\right)^2 个元素被修改, B 的n(n−r+1)n\left(n-r+1\right) 个元素被修改。在进入下一阶段之前,我们被迫对这些元素进行舍入,这样我们就没有希望获得比FrF_r 和GrG_r 更清晰的边界
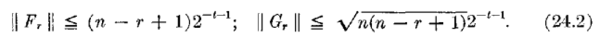
这给出了N和PN和P ,
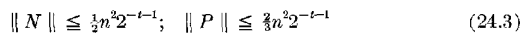
即使我们让定义在第311页的aa 等于0。因此,如果我们充分小心地计算(I−2wrwrT)Ar\lparen I-2w_rw_r^T)A_r 和(I−2wrwrT)Br\lparen I-2w_rw_r^T)B_r ,我们希望得到的最多是n\sqrt{n} 的因子,也许是一个小的常数因子。
如果我们使用传统的浮点运算,我们甚至无法得到n\sqrt{n} 因子。如前所述,很容易看出偏离正交性是轻微的,因此不重要,我们可以把注意力集中在计算Ar+1A_{r+1} 本身所产生的误差上。
我们假设我们有一个精确的wrw_{_r} 并估计在计算 Ar−2wrwrTArA_r-2w_rw_r^{^T}A_r 时产生的错误。第一阶段是典型的,所以我们处理A1−2w1w1TA1A_1-2w_1w_1^{^T}A_1 。 我们有
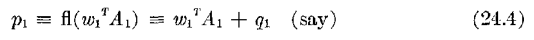
q1kq_{1k} 可以写成这种形式
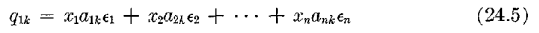
其中
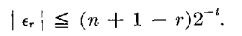
现在Σxi2=1\Sigma x_i^2=1 和Σia2ik=1\Sigma_ia{2\atop ik}=1 (后者大约在后期阶段持续存在),但我们不能得出比这更明确的结论
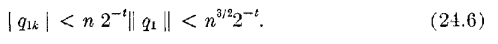
在计算ℏ(w1w1TA1)\hbar\left(w_1w_1^TA_1\right) 时,仅来自q1q_1 的贡献就是∥w1∥∥q1∥\lVert w_1\rVert\lVert q_1\rVert ,我们对此唯一的限制是n3/22−tn^{3/2}2^{-t} 。 类似地,在后面的阶段,我们有r3/22−tr^{3/2}2^{-t} 量级的贡献,它们一起给出n5/22−tn^{5/2}2^{-t} 项。 在实践中,在浮点计算中,将方程式表示为方程式 (24.7) 中所示的形式很方便(第一步是典型的)。
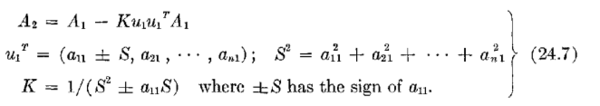
这种形式避免了不必要的平方根,但不会导致误差下界。
在定点运算中,我们确实可以实现因子n12n^{{1\over 2}} 的增益,但只有在具有良好运算能力的计算机上才值得这样做。 为确保准确确定ww ,应准确累加S2S_2 ,然后乘以22k2^{2k} ,其中kk 是22kS22^{2k}S^2 不大于零的最大整数。 然后可以使用2kai12^ka_{i1} 而不是ai1a_{i1} 来计算向量 ww 。 这给出了ww 的非常准确的确定,我们只需要关心计算中的错误 (A1−2w1w1TA1A_1-2w_1w_1^TA_1 )。 在形成p1=ℏ(w1TA1)p_1=\hbar\left(w_1^TA_1\right) 时,我们可以累加标量积,并且由于A1A_1 的列具有以单位为界的范数,因此w1TA1w_1^TA_1 的元素小于单位。 如果我们写
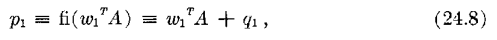
那么q1q_1 的所有元素都小于2−t−12^{-t-1} ,因此∥q1∥≦n2−t−1\lVert q_1\rVert\leqq\sqrt{n}2^{-t-1} 。 虽然2w1w1TA12w_1w_1^TA_1 的元素可能大于 1,但我们知道A1−2w1w1TA1A_1-2w_1w_1^TA_1 的元素没有统一,因此前者的溢出不会造成任何危害。 为了始终安全,我们必须最初对AA 进行缩放,以便其列充分小于 1,从而使ArA_r 的列始终小于 1。 如果足够小心,我们可以获得计算出的逆XX 满足
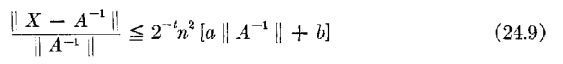
其中a和ba和b 是统一的。 对于规范化(I) 的矩阵,这给出
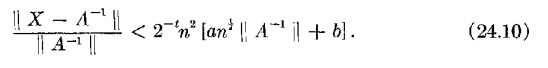
非对称矩阵求逆方法的比较
25. Givens 方法需要四倍于 Gaussian 反演的乘法运算,因此在单精度 Givens 反演和双精度 Gaussian 之间进行公平比较。 在此基础上,高斯解要好得多。 另一方面,Householder 方法只需要两倍于高斯反演的乘法。 然而,我们已经看到 [(17.7) 和第 9 节,(T)],如果我们准备执行两次高斯消元,我们可以期望逆满足
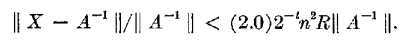
这比 Householder 更有利,即使在计算时非常小心,前提是“R”(枢轴比)小于 n\sqrt{n} 。 根据我们的经验,这几乎总是正确的,并且有许多重要的矩阵类型,我们事先知道它是正确的。
比较高斯消元法和Householder,当两者都以浮点数执行时,前者的相对误差为2−tn7/2r∥A−1∥2^{-t}n^{7/2}r\lVert A^{-1}\rVert ,后者的相对误差为2−tn3∥A−1∥2^{-t}n^3\lVert A^{-1}\rVert 。在我们看来,因素n7/2n^{7/2} 的存在源于分析的紧迫性,而不是源于任何真正的缺点,Householder 的案例很少。
我们进行误差分析的另一种方法是Goldstine和von Neumann的基于正定矩阵AATAA^T 求逆的方法。然而,这种方法需要2n32n^3 次乘法,并且在误差方面,它用∥A−1∥2\lVert A^{-1}\rVert^2 代替∥A−1∥\lVert A^{-1}\rVert 。如果AA 完全是病态的,则此方法没有任何可取之处。
对结果的一般评论
26. 我们获得的界限在所有情况下都是严格的上限。 一般而言,舍入误差的统计分布将大大减少出现在相对误差中的nn 的函数。 我们可能期望在每种情况下,该函数都应该被替换为不大于其平方根并且通常明显更小的东西。 例如,在形成浮点标量积时,我们使用了结果
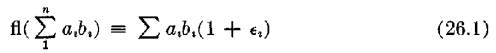
然后用它们的上限(n−i)2−t\left(n-i\right)2^{-t} 替换了ϵi\epsilon_i 。 现在要达到这些界限,不仅所有单独的舍入误差都必须具有最大值,而且aibia_ib_i 必须具有特殊分布。
另一方面,总是出现在相对误差中的项∥A−1∥\lVert A^{-1}\rVert 通常不受任何此类考虑。 有一些简单的标准来判断相对误差是有用的,这是由以下考虑提供的。 考虑对AA 的元素中2−t2^{-t} 阶扰动的逆的影响。我们有
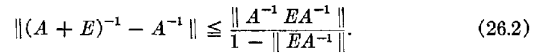
如果这些扰动不是特别相关,那么我们可以写
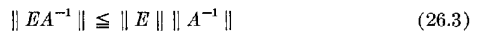
并期望右侧是左侧的合理近似值。
因此我们有
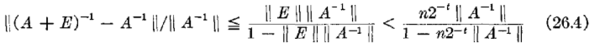
我们期望能够选择某个EE ,其右侧不会被严重高估。如果求逆的方法给出了XX 的逆
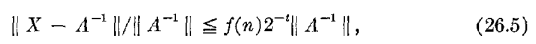
我们可以说,逆矩阵中的误差是由AA 的单个元素中的(1/n)f(n)2−t\left(1/n\right)f(n)2^{-t} 扰动引起的误差的数量级。可以认为,计算出的XX 将是某个矩阵(A+F)\left(A+F\right) 的精确逆,其中FF 的元素为(1/n)f(n)2−t\left(1/n\right)f(n)2^{-t} ,但这很少是正确的。实际上,XX 的逆矩阵元素通常与AA 的逆矩阵元素有(1/n)f(n)2−t∥A−1∥\left(1/n\right)f(n)2^{-t}\lVert A^{-1}\rVert 的数量级不同。因为如果AA 是病态的,∥A−1∥\lVert A^{-1}\rVert 将非常大,所以最后的结果有点令人惊讶。然而,一般来说,XX 的第rr 列确实是(A+Er)\left(A+E_r\right) 的精确逆的第rr 列,其中EE 具有阶数为(1/n)f(n)2−t\left(1/n\right)f(n)2^{-t} 的元素,但它要求每一列都有不同的ErE_r 。对于一个病态的2×22\times2 矩阵,读者可以很容易地验证这些注释。它们对于对称矩阵和非对称矩阵同样成立。
计算逆的高精度
27. 通常的经验是,即使通过统计效应对误差进行了最慷慨的估计,计算出来的逆函数也比预期的要准确得多。对这种现象不太可能有一个简单的解释,但下面这个影响非常明显的例子确实对一些主要原因提供了相当多的见解。我们考虑希尔伯特矩阵五阶对称部分的求逆运算,涉及8个小数。矩阵是正定的,∥A−1∥\lVert A^{-1}\rVert 大约为10610^6 。它的条件非常糟糕,将原始矩阵的元素截断为 8 位小数已经影响了逆矩阵的第二个数字。 这是意料之中的,因为∥A−1∥∥E∥∥A−1∥\lVert A^{-1}\rVert\lVert E\rVert\lVert A^{-1}\rVert 是有序的
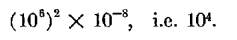
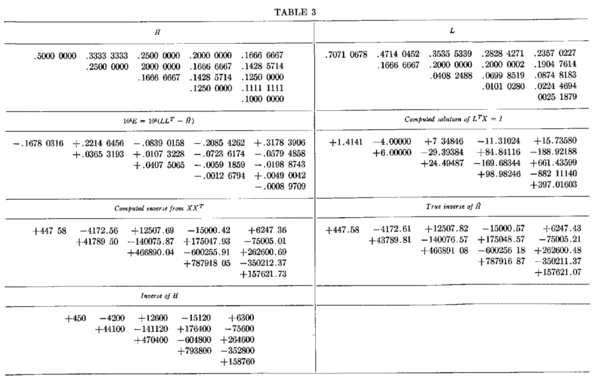
自然,我们将计算得到的逆矩阵与截断矩阵的逆矩阵进行比较,而不是与精确的希尔伯特段的逆矩阵进行比较!我们用HH 表示确切的希尔伯特段,用Hˉ\bar{H} 表示截断元素的矩阵,用XX 表示计算出的Hˉ\bar{H} 的逆矩阵。现在我们从表3中看到
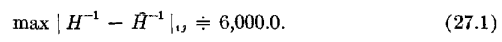
另一方面,对于通过第19节中的技术计算的XX ,我们可以看到

在求解过程中所产生的舍入误差的总影响远小于初始截断误差的影响。
有两个主要的现象可以显著说明解决方案的显著准确性。
(i)我们在第18节中看到LLT=Hˉ+ELL^T=\bar{H}+E , 并且EE 的典型元素以2−t−1∣lii2^{-t-1}\lvert l_{ii} 为界。如果某些元素∣lii∣\lvert l_{ii}\rvert 远小于1,则EE 相应元素的边界远小于2−t2^{-t} 。现在,因为Hˉ\bar{H} 是病态的,所以liil_{ii} 很小,并且随着ii 的增加而逐渐变小。图中显示了矩阵EE ,我们可以看到,当我们移动到右下角时,它的元素也逐渐变小。这里它们远小于12⋅10−8{1\over 2}\cdot10^{-8} (对于8进制计算,我们可能期望的最佳值)。请注意,LLTLL^T 如此接近Hˉ\bar{H} ,正是因为Hˉ\bar{H} 是病态的!
现在我们要考虑误差EE 对逆矩阵的影响。改变(i,j)\left(i,j\right) 元素ϵ\epsilon 所引起的扰动为
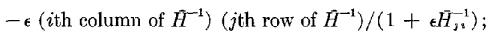
此时分母近似为1,Hˉ−1\bar{H}^{-1} 的第ii 行和第jj 列随着i和ji和j 的增大而普遍增大。这意味着EE 中最小的元素恰好处于对逆影响最大的位置。其结果是我们在计算的逆中没有得到∥Hˉ−1∥\lVert\bar{H}^{-1}\rVert 的全部效应。我们刚才注意到的效应在具有系统性元素的病态矩阵中非常普遍。如果考虑更高阶的希尔伯特线段,它变得更加明显。EE 中存在极小元素的情况在这类不太明显的病态矩阵中也很常见。
( ii )第二种现象具有更一般的性质,与三角矩阵的求逆有关.我们已经看到,对于一般形式的矩阵AA ,扰动在最终图形中的作用是引入一个通常与∥A−1∥\lVert A^{-1}\rVert 成正比的相对误差和一个与∥A−1∥2\lVert A^{-1}\rVert^2 成正比的绝对误差。只有当舍入误差具有特殊相关性时,才能避免这种影响。现在,对于一般矩阵,这种相关性是非常罕见的,而对于三角矩阵,这种相关性是很常见的,因为它构成了规则而不是例外(第28节)。一般来说,对于三角矩阵的求逆,我们通常有,
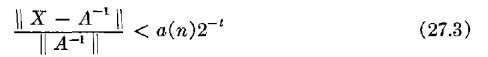
与一般矩阵更常见的结果相反,
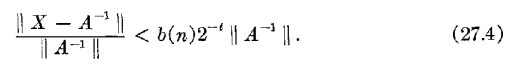
这意味着对于三角矩阵,相对误差不受矩阵条件影响的情况是普遍存在的。表3中的三角矩阵就是这样一个例子。计算的逆XX 中没有一个元素的误差大于计算中保留的最后一个图形中的一个。这意味着三角反演中产生的误差可以忽略不计,我们已经知道计算XXTXX^T 所涉及的误差可以忽略不计。综合的效果是产生了一个相当惊人的精度的逆。所有舍入误差的总效应远小于Hˉ\bar{H} 的( 5、5)单元中½⋅10−8½\cdot10^{-8} 的单个扰动所对应的总效应。
三角矩阵的求逆
28. 上一节所提到的三角矩阵的显著性质在实际中具有广泛的意义,因此指出具有这种显著性质的三角矩阵的类型是值得的。
也许最重要的一类是对角线元素为正,非对角线元素为负。在不失一般性的情况下,我们考虑下三角矩阵,并表明如果xˉij\bar{x}_{ij} 是计算的(i,j)\left(i,j\right) 元素和xijx_{ij} ,则精确,那么
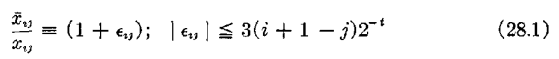
不管LL 有多么病态。 证明使用的是归纳法。 我们只需要考虑逆矩阵的第一列,因为一般来说,第rr 列是从通过将LL 的第一 (r−1r-1 ) 列设置为零而获得的三角矩阵导出的,并且这具有相同的属性。 假设 (28.1) 为真,当i=1,⋅⋅⋅,r−1i=1,\cdot\cdot\cdot,r-1 时j=1j=1 ,我们有一个明显的缩写符号:
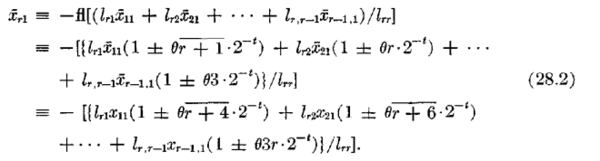
现在根据我们对lr,i,jl_{r,i,j} 的符号的假设所有xˉij\bar{x}_{_{ij}} 和xijx_{ij} 都是正的。此外,我们有
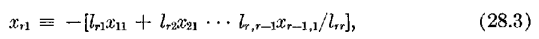
因此xˉrj\bar{x}_{rj} /xrj/x_{rj} 介于(1+3r⋅2−t)\left(1+3r\cdot2^{-t}\right) 和(1−3r⋅2−t)\left(1-3r\cdot2^{-t}\right) 之间;这就完成了证明。
证明的性质表明,结果并不清晰,我们会希望得到的结果明显优于
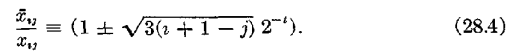
即使对于非常高阶的矩阵,这也会给出一个非常好的结果。它表明,如果我们使用浮点运算,那么即使是较小的元素也有较低的相对误差。当对椭圆型偏微分方程的有限差分近似得到的矩阵进行高斯消元时,就会产生这种矩阵。
当使用大小的完全旋转时,我们可以证明一个弱得多的结果,然而,它与LL 元素的符号分布无关。我们表明,如果∣lij∣≧∣lij∣\lvert l_{ij}\rvert\geqq\lvert l_{ij}\rvert ,那么对于具有固定比例因子的定点计算,
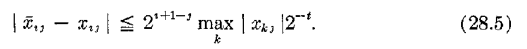
这个的证明可以通过归纳法直接得到,因为对于第一列,
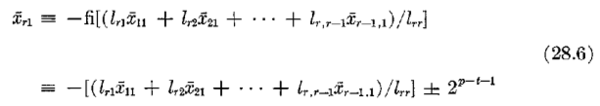
其中2p2^p 是比例因子。
因此
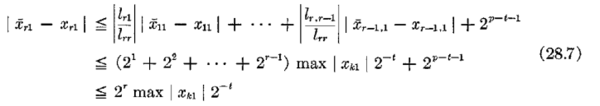
因为
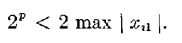
这个结果不是很惊人,但是对于小阶矩阵,2n2^n 可能远小于∥L−1∥\lVert L^{-1}\rVert 。因此,如果我们在低阶矩阵上使用了完全主元,那么当矩阵是病态时,我们肯定会得到一个“相对较好的”结果。
当在具有一个孤立的非常小的特征值的矩阵上使用完全主元的高斯消元时,“所有的病态”通常集中在最后一个元素上。例如,当λ\lambda 的值非常接近孤立的特征值时,(A−λI)\lparen A-\lambda I) 被简化为三角形式。三角矩阵通常为(28.8)所代表的形式:
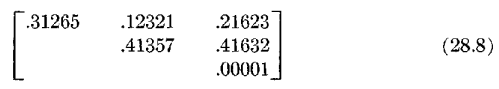
当用任意右侧解这组方程时,计算出的解在所有分量上都具有较低的相对误差。人们普遍认为,使用将所有的小值集中在最后一个基准点上的归约方法是一个糟糕的策略,因为这意味着最后一个基准点具有较高的相对误差。我们认为,这种信念没有实质内容。最后一个主元的出现表明矩阵是病态的,因为无论做了什么主元变换,最后一个主元的倒数都是逆矩阵的一个元素。在可以累积标量积的计算机上,通常使用导致最后一个支点非常小的关键策略比使用导致最后一个支点非常小的策略要好。例如,在上一节的例子中,最好是按原样处理矩阵,而不是按顺序处理位置4、5、3、2和1中的基准值,尽管前者会导致最后一个基准值更小。如果标量积不能累加,那么在不使最后一个支点变得非常小的策略中有一个非常小的优势。应该认识到,来自小的最后一个支点的伤害主要是矩阵的属性,而不是由解决方法引起的。当标量积没有精确累加时,对应于最后一个基准值的A的原始元素的扰动是(n−1)\left(n-1\right) 舍入误差的和,而对应于第rth基准值的元素的扰动是(r−1)\left(r-1\right) 舍入误差的和。理想情况下,我们应该使最后一个主元对应于元素i,ji,j ,使得AA 的第ii 列和第jj 行范数的乘积尽可能小。似乎没有任何切实可行的策略可以保证这一点。
第27节中的三角矩阵不属于我们目前提到的任何一类。现在我们描述一个更大的矩阵类,对于这些矩阵,我们的结果是正确的。考虑使用常数比例因子2k2^k 在定点算法中求解一个下三角方程组。设Xˉ\bar{X} 为计算出来的逆函数,XX 为真正的逆函数。我们有
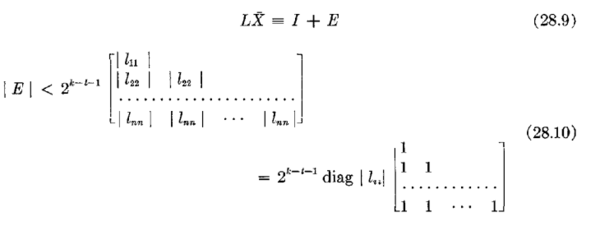
假设对于j>ij>i ,XX 满足∣xji/xii<C\lvert x_{_{ji}}/x_{ii}<C 。现在精确解是Xˉ−XE\bar{X}-XE 使得误差矩阵以∣XE∣\lvert XE\rvert 为界,我们有
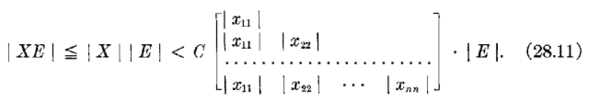
因此,由于xii=1/liijx_{ii}=1/l_{iij}
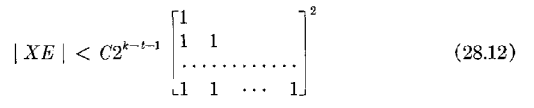
给出
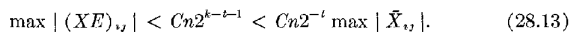
这表明,XX 中任何元素的误差都是其最大元素的小倍数。在上一节的例子中,CC 小于2122^{{{1\over 2}}} ,许多成分的比率∣xji/xii∣\lvert x_{ji}/x_{ii}\rvert 小于1。
然而,我们刚刚证明的结果不应该误导我们,让我们认为,当我们沿着远离对角线的任何一列移动时,XX 的分量不应该快速增加,这是至关重要的。相反,这种行为通常是非常有利的。例如,考虑一个包含元素的nn 阶矩阵
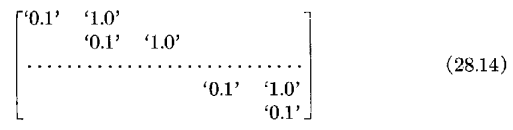
其中我们使用′a′^{\prime}a^{\prime} 来表示aa 的数量级,但带有将导致舍入误差的尾数。现在这个矩阵的逆包含一个10n10^n 阶的元素。如果nn 很大,那么它就是病态的。 然而,根据我们之前的分析,很明显计算出的解的元素具有非常低的相对误差。
尝试构建一个结果不正确的矩阵可以揭示这种现象可能存在的范围。矩阵就是一个例子
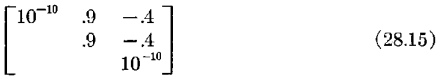
精确逆的最后一列是[0,491010,1010]\left[0,{4\over 9}10^{10},10^{10}\right] 。 计算出的逆的最后一列是 [4×10⁹;4444444444;1010]\left[4\times10^9;4444444444;10^{10}\right] 所以我们确实有一个计算出的逆函数,其相对误差为∥A−1∥×10−10\lVert A^{-1}\rVert\times10^{-10} 。 如果要给出这样的结果,必须非常特殊地设计低阶矩阵。 如果我们使用了完全旋转,那么我们就不能在低阶矩阵中有这样的例子。
从在DEUCED_{EUCE} 上求逆的中度病态非对称矩阵中随机选择 18、25 和 43 阶的三个矩阵,我们发现在所有情况下,计算LL 和计算UU 的求逆以及计算L−1U−1L^{-1}U^{-1} 的求逆几乎对求逆的误差没有贡献。这表明保持差异(LU−A)\left(LU-A\right) 尽可能小是非常重要的,因为这通常是误差的主要来源。如果对大小使用部分旋转,很容易确保∣(LU−A)ij∣<R2−t−1\lvert\left(LU-A\right)_{ij}\rvert<R2^{-t-1} ,其中RR 是关键增长因子。如果不使用普通缩减中两倍的存储空间或替代地进行两次计算,则完全旋转似乎是不可能的。
我们很自然地会问,为什么我们之前的分析没有揭示三角矩阵求逆的准确性。原因是该分析基于对∥X−L−1∥\lVert X-L^{-1}\rVert 的评估,该评估源自∥LX−I∥\lVert LX-I\rVert 的界限。现在,(LX−I)\left(LX-I\right) 的范数在XX 具有异常精度的情况下并不比XX 在没有异常精度的情况下小得多。残差的大小给出了XX 的精度的一个非常粗略的估计,当原始矩阵是病态的时候,具有指定大小的残差矩阵的近似逆所覆盖的范围非常大。在分析一般矩阵的计算逆时,只有当使用的方法在考虑到计算逆的准确性的情况下使残差尽可能小时,我们才能将残差矩阵发挥如此好的作用。
真正重要的范数不是(LX−I)=E\left(LX-I\right)=E (比如说),而是L−1EL^{-1}E 。对于三角矩阵,EE 通常可以表示成LFLF 的形式,其中FF 和EE 有相同的范数,这使得L−1EL^{-1}E 和EE 本身有相同的范数。现在我们可以看到为什么在三角矩阵求逆中逐步引入比例因子通常比始终使用相同的比例因子得到更好的结果,尽管后者得到的残差更小。我们可以举一个极端的例子来说明这一点。假设直到最后一个阶段都不需要比例因子,而这需要相当大的比例因子,2k2^k 。计算得到的值xn′,xn−1′,⋅⋅⋅x2′x_n^{\prime},x_{n-1}^{\prime},\cdot\cdot\cdot x_2^{\prime} 必须四舍五入到kk 个更少的数字,从而得到∣xi−xi′∣≦2k−t−1\lvert x_i-x_i^{\prime}\rvert\leqq2^{k-t-1} 。这种变化对残差的贡献正好是L(x−x′)L\left(x-x^{\prime}\right) 。
现在,虽然就大小而言,这可能构成了残差的主要部分,但显然Ly=L(x−x′)Ly=L\left(x-x^{\prime}\right) 的解是(x−x′)\left(x-x^{\prime}\right) ,而如果剩余的另一部分是E1E_1 ,则Ly=E1Ly=E_1 的解是L−1E1L^{-1}E_1 ,并且可能非常大。增加的残差大小完全是误导。另一方面,由于早期阶段没有比例因子,计算最后一个元素x1x_1 之前的残差被限制在2−t−1∣lii2^{-t-1}\rvert l_{ii} 范围内,而不是2k−t−1∣lii2^{k-t-1}\rvert l_{ii} ∣\rvert 。
当残差矩阵RR (由(AX−I)\left(AX-I\right) 定义)被用来评估近似逆XX 的误差时,我们通常不能断言,除非∥R∥<1\lVert R\rVert<1 。因此,Goldstine和yon Neumann说,除非∥R∥<1\lVert R\rVert<1 ,否则即使是零矩阵也会给出更好的残差。虽然这是正确的,但对于∥X−A−1∥/∥A−1∥≪1\lVert X-A^{-1}\rVert/\lVert A^{-1}\rVert\ll1 的矩阵XX ,将其视为比零矩阵更好的逆矩阵是合理的。事实上,如果一个归一化矩阵AA 的逆矩阵∥A−1∥\lVert A^{-1}\rVert 的阶为102010^{20} ,那么如果XX 是通过将矩阵A−1A^{-1} 中的元素舍入到1010 个有效数字得到的矩阵,那么XX 的某些元素的绝对误差可能高达121010{1\over 2}10^{10} ,而剩余矩阵的分量可能高达(n/2)1010\left(n/2\right)10^{10} 。然而,将XX 视为一个“好的”逆是合理的。
部分旋转策略的失败
29. 下面的例子很好地说明了部分旋转策略在条件良好的矩阵上可能完全失败。考虑(29.1)所示的矩阵形式:
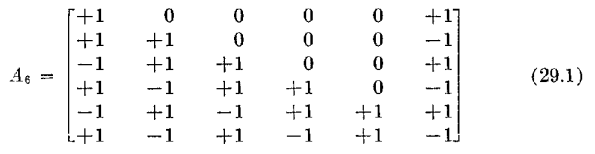
求逆的形式如(29.2)所示:
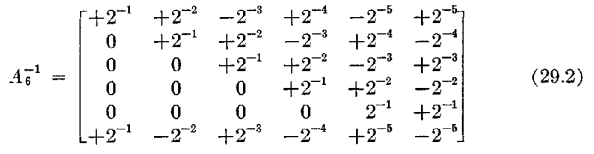
考虑下面这种形式的矩阵A31A_{31} 。这显然是一个条件良好的矩阵。设B31B_{31} 为将其(31,31)元素替换为12{1\over 2} 得到的矩阵。这个矩阵也是良好的,它的逆矩阵与A31A_{31} 的逆矩阵相差+12+{1\over 2} (A−131A{-1\atop 31} 的最后一列)// (A−131A{-1\atop 31} 的最后一行))// (1−2−311-2^{-31} )。因此,有些变化大到2−32^{-3} ,使得倒数的第一个小数有所不同。现在,如果我们使用基于30位二进制尾数的浮点计算的部分关键策略,通过高斯消元法对这些矩阵求逆,那么在约简过程中,所有乘数都是相同的,所有约简矩阵在(31,31)元素上刚好相差12{1\over 2} ,直到我们到达最后一步。在最后一步,A31A_{31} 的值应该是2302^{30} ,B31B_{31} 的值应该是230−122^{30}-{1\over 2} 。后者被四舍五入到2302^{30} ,因此A31A_{31} 和B31B_{31} 给出的上三角矩阵是相同的。因此,它们产生相同的L和UL和U 矩阵,因此也产生相同的逆矩阵!Bn矩阵的范数误差大于(0.1)B−131\left(0.1\right)B{-1\atop 31} 。使用精确的数字并没有起到重要作用,而只是辅助演示。如果我们将A31A_{31} 的所有元素替换为仅最后5位不同的元素,但保持关键决策不变,那么在几乎所有情况下,我们都会得到一个糟糕的逆。从我们的先验分析中我们知道,完整的关键策略对A31,B31A_{31},B_{31} 和A31A_{31} 的所有扰动都给出了一个很好的逆。
这个例子还暴露了一个常见的谬误。在B31B_{31} 的计算中,所有的关键值具有很低的相对误差。事实上,除了最后一个,所有的都是正确的,除了最后一个只有2312^{31} 中的一个部分的错误。尽管如此,结果还是毫无用处。一般来说,重要的数字参数过于肤浅,无法给出可靠的指示,而反射回原始矩阵是一个可靠得多的指导。
迭代求解法
30.人们仍然普遍认为,求解线性方程的迭代方法比直接方法受舍入误差的影响更小,因为在前者中,迭代方法继续使用原始矩阵而不是修改它。我们的分析表明,在好的求解方法中产生的舍入误差的总影响仅对应于原始矩阵元素的非常小的变化。 将这些扰动与对原始矩阵执行迭代时“有效”发生的扰动进行比较是很有趣的。 考虑以浮点数执行的 Gauss-Seidel 迭代中的典型步骤。 通常,改进的x1x_1 是通过关系从先前的x2x3⋅⋅⋅xnx_2x_3\cdot\cdot\cdot x_n 计算得出的
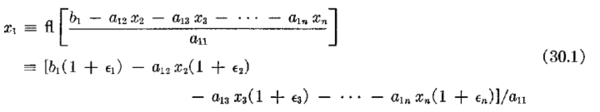
ϵi\epsilon_i 通常的边界。因此,我们对包含元素b1(1+ϵ1)b_1\left(1+\epsilon_1\right) 和 a1i(1+ϵi)a_{1i}\left(1+\epsilon_i\right) 的矩阵执行了精确的 GaussSeidel 步骤。a1iϵia_{1i}\epsilon_i 的边界并不比我们在 Gassian 消元法中获得的扰动更好,而且我们为每次迭代获得了一组不同的ϵi\epsilon_i 。 我们使用原始矩阵的想法是一种错觉。 即使我们精确地累加标量积,我们仍然不会对A和bA和b 进行精确迭代,并且AA 的病态条件仍然会对计算产生不利影响。 下面的方程式很好地说明了这一点:
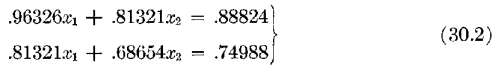
这些方程是正定的,因此Gauss-Seidel迭代应该是收敛的,尽管非常慢。但是,如果我们使用五位小数并精确地累加标量积,则可以从x1=.33116x_1=.33116 , x2=.70000x_2=.70000 开始。例如,在真正解决问题方面没有取得任何进展
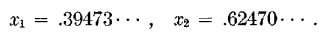
收敛速度很慢,以至于第一步要做的修改小于1210−5{1\over 2}10^{-5} 。如果我们观察到x1x_1 是根据关系计算出来的,我们可以用类似于前面使用的术语来表达这一点
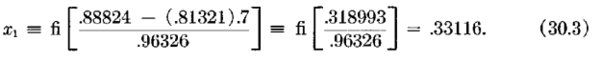
如果分母是.318993/.33116=.963259⋅⋅⋅.318993/.33116=.963259\cdot\cdot\cdot 计算出的x1x_1 对应于一个扰动的a11a_{11} 元素的精确计算。 类似地,计算出的x2x_2 对应于具有扰动的a22a_{22} 元素的精确计算。 从.4.4 到.8.8 范围内的几乎所有x2x_2 开始,迭代向量保持不变。
定点和浮点计算的相对有效性
31. 在本文的大多数阶段,定点计算的结果都优于浮点计算的结果。严格地说,定点这个术语有点用词不当,因为我们所说的定点计算通常涉及到比例因子的引入。因此,我们要比较的是一种只在必要时才引入比例因子的技术(所谓定点)和一种在每个阶段都自动使用比例因子的技术(浮点)。定点方案的优越性完全源于累积精确标量积的能力。现在浮点数不能方便地做到这一点并不是根本原因,这只是现有计算机设计的结果。此外,还有一些定点计算机,在其上积累精确的标量积是不方便的。在ACE上,浮点运算是由子程序执行的,我们发现加法和减法的例程可以在没有明显速度损失的情况下处理双精度浮点数。因此,可以制作一组浮点子程序,它们对双精度数进行相加,将单精度数除以双精度数,但只乘以单精度数,所有操作基本上都以单精度工作的速度进行。通过这些子程序,我们既拥有浮点运算的所有便利,又能充分利用标量积的精确累加优势。提供这种性质的自动浮点功能在矩阵工作中具有很大的价值。
致谢
此处描述的工作是作为国家物理实验室研究计划的一部分进行的,本文经实验室主任许可发表。 作者感谢 G. E.Forsythe 和 E. T. Goodwin 阅读手稿并提出许多宝贵建议。
原文链接:https://dl.acm.org/doi/pdf/10.1145/321075.321076
---煤油灯科技victorlamp.com翻译整理---
