今天最先进的处理器已经不再是一片硅片。相反,它们是将多个“小芯片(chiplet)”通过先进的封装技术绑定在一起的,只不过外表看起来好像一个大芯片一样。但是这样做很昂贵,并且会产生太多失败的系统。
根据UCIe标准,先进封装技术通常称为2.5D和3D封装,它依赖于这样一个事实,即与典型芯片封装在较便宜的有机基板上制作互连相比,在相对昂贵的硅上可得更密集的信号承载互连。对于2D模式,这种成本较低的选择可能意味着将小芯片放置在硅中介层(Silicon Interposer) 上,彼此之间的距离在100微米左右,硅中介层是一种相对较大的半导体切片,其中已经构建了一组密集的互连。或者,两个小芯片可以通过小硅桥(silicon bridge)连接和放置到基板上。
来自初创公司的NuLink技术
这两种方案都存在问题,初创公司Eliyan开发了一种没有硅也能做得一样好的NuLink技术。该公司创始人Ramin Farjadrad表示,这两种方法都尺寸受限,因为都采用了与微芯片相同的制造工艺和设备,所以很难做到与最大的微芯片一样大的尺寸(约800平方毫米)。
更重要的是,将小芯片连接到这些硅基板上,无论是中介层还是桥梁,都意味着在小芯片本身的表面上建立更密集的连接,因此也更微妙。这些连接通常是小的焊料凸点,使用间隔超过100微米的凸块连接到有机基板上。但是硅桥需要这些所谓的微凸块,微凸块之间的间距为30微米。由于微凸块比普通的凸块更容易出故障,将小芯片放在基板上之前很难对其进行测试。
NuLink技术允许有机基板上的互连与支持中介层的2.5D技术的数据吞吐量相匹配。这种吞吐量是以IC边缘每毫米每秒的比特数来衡量的,最新NuLink技术达到至少2万亿比特/秒/毫米,达到了最新UCIe标准的最大值,并向后兼容。

与今天的方法相比,Eliyan NuLink技术(下图)使用更便宜、更可靠的物理链路,可以让高带宽内存远离处理器,同时保持带宽
NuLink技术有什么好处呢?Farjadrad的名单很长。
首先,有一个简单的优点,即能够使用更便宜的基板,并通过更可靠的接口连接到小芯片。
第二,实现了低功耗和低延迟,即信号离开一个小芯片并到达另一个小芯片所需的时间。用于有机基板的其它方案可以达到太比特/秒/毫米,但是它们消耗两倍或更多的能量来传送每个比特,具有更高的等待时间,或者两者兼而有之。通过提供2-4Tb/s/mm的带宽,NuLink技术可以在没有硅中介层的情况下解决大部分应用。
NuLink技术的第一个目标是将高带宽内存(HBM)与CPU和GPU连接起来,让处理器尽可能快地获得数据,尽快化解阻碍机器学习的这个瓶颈。这意味着,将内存芯片放在尽可能靠近处理器的地方,并使用高带宽链路。英特尔的Ponte Vecchio等高级处理器实际上被HBM包围,HBM通过硅中介层或硅桥连接到处理器。通过将NuLink添加到HBM和处理器中,可以在没有硅的情况下获得相同的结果。此外,由于NuLink工作距离达20毫米,设计师可以错开HBM,腾出空间来容纳两倍内存量,这可以将GPU的性能提高两倍。
问题是,对于一家初创公司来说,告诉内存巨头们应该在芯片上添加专有电路是一个相当大的要求。所以取而代之的是,Eliyan设计了自己的硅中介层。HBM将NuLink小芯片连接到内插器上,该组合附着在有机基板上,并在那里连接到处理器。Eliyan公司第一块硅芯片采用TSMC的5纳米工艺制造,将于2023年初问世。
英特尔嵌入式多芯片互连桥(EMIB)
英特尔一直致力于帮助全行业建立小芯片生态系统。该公司在俄勒冈州有一个技术开发小组,Ramune Nagisetty担任该小组的首席工程师,她今年三月接受IEEE Spectrum专访时谈到了Chiplet的定义及重要性和英特尔EMIB等。
Ramune Nagisetty说,“chiplet”实际上是一种封装IP子系统的芯片。它通常是通过高级封装集成,或者是通过标准化接口使用。至于它们为什么会变得如此重要,这是因为我们的计算和工作类型呈爆炸式增长,目前没有一种全能的办法来应对这些问题。从根本上说,对一流技术的异构集成是延续摩尔定律的一种方式。
Nagisetty认为,异构技术并不是非要硅来完成,它还可以应用其他类型的半导体,例如,锗或III-Vs。当然,未来我们会有更多种类的半导体技术。虽然,目前我们只有基于硅的小芯片,但它们能够应用在不同的技术里。它们还可以在数字、模拟、RF以及内存技术等不
同的领域进行调优以获得更好的性能。在这方面,真正的驱动力是存储器的集成。高带宽存储器(HBM)本质上是异构硅封装集成的第一个证明,而内存器本质上是第一种异构集成类型。
那么,英特尔连接小芯片的嵌入式多芯片互连桥(EMIB)是什么?Nagisetty表示,EMIB可以看作是连接两个芯片的高密度桥梁,这大概是理解EMIB的最好方式。很多人都悉知使用硅介质来作高级封装衬底的用途,因为它具有紧密的互连性和内置硅穿孔,这让芯片之间的高带宽连接成为可能。

EMIB(图中圆圈所示)使用高密度互连技术连接同一封装内的芯片。将芯片连接到EMIB的连接凸块比普通凸块(左下)具有更精细的间距
EMIB本质上就是一个非常小的硅介质,它具有非常高密度的互连性。而所谓的微凸块是连接芯片与芯片的焊料小球,它的密度比标准封装衬底要高得多。EMIB一般都会被嵌到一个标准封装衬底中。使用EMIB,你就可以在需要的地方实现最高互连密度,然后再使用一个标准的封装衬底来完成剩下的互连。这样做有很多好处,其中之一就是节约成本,因为硅介质的成本与面积成正比。在这种情况下,我们能将高密度互连定位到最需要的地方。此外,使用标准的封装衬底而不是硅介质,在整体嵌入损耗(由于材料特性导致的信号衰减)方面也有好处。
英特尔已经展示了几个关于小芯片的应用,虽然其中有两种基于EMIB技术,但它们非常不同。
第一个是Kaby Lake-G,这是将AMD的Radeon GPU和HBM与英特尔自己的CPU芯片集成而来的。英特尔使用EMIB集成GPU和HBM,然后再通过封装内的PCI Express(一个标准的电路板接口)集成GPU和CPU。
这个产品的真正有趣之处在于,我们使用不同厂商的元件和共同的行业标准接口(HBM和PCI Express)来创建一流的产品。在本例中,我们使用了一个组件(GPU和HBM),该组件能够单独放在一块板上,然后集成封装。而PCI Express可以用于远距离发送信号,这更像是典型的电路板。将它封装起来并不是一个最优的解决方案,但它的速度够快。
另一个是Stratix 10 FPGA。Stratix 10的中心是英特尔的FPGA,被六个小芯片包围,其中四个是高速收发芯片,两个是高带宽内存芯片,它们都被封装在一起。这个产品集成了三个厂商贡献的六种技术,进一步证明了不同厂商之间的互用性。
Stratix 10 FPGA使用了行业标准的模对模接口AIB,这是英特尔的高级接口总线。它是为这个产品创建的,算得上是一个行业标准,用于封装内的高带宽、逻辑到逻辑互连。所以,HBM是内存集成的第一个标准,AIB是逻辑集成的第一个标准。
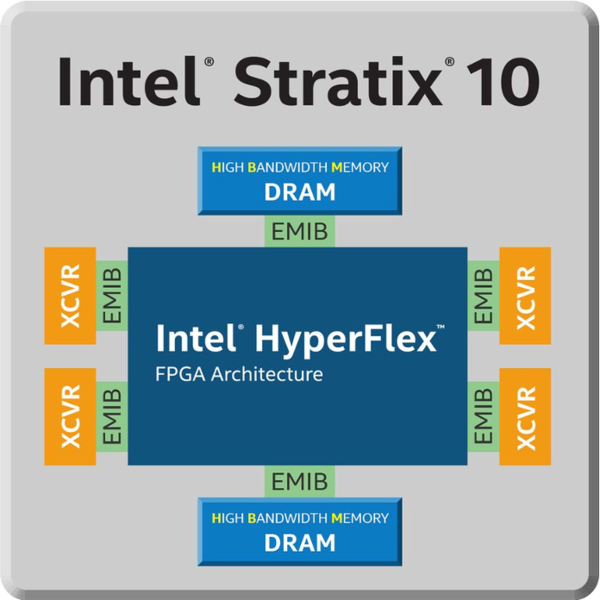
英特尔Stratix 10是使用EMIB连接封装中小芯片的主要示例
作为这个生态系统的中心,AIB接口和FPGA真正伟大之处在于可行的混合匹配模式。目前,许多公司和大学也实施了DARPA的CHIPS(通用异种基因集成和IP重用策略),利用AIB来创建小芯片。
第三个例子是英特尔的Foveros,这是逻辑对逻辑的模堆积。虽然由小芯片集成,但不是水平叠堆,而是垂直叠堆。这种类型的集成可以在两个芯片之间获得极高的带宽。但它基于内部专有接口,而且这两个芯片基本上同步设计,以便管理电力输送和散热等问题。
Nagisetty强调,设计堆叠芯片时,重点要考虑散热问题。不难想象,叠模会加剧发热的问题,所以我们要考虑整个系统的体系结构,仔细设计板面来应对发热情况。3D堆叠的应用含义将影响架构决策,不仅是物理架构,而是整个CPU或GPU和系统架构。此外,如果想要展现任何互用性,就需要有互用的材料系统。为了实现互用性,需要做大量的工作,但是散热是最大的挑战,电源交付和电源管理紧随其后。
除了上述问题,建立测试的行业标准也非常重要。通常,我们会使用封装完毕的部件进行测试,必须把正常运作的小芯片封装起来,这样就不会因错误地封装了有问题的小芯片,而导致产量下降。因此,要想出一个完美的测试策略。这意味着,我们要连接所有集成的芯片,以便同时管理电源和热量。
另一件事是,为了测试独立小芯片而需要的东西都需要设计到芯片中,小芯片必须在封装前单独完成测试,这是非常重要的。因为,如果封装好的芯片里有损坏品,就会浪费一同封装的好芯片。这种芯片确实大幅提升了产量,但这只是我们使用它的一个原因,而且不是唯一的原因,产量提高的关键因素是在封装前测试这些芯片。
这种芯片还会改变事物的设计方式,高带宽内存集成就是一个例子。目前,高宽带内存已经在GPU和高性能AI处理器中广泛使用。目前看来,小芯片和内存集成已经改变了芯片的设计和集成方式。
参考链接:
https://spectrum.ieee.org/chiplet-interconnect
https://spectrum.ieee.org/intels-view-of-the-chiplet-revolution
---煤油灯科技victorlamp.com翻译整理---
