机器学习和人工智能(AI)已深入渗透到生活和工作中,以至于你可能已经忘记了过去与机器交互的情景。用数字键盘、电子表格或编程语言表达问题时,我们只要求精确的定量答案,例如“10的平方根是多少?”、“这种利率下,我们未来五年的收益是多少?”
但是过去10年里,我们已经习惯了机器能够回答那种定性的、模糊的问题。这样的问题我们以前只会问其他人,“我会喜欢这部电影吗?”,“今天的交通状况如何?”,“那笔交易是欺诈性的吗?”
深度神经网络(DNNs)是一种系统,当它们被与正确答案非常相似的查询训练后,就学会了如何响应新的查询,实现了这些新功能。根据IDC的数据,dnn是快速增长的全球AI硬件、软件和服务市场的主要驱动力,今年价值3275亿美元,预计2024年将超过5000亿美元。
卷积神经网络(convolutional neural networks)首先通过提供超乎人类的图像识别能力推动了这场革命。在过去十年中,自然语言处理、语音识别、强化学习和推荐系统的新DNN模型已经实现了许多其他商业应用。
但是,不仅应用程序数量在增长,网络规模及其所需的数据也在增长。dnn本质上是可扩展的——当它们变得更大时,当你用更多的数据训练它们时,它们提供了更可靠的答案。但是这样做是有代价的。在2010年至2018年期间,训练最佳DNN模型所需的计算操作数量增长了10亿倍,这意味着能耗的巨大增加,虽然每次使用已经训练好的DNN模型对新数据进行推理所需的计算量要少得多,比训练本身所需的能源也少,但这种推理计算的数量是巨大的,而且还在增加。如果要继续改变人们的生活,AI必须变得更有效率。
我们认为,可能需要从数字计算转向模拟计算。使用非易失性存储器件和电气工程中的两个基本物理定律,简单电路只需要万亿分之一焦耳(1毫微微焦),就可以实现深度学习最基本计算的一个版本。在这项技术能够应用于复杂的AI之前,还要做大量的工程工作,但我们已经取得了很大的进步,并描绘出前进的道路。
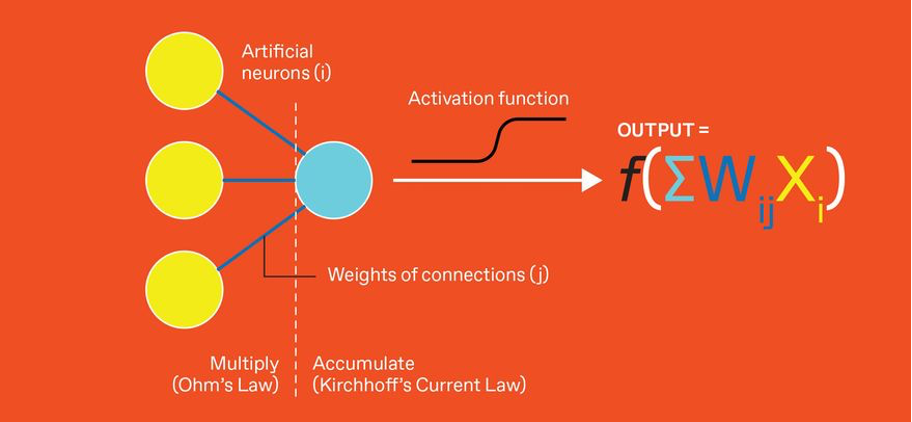
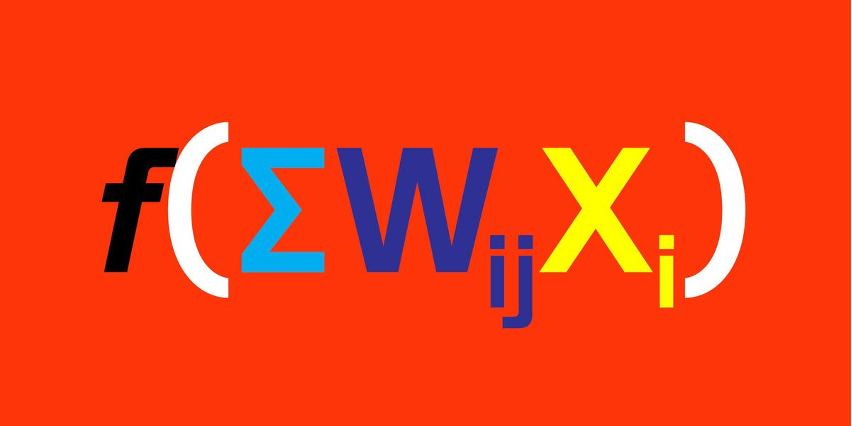
人工神经网络最基本的计算称为乘法和累加。人工神经元的输出(左边,黄色)与连接它们到下一个神经元的权值相乘(中间,浅蓝色)。该神经元将输入相加,作为一个输出函数。在模拟AI中,乘法功能由欧姆定律(Ohm's Law)执行,即神经元的输出电压乘以代表权值的电导。神经元的求和是基尔霍夫电流定律(Kirchhoff's Current Law)实现的,即简单地将进入单个节点的所有电流相加。
大多数计算机中,当必须在外部存储器和计算资源(如CPU和GPU)之间移动大量数据时,这时的时间和能源成本是最大的。这就是将内存和逻辑分离的经典计算机架构之后出现的“冯诺依曼瓶颈(von Neumann bottleneck)”。一种大大降低深度学习所需功率的方法是避免移动数据——在存储数据的地方进行计算。
DNNs由多层人工神经元组成。每层神经元根据一对值驱动下一层神经元的输出——神经元的“激活”和与下一个神经元连接的突触“权值”。
大多数DNN计算由所谓的向量矩阵乘法(vector-matrix-multiply,VMM)运算组成,其中一个向量(一维数字数组)乘以一个二维数组。在电路层,这些向量矩阵乘法由许多乘加运算(multiply-accumulate,MAC)组成。对于每个下游神经元,所有上游激活都必须乘以相应的权值,然后将这些贡献相加。
大多数有用的神经网络都太大,无法存储在处理器的内部存储器中,因此在计算网络的每一层时,必须从外部存储器中引入权值,每次计算都会遇到可怕的冯诺依曼瓶颈。这导致数字计算硬件倾向于从内存中移入较少权值的dnn,然后积极地重用这些权值。
早在2014年,IBM Research就想到了一种全新的节能DNN硬件方法。我们和其他研究人员一起研究非易失性存储器(nonvolatile memory,NVM)的交叉阵列。交叉阵列是这样的结构,其中器件(例如存储单元)被构建在两组垂直的水平导体(所谓的位线和字线)之间的垂直空间中。我们意识到,只要稍加修改,我们的内存系统将非常适合DNN计算,尤其是那些现有权值重用技巧效果不佳的计算。我们将这种机会称为“模拟AI”,尽管其他从事类似工作的研究人员也使用“内存处理(processing-in-memory)”或“内存计算(compute-in-memory)”等术语。
NVM有多种类型,每种存储数据的方式都不同,但是通过测量器件的电阻(或者倒数——电导)可从所有这些器件中检索数据。磁阻RAM(MRAM)使用电子自旋,闪存使用“悬浮栅”里的陷阱电荷,电阻RAM (RRAM)器件通过在微小的金属绝缘体金属(metal-insulator-metal)构造内先产生再破坏的导电丝缺陷,相变存储器(PCM)使用热量来诱导高传导性结晶相和低传导性非晶相之间的快速且可逆的转变。
闪存、RRAM和PCM提供传统数字数据存储所需的低阻和高阻状态,以及模拟AI所需的中间电阻。但是,只有RRAM和PCM能够方便地放置在高性能逻辑硅晶体管上方的布线内的交叉阵列中,使存储器和逻辑之间的距离最小化。
我们将这些NVM存储单元组织成一个二维阵列,即“瓦片(tile)”上。这些瓦片包括控制NVM器件读写的晶体管或其他器件。对于存储器应用,寻址到一个行(字线)的读取电压产生与NVM的电阻成比例的电流,该电流可以在阵列边缘的列(位线)上检测到,以恢复存储的数据。
为了让这样的瓦片成为DNN的一部分,每行都被电压驱动一段时间,这段时间对一个上游神经元的激活值进行编码。沿着该行的每个NVM器件用其电导编码一个突触权值。通过欧姆定律(在这种情况下表示为“电流等于电压乘以电导”),所得到的读取电流有效地执行了激励和权值的相乘。然后,根据基尔霍夫电流定律,每个位线上的各个电流相加。这些电流产生的电荷在电容上经过一段时间的积分,产生MAC运算的结果。
这些相同的模拟内存内求和技术也可以使用闪存甚至SRAM单元来执行,这些单元可以存储多位,只是不能存储模拟电导。但是,我们不能将欧姆定律用于乘法步骤。相反,我们使用一种技术来适应这些存储器件的一位或两位动态范围。然而,这种技术对噪音非常敏感,所以IBM坚持基于PCM和RRAM的模拟AI。
与电导不同,DNN权值和激活可以是正的,也可以是负的。为了实现带符号的权值,我们使用一对电流路径,一个给电容增加电荷,另一个减少电荷。为了实现带符号的激励,只要需要,我们就允许与这些路径连接的每一行交换。
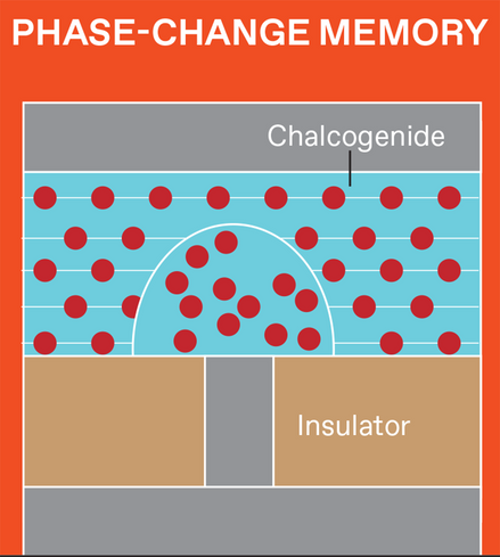
PCM的电导通过硫系玻璃(chalcogenide glass)上的结晶相和非晶相之间的瞬变设定。
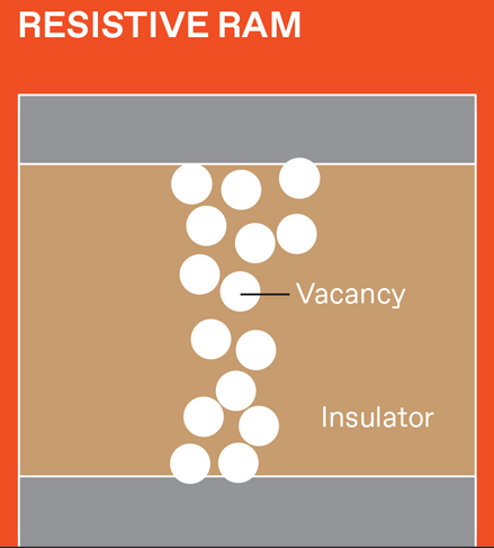
在电阻RAM中,电导取决于绝缘体中导电丝的产生和中断。
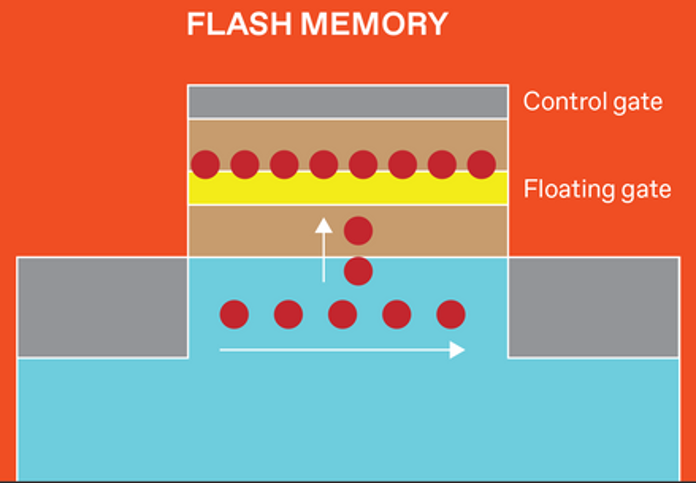
闪存使用“悬浮栅”里的电荷存储数据
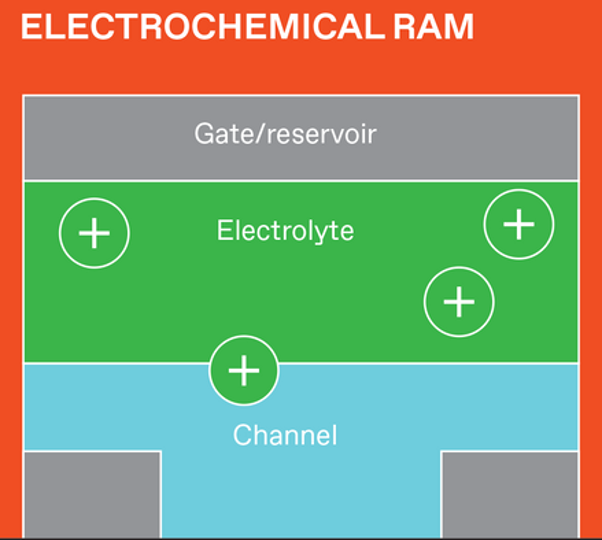
电化学RAM就像一个微型电池。
每列执行一次MAC运算,瓦片就执行一次完整的并行向量矩阵乘法。对于一个1,024 × 1,024权值的瓦片,就是100万次MAC运算。
在我们设计的系统中,预期所有这些计算只需32纳秒。因为每台MAC执行的计算相当于两次数字运算(一次乘法,然后是一次加法),所以每32纳秒执行这100万模拟MAC相当于每秒65万亿次运算。
我们建造的瓦片每次运行只需36毫微微焦耳的能量,相当于每焦耳28万亿次运行。我们最新的瓦片设计将这一数字降至10 fJ(飞焦耳)以下,使其效率是商用硬件的100倍,比最新定制数字加速器的系统级能效高10倍,即使是那些为了能效而大幅牺牲精度的加速器也是如此。
提高每瓦片的能效对我们来说非常重要,因为整个系统在其他任务上也会消耗能量,例如移动激活值和支持数字电路。
这种模拟AI方法要真正起飞,还有许多重大挑战要克服。首先,根据定义,深度神经网络有多个层。为了级联多个层,我们必须通过人工神经元的激活(一种非线性功能)处理VMM瓦片的输出,并将其传递给下一个瓦片。非线性可能通过模拟电路实现,其结果以下一层所需的持续时间形式进行通信,但除了简单的VMM级联之外,大多数网络还需要其他操作。这意味着我们需要高效的模数转换(ADC)和适当数量的并行数字计算。新颖、高效的ADC有助于防止这些电路对整体效率产生太大影响。最近,我们推出了一种基于PCM的高性能瓦片,它使用了一种新型ADC,帮助瓦片实现了每瓦10万亿次以上的操作。
第二个挑战更麻烦,它与NVM器件的行为有关。数字dnn的准确性已得到证明,即使用相当低精度的数字描述它们的权值。CPU常用的32位浮点数对于dnn是多余的,当使用8位浮点数甚至4位整数时,dnn通常可以很好地工作,并且消耗的能量也较少。这给模拟计算带来了希望,只要我们能保持类似的精度。
鉴于电导精度的重要性,在将电导写入NVM器件以表示模拟神经网络的权值时,需要缓慢而小心地完成。与SRAM和DRAM等传统存储器相比,PCM和RRAM的编程速度较慢,并且在较少编程周期后就会磨损。幸运的是,对于推理来说,权值不需要频繁地重新编程。因此,模拟AI可以使用耗时的写验证技术来提高RRAM和PCM器件的编程精度,而不用担心器件磨损。
这种提升是非常必要的,因为NVM具有固有的编程噪声级。RRAM的导电性取决于少数原子形成细丝的运动。PCM的导电性取决于多晶材料中晶粒的随机形成。在这两种情况下,这种随机性给写入、验证和读取值带来了挑战。此外,在大多数nvm中,随着PCM器件中的非晶相结构漂移,或者RRAM中的灯丝松弛,或者闪存单元中的捕获电荷泄漏,电导会随着温度和时间而变化。
有一些方法可以解决这个问题,使用两个电导对可以显著改善权值编程。这里,一对保持大部分信号,而另一对用于校正主对上的编程错误。噪声降低是因为它在更多的器件之间得到了平均。
我们最近在一个基于多个PCM的芯片上测试了这种方法,每个权值都使用一个和两个电导对。采用这种方法,我们在几个dnn上演示了出色的准确性,包括循环神经网络(Recurrent Neural Network, RNN),这类网络通常对权值编程错误敏感。
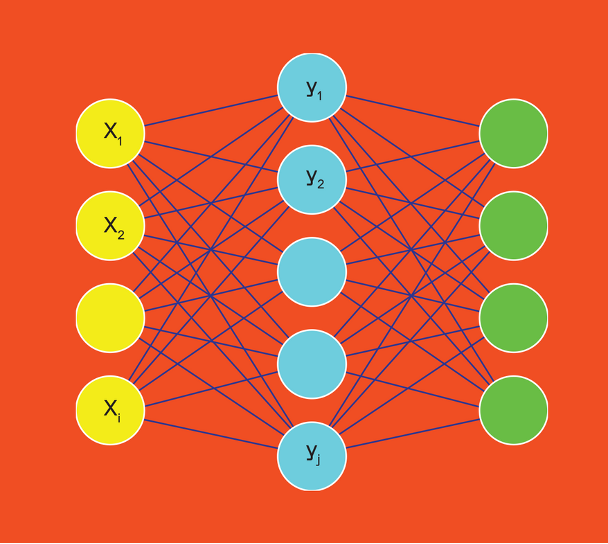
向量矩阵乘法(VMM)是神经网络计算的核心,是乘法和累加过程的集合。这里,人工神经元的激活(黄色)与下一层神经元(绿色)的连接权值(浅蓝色)相乘。
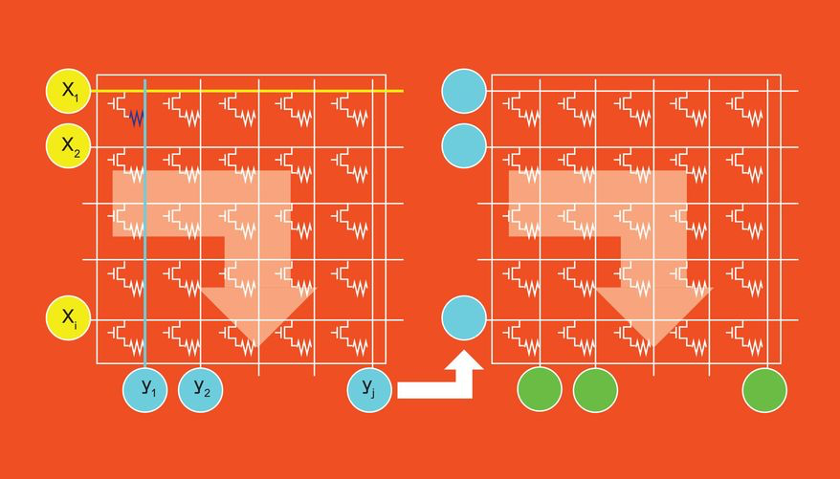
对于模拟AI,VMM在交叉阵列瓦片(中心)上执行。在每个交叉点,NVM单元将权值编码为电导。神经元的激活编码成电压脉冲的持续时间。欧姆定律表明,沿着每个交叉列的电流等于电压乘以电导。瓦片底部的电容器(未示出)将这些电流相加。神经网络的多层结构(右)可表述为将一个瓦片的输出转换成下一个瓦片的输入所需的电压持续脉冲。
不同的技术可以帮助改善读取中的噪声和漂移效应。但由于漂移是可预测的,因此最简单的方法可能是在读取过程中用随时间变化的增益来放大信号,从而抵消大部分误差。另一种方法是使用已经开发的用于训练DNNs进行低精度数字推理的相同技术。用这些调整神经网络模型,以匹配底层硬件的噪声限制。
正如我们提到的,网络正在变得越来越大。在数字系统中,如果网络不适合您的加速器,您需要从外部存储芯片中获取DNN每一层的权值。但NVM的写入限制使这成为一个糟糕的决定。相反,多个模拟AI芯片应该结合在一起,每个芯片将部分网络的中间结果从一个芯片传递到下一个芯片。这种方案会导致一些额外的通信延迟和能耗,但这比移动权值本身的代价要小得多。
到目前为止,我们只是在谈论推理——一个已经训练好的神经网络对新数据起作用。但模拟AI也有机会帮助训练dnn。
用反向传播(backpropagation)算法训练dnn。这结合了通常的正向推理操作和另外两个重要步骤——误差反向传播和权值更新。误差反向传播就像反向运行推理,从网络的最后一层回到第一层;然后,权值更新将来自原始正向推理运行的信息与这些反向传播的误差相结合,使模型以更准确的方式调整网络权值。
反向传播步骤可以相反的推理方式在瓦片上就地完成——对列施加电压并沿行积分电流。然后,通过用来自正向推理的原始激活数据驱动行,同时用反向传播期间产生的误差信号驱动列,以执行权值更新。
训练涉及许多小权值的增加和减少,必须适当将它们抵消,但这很难,原因有两点。首先,回想一下NVM器件会因为过多的编程而磨损。第二,以相反极性施加到NVM的相同电压脉冲可能不会以相同的量改变单元的电导,其反应是不对称的。但是,对于反向传播产生精确的网络,对称性是至关重要的。这只会变得更具挑战性,因为训练所需的电导变化幅度接近NVMs中材料的固有随机水平。
一些方法可帮助应对这些挑战。例如,有多种方法可以汇总多个训练示例中的权值更新,然后在训练期间定期将这些更新传输到NVM器件上。IBM开发了一种称为Tiki-Taka的新算法,即使是高度不对称的RRAM器件,使用这种技术也可成功训练DNNs。最后,我们正在开发一种称为电化学随机存取存储器(ECRAM)的器件,它不仅可以提供对称的,而且可以提供高度线性和渐进的电导更新。
模拟AI的成功将取决于同时实现高密度、高吞吐量、低延迟和高能效。密度取决于nvm可以多紧密地集成到芯片晶体管上方的线路中。瓦片层的能效将受限于模数转换的电路。
但是,即使这些因素得到改善,越来越多的瓦片连接在一起,阿姆达尔定律——关于并行计算局限性的争论——也将对优化系统能效提出新的挑战。以前不重要的问题,如瓦片之间所需的数据通信和数字计算,将诱发越来越多的能量预算,并导致瓦片本身的峰值能效和整个模拟AI系统可持续能效之间的差距。当然,这是每个AI加速器最终都会出现的问题,无论是模拟还是数字。
改进方法与数字AI加速器也必然不同。数字方法会降低准确度,直到精度衰退为止。但模拟AI必须首先提高内部模拟模块的信噪比(SNR),直到它足够高,能够表现出与数字系统相当的精度。任何后续的SNR改进都可用于提高密度和能效。
这些都是令人兴奋的问题,需要材料科学家、器件专家、电路设计师、系统架构师和DNN专家的共同努力才能解决。尽管对更高能效的AI加速有着强烈和持续的需求,但一直缺乏能满足这一需求的有吸引力的替代方案。在各种潜在的存储器件和实现路径中,某种程度的模拟计算很可能在未来的AI加速器中找到出路。
原文链接:https://spectrum.ieee.org/analog-ai
---煤油灯科技victorlamp.com翻译整理---
