在2022年11月14日于美国举行的2022年度超算(SC22)会议上,新一期《世界最快的500台超级计算机》出炉。该排名始于1993年,旨在让大家了解高性能计算的演变本质,因为世界上最强大的超级计算机大多数是公众资助的。
与今年6月的榜单相比,新榜单的前3名未变化,仅有前10名微调。但这些细微变化可能会改变购买超级计算能力的方式,如何计算它们的相对性能,以及以原始性能衡量它们的价值。当然,核心假设是容量越大越好,容量越大意味着回答时间越短,或者模拟或模型分辨率越高,提供的答案越细致、越精确。
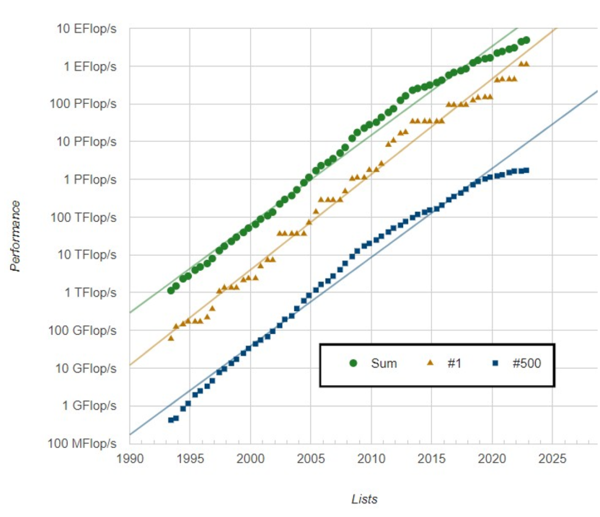
众所周知,即使在基数为2的计算领域,实现1000倍的性能提升目标也越来越困难。超级计算在前二十年中缓慢地走过了megaflops系列,尽管当时感觉很快,并在1989年达到gigaflops,1997年达到teraflops,2008年达到petaflops,2022年达到exaflops。也许在这个十年结束之前的某个时候,我们可能会实现zettaflops。
在丹纳德扩展(Dennard scaling)速度放缓和摩尔定律(Moore’s Law)增长速度放缓,以及芯片成本上升的共同加持下,能力类超级计算机(capability-class supercomputer)的性能增长速度一直快于成本,但成本增长仍然过快。先进的芯片制造节点,如7纳米和5纳米技术,不但每个晶体管的成本超过了14纳米,封装也更加复杂和昂贵。
其他一些重要的芯片——计算、内存、互连也都变得越来越贵,即使它们确实能带来更高的性能。这意味着超级计算机的票价正在上涨。这与我们在笔记本电脑和台式机上看到的情况完全相反——随着时间的推移,笔记本电脑和台式机越来越便宜。如果把速度放得更慢一些,超算与我们手机的情况类似,价格只会一个方向不断上涨,因为我们希望手机制造商能够给我们提供所有的连接、存储和小配件。
以下我们简单谈谈500强名单上的新发现,然后谈谈一些总体趋势。
TOP500概要
新名单中,美国橡树岭国家实验室(ORNL)的前沿(Frontier)仍以1.102 EFlop/s位列榜首,也是本期TOP500榜单中唯一的“E级超算”,其额定峰值为1.69 eflops浮点运算和1.1 eflops持续运算。
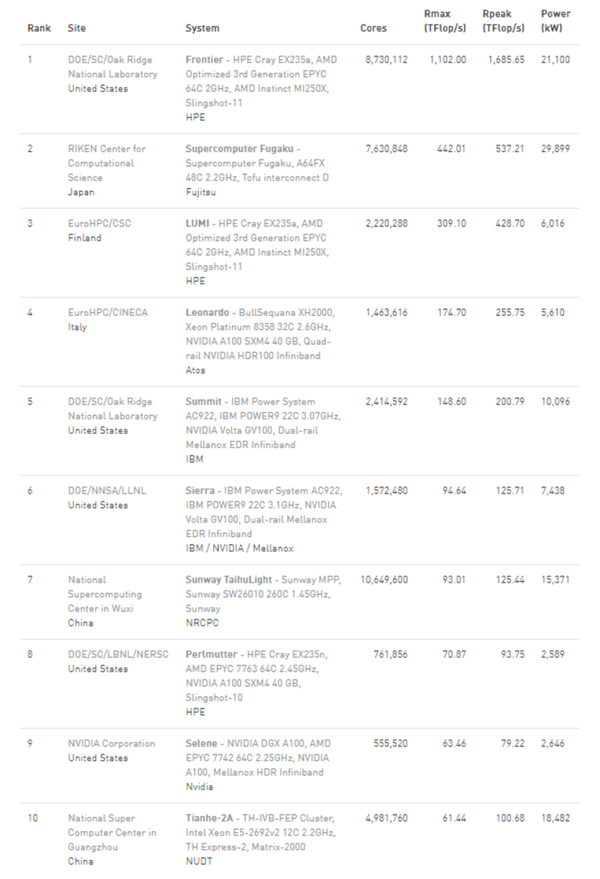
日本神户Riken计算科学中心(R-CCS)的富岳Fugaku)这次仍排在第2位。
欧洲最快超算——CSC公司的LUMI这次仍然排在第三位。和Frontier一样,LUMI也是基于惠普公司的Cray EX235a系统,AMD定制的第三代Trento Epyc 64C 2GHz CPU 和 Instinct MI250X GPUs,拥有222万个处理器内核和SMs。这台机器运行Linpack时消耗了600千瓦多一点电力,共有428.7 pflops的峰值性能和309.1 pflops的持续性能,计算效率为72.1%。
位于LUMI之后的是意大利Cineca公司的Leonardo系统,以1,463,616个内核取得了0.174 eflops的HPL得分排名第4,这也是前十名中唯一新上榜的新机。Leonardo运行于Atos BullSequana XH2000系统,使用配备了一对32核英特尔Xeon Platinum 8358 32C 2.6GHz CPU,配有4个Nvidia Ampere A100 GPU加速处理器,捆绑了Nvidia的四轨100Gb/秒InfiniBand网络。在本轮Linpack测试中,Leonardo保持的峰值为174.7 pflops,提供63.8%计算效率。
受新机挤压,中国的两台超算——OceanLight系统(前身是神威太湖之光)、天河2A较今年6月的Linpack test测试都下调一位。其中,OceanLight系统排名第7,天河2A排名第10。
超算500配置分析
早在2016年夏天,中国就有一个三网融合计划,构建第三台基于X86架构的pre-exascale机器。具体地说,是基于AMD授权给天津广海先进技术投资公司,本质上是一个由中国科学院指导的投资财团。这台机器使用来自天津广海的32核Hygon Dhyana CPU,还有一个不确定的深度计算处理器——Sugon TC8600。该机共有163,840台CPU和加速器上的核心,消耗380千瓦电力,在Linpack上提供6.13 pflops峰值性能和4.33 pflops持续性能。
Top500中,虽然许多机器仍然是纯CPU系统,但功能级系统几乎都有某种形式的加速。因此,现在看500强名单中的CPU架构并不像过去那样有意义。

在2000年代早期到中期,Opterons代表了近四分之一的机器(列表中还有很多Power、Xeon和其他iron)。这一次,500强中20.2%的机器基于AMD X86处理器,75.8%的机器基于Intel X86处理器。
预计随着时间推移,AMD的这一数字将继续攀升。最终,所有旧的Power架构机器都将被淘汰,越来越多基于Arm的机器将会出现,包括Rhea Arm CPU。但主机方面,这场战斗在很大程度上仍将在AMD和英特尔之间展开。
在GPU方面,争夺战是在Nvidia和AMD之间进行的。随着Frontier的克隆产品在美国和欧洲出现,AMD正在高端市场获得一些非常重要的地位。
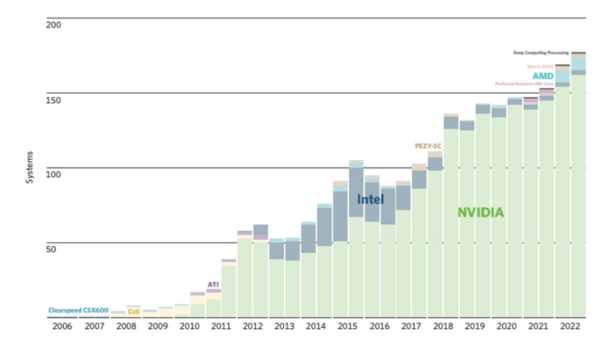
500强中有179台超级计算机使用某种形式的加速器来完成大数量的计算,其中84台使用英伟达Volta V100 GPU,64台使用英伟达Ampere A100 GPUs。
早在2016年夏天,中国就有一个三网融合计划,构建第三台基于X86架构的pre-exascale机器。具体地说,是基于AMD授权给天津广海先进技术投资公司,本质上是一个由中国科学院指导的投资财团。这台机器使用来自天津广海的32核Hygon Dhyana CPU,还有一个不确定的深度计算处理器——Sugon TC8600。该机共有163,840台CPU和加速器上的核心,消耗电力380千瓦,在Linpack上提供6.13 pflops峰值性能和4.33 pflops持续性能。
值得注意的是,本期榜单上还有1台机器使用Nvidia Hopper H100 GPU,那就是Flatiron Institute的Henri系统。Henri机器由联想(Lenovo)提供,使用了ThinkSystem SR670 V2服务器、1对32核Ice Lake Xeon SP-8362 Platinum处理器,和1个带80GB HB m3内存的四核H100 GPUs。
Henri节点通过Nvidia的200Gb/秒HDR InfiniBand连接,机器总共有5920个CPU和SMs,其峰值性能为5.42 pflops,持续性能为2.04 pflops。但是计算效率只有37.6%,这让我们大跌眼镜,但这台机器只消耗了31.3千瓦电力,提供了每瓦65.1 gigaflops运算,这实际上比Frontier系统还要好一点点。考虑到更低的机器开销的话,这比Frontier本身好很多。
我们强烈怀疑Henri系统的计算效率——也是能源效率——会随着性能调整而提高,我们没有理由相信基于Hopper的GPU集群无法获得在65%到75%之间CPU和GPU计算效率。这种将Nvidia Grace Arm CPU与自身的Hopper CPU组合使用的方法,由于在CPU和GPU计算与内存之间联接方面的高速、高带宽优势,将很可能表现得更好。
把握云中的机遇
多年来,我们一直抱怨位于500强中间和底部的一些系统被电信公司、服务提供商和云所主导,他们对部分基础设施进行Linpack测试,向这些OEMs提供服务并让榜单排名上升。这扭曲了真实的HPC市场,我们不期望这种情况会改变。但我们也强烈怀疑,随着越来越多的HPC中心采用云作为消费模式,当“机器”在大型公共云中存在数年后,HPC市场将开始以正确的方式回归。
目前,有1台机器排名第57位,由Descartes Labs负责,运行在亚马逊网络服务上,这是一个使用以太网的全CPU集群,在Linpack上的速度为9.95 pflops。俄罗斯搜索引擎服务商Yandex正在托管三台机器——第25位的Chervonenkis,第44位的Galushkin和第47位的Lyapunov,它们都基于AMD Rome Epyc 7002系列CPU、Nvidia A100 GPUs和InfiniBand互连。
微软Azure有4台昵称为Pioneer的相同机器,排名从40到43,使用与Yandex机器相同的计算和互连系列,当然还有Azure上的Voyager集群。该技术2021年11月首次出现在500强榜单中,当时排在第10位。该系统目前仍在运行,并以30 pflops的Linpack分值排名第14位。
对于许多HPC中心,云空间的快速扩展和无需考虑资本支出及数据中心等优势越来越重要。尽管费用更高,客户未来依然在云中租赁机器,这种情况还会越来越多。
参考链接:
https://www.top500.org/lists/top500/2022/11/
https://www.nextplatform.com/2022/11/14/testing-the-mettle-of-the-top-supercomputing-iron-on-earth/
---煤油灯科技victorlamp.com翻译整理---
