摘要
基于提示的学习已经成为自然语言处理中的一种成功范例,其中单个通用语言模型可以被指示执行输入提示所指定的任何任务。然而,机器人技术中的任务规范有多种形式,比如模仿一次性演示,遵循语言指令,以及达到视觉目标。它们通常被认为是不同的任务,由专门的模型来处理。这项工作表明,我们可以用多模态提示,交织文本和视觉标记来表达广泛的机器人操作任务。我们设计了一个基于Transformer的通用机器人代理VIMA,它处理这些提示并自回归输出电机动作。为了训练和评估VIMA,我们开发了一个新的模拟基准,包含数千个程序生成的桌面任务,具有多模态提示,600K+专家轨迹用于模仿学习,以及四个级别的评估协议用于系统泛化。VIMA在模型容量和数据规模上都具有很强的可扩展性,在相同的训练数据下,它在最难的零次概化设置中优于先前的SOTA方法,高达2.9倍的任务成功率。在训练数据减少10倍的情况下,VIMA的性能仍然比顶级竞争方法好2.7倍。我们在https://vimalabs.github.io上开放了所有代码、预训练的模型、数据集和模拟基准。
1.介绍
Transformers在许多人工智能领域引发了显著的多任务整合。例如,用户可以使用GPT-3的自然语言提示来描述任务,允许相同的模型执行问题回答、机器翻译、文本摘要等。基于提示的学习提供了一个可访问且灵活的界面,将自然语言理解任务传达给通用模型。
我们设想,一个多面手机器人代理应该有一个类似的直观和富有表现力的任务规范接口,这样的机器人学习界面是什么样的呢?作为一个激励人心的例子,考虑一个负责家务活动的个人机器人,我们可以通过简单的自然语言指令让机器人给我们倒一杯水,如果我们需要更多的特异性,我们可以指示机器人“bring me <image of the cup>”。对于需要新技能的任务,机器人应该能够从一些视频演示中更好地适应,需要与不熟悉的物体进行交互的任务可以通过一些图像示例轻松解释,以便为新概念奠定基础。最后,为了确保安全部署,我们可以进一步指定视觉约束,如“不输入<image>房间”。
为了使单个智能体具备所有这些能力,我们在这项工作中做出了三个关键贡献:(1)一个新颖的多模态提示公式,将广泛的机器人操作任务转化为一个序列建模问题;(2)具有多任务处理能力和零次概化能力的新型机器人代理模型;(3)一个具有不同任务的大规模基准测试,系统地评估我们的代理的可扩展性和泛化性。
我们首先观察到,许多机器人操作任务可以通过多模态提示来表述,这些提示穿插语言和图像或视频帧(在图1中由“{image}”表示)。例如,视觉目标的一种类型Rearrangement 可以表述为“请重新排列对象以匹配此{scene_image}”;新概念基础看起来像“这是一个dax {new\_object}”和这是一个小方块{new\_object},在大理石上放两块金属牌。” Few-shot Imitation可以在提示“木立方按照此运动轨迹:{frame1},{frame2},{frame3},{%frame4}”中嵌入视频片段,表达视觉约束就像添加子句“不触及{safety_boundary}”一样简单。
多模态提示符不仅具有比单个模态更强的表达能力,而且可以为训练多面手机器人代理提供统一序列IO接口。以前,不同的机器人操作任务需要不同的策略架构、目标函数、数据管道和训练程序,导致孤立的机器人系统,不能轻松地组合为丰富的用例集。相反,我们的多模态提示界面使我们能够利用大型Transformers模型的最新进展开发可扩展的多任务机器人学习者。
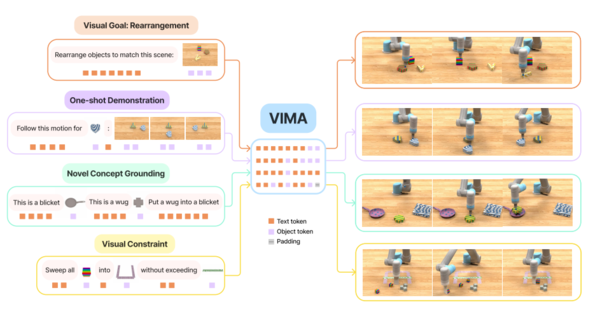
图 1:任务规范的多模式提示。我们观察到许多机器人操作任务可以表示为交错语言和图像/视频帧的多模态提示,我们提出了 VIMA,一种能够处理多模态提示(左)和控制机器人手臂解决任务(右)的具身代理模型。
为此,我们设计了一个新的视觉运动注意力模型(VIMA,读作“v-eye-ma”),该架构遵循在NLP中被证明有效和可扩展的编码器-解码器转换器设计。VIMA使用预先训练的语言模型对文本和视觉提示符交织的输入序列进行编码,并为每个环境交互步骤自回归解码机器人控制动作。Transformers解码器通过交叉注意层以提示为条件,交叉注意层与通常的因果自我注意交替。VIMA采用以对象为中心的方法,而不是对原始像素进行操作。我们通过现成的检测器将提示或观察中的所有图像解析为对象,并将其压扁为对象标记序列。所有这些设计选择结合在一起,提供了一个概念简单的体系结构,具有强大的模型和数据伸缩特性。
为了系统地评估我们提出的算法,我们引入了一个建立在Ravens模拟器上的新基准(VIMA-Bench) 。我们提供了17个具有多模态提示模板的代表性元任务,可以通过纹理和桌面对象的各种组合程序实例化为数千个单独的任务。VIMA- Bench建立了一个4级协议来评估逐步增强的泛化能力,从随机对象放置到新任务(图2)。为了演示VIMA的可扩展性,我们训练了7个模型的频谱,范围从2M到200M参数。我们的方法优于强大的先验SOTA方法,如Gato,Decision Transformer 和Flamingo,在所有4个级别的零射击综合和所有模型能力上,有时差距很大(在相同数量的训练数据下,任务成功率高达2.9倍,即使数据少10倍,成功率也高2.7倍)。我们开源了仿真套件、训练数据集、算法实现和预训练的模型检查点,以确保可再现性,并促进社区未来的工作。
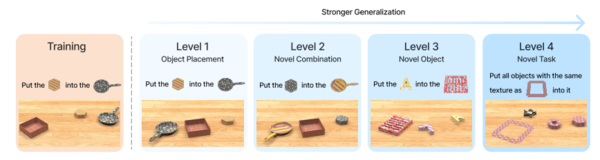
图 2:VIMA-Bench中的评估协议。我们设计4个评估设置的级别,以系统地衡量代理的零样本泛化能力。每个级别都偏离训练分布更多,因此比上一个级别更具挑战性。
2.任务规格的多模式提示
机器人学习中的一个中心和开放问题是任务规范。我们的关键见解是,各种任务规范范例(如目标调节、视频演示、自然语言教学)都可以实例化为多模态提示(图1)。具体地说,一个多模态提示PP 的长度被定义为任意交错的文本和图像的有序序列 PP[x0,x1,,,xl\lbrack^{x0,x1,,,xl} ]\rbrack 其中每个元素 xxi^i ∈{text,image}.
任务套件。多模式提示所提供的灵活性允许我们为各种各样的任务规范格式指定和构建模型。这里我们考虑以下六个任务类别:
1,简单的对象操作:简单的任务,如“将<object>放入<container> ”,其中提示符中的每个图像对应一个对象;
2,视觉目标实现:操纵对象以达到目标配置,例如,重新排列;
3,新颖的概念基础:提示包含不熟悉的单词,如“dax”和“blket”,这些词在提示图像中解释,然后立即用于指令中,这测试了代理快速内化新概念的能力;
4,一次性视频模仿:观看视频演示,学习重现特定物体的相同运动轨迹;
5,视觉约束满足:机器人必须小心操作物体,避免违反(安全)约束;
6,视觉推理:需要推理技能的任务,例如,“将所有与<object>具有相同纹理的物体移动到容器中”,视觉记忆“将<object>放入容器中,然后恢复到原来的位置”。
请注意,这六个类别并不是相互排斥的。例如,一个任务可以通过视频演示引入一个以前未见过的动词(新概念),或者将目标实现与视觉推理结合起来。
3.VIMA-Bench:多模态机器人学习基准
模拟环境。现有的基准测试通常针对特定的任务规范。据我们所知,目前还没有基准测试能够提供丰富的多模式任务套件和全面的测试平台,用于有针对性地探测代理功能。为此,我们引入了一个新的多模态机器人学习基准套件,我们称之为VIMA-Bench。我们通过扩展Ravens机器人模拟器来构建基准,VIMA-Bench支持可扩展的对象和纹理集合,以组成多模态提示并以程序方式生成大量任务。具体来说,我们提供了17个带有多模态提示模板的元任务,这些任务可以实例化为1000个单独的任务,每个元任务都属于上面提到的6种任务规范方法中的一个或多个,VIMA-Bench可以通过脚本化的oracle代理生成大量的模仿学习数据。
观察与行动。我们的模拟器的观测空间包括从正面视角和自上而下视角呈现的RGB图像。Groundtruth对象分割和包围框也用于训练以对象为中心的模型(第4节)。我们继承了Zeng等人(2020)的高级动作空间,其中包括“挑选和放置”和“擦拭”等原始运动技能,这些由末端执行器的姿态参数化。我们的模拟器还具有脚本化的oracle程序,可以通过使用特权模拟器状态信息(如所有对象的精确位置和多模态指令的真实解释)来生成专家演示。
训练数据集。我们利用预编程的oracles 来生成一个大型的离线专家轨迹数据集,用于模仿学习。我们的数据集包括每个元任务50K个轨迹,总共650K个成功轨迹,我们提供了对象模型和纹理的子集进行评估,并指定17个元任务中的4个作为零镜头泛化的测试平台。
评估零样本泛化。VIMA-Bench中的每个任务都有一个二进制的成功标准,并且不提供部分奖励信号。在测试期间,我们在物理模拟器中执行多个集的代理策略,以百分比计算成功率,所有评估的元任务的平均成功率将是最终报告的指标。
我们设计了一个4级评估协议(图2)来系统地探测学习代理的泛化能力。每一层都更偏离训练分布,因此严格来说比前一层更难:
1,放置概括:所有提示在训练过程中都是逐字显示的,但只有物体在桌面上的放置在测试时是随机的。
2,组合泛化:所有材料(形容词)和 3D 对象(名词)在训练期间都可以看到,但它们的新组合出现在测试中。
3,新颖的对象概括:测试提示和模拟工作区包括新颖的形容词和对象。
4,新颖的任务概括:在测试时具有新颖提示模板的新元任务。
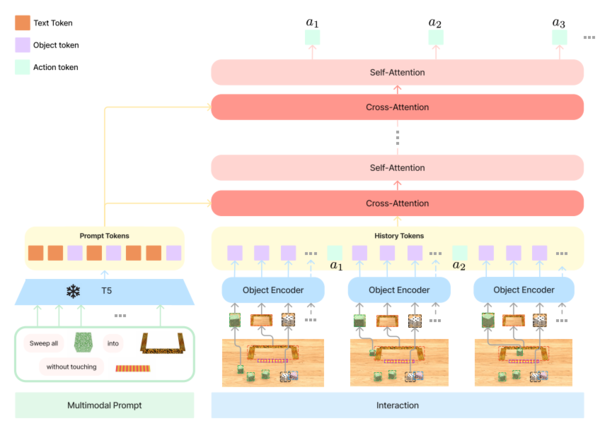
图 3:VIMA 。我们使用预训练的 T5 模型对多模态提示进行编码,并通过交叉注意层对机器人控制器进行调节。该控制器是一个因果转换器解码器,由交替的自我和交叉注意层组成,可预测以提示和交互历史为条件的电机命令。
4.VIMA:视觉运动注意力模型
我们的目标是构建一个机器人代理,它可以执行多模态提示所指定的任何任务。为了学习有效的多任务机器人策略,我们提出了VIMA,一种以对象为中心设计的极简多任务编码器-解码器架构(图3)。具体地说,我们学习了一个机器人策略π\pi (atat |PP ,HH),在哪里表示过去的交互历史otot ∈\inOO ,atat ∈AA 是每个交互步骤中的观察和操作。我们通过一个冻结的预训练语言模型对提示进行编码,并通过交叉注意层对编码提示进行解码。
标记。提示符中有3种原始输入格式——文本、单个对象的图像和完整桌面场景的图像(例如,用于重排或模仿视频帧)。对于文本输入,我们使用预训练的T5标记器和单词嵌入来获得单词标记。对于完整场景的图像,我们首先使用现成的Mask R-CNN提取单个对象。每个对象都表示为一个边界框和一个裁剪过的图像。然后,我们通过分别使用边界框编码器和ViT对对象标记进行编码来计算它们。对于单个对象的图像,我们以相同的方式获取标记,只是使用了一个虚拟的包围框。然后,我们遵循Tsimpoukelli等人(2021)的方法,通过将生成的令牌序列传递给预训练的T5编码器模型来产生提示编码,我们的位置嵌入是可学习的和绝对的。
机器人控制器。多模态多任务策略设计的难点之一是选择合适的调节机制。在我们的模式(图3)中,机器人控制器(解码器)以提示序列PP 为条件,通过PP 和轨迹历史序列HH 之间的一系列交叉注意层,每个交叉注意层生成一个输出序列:
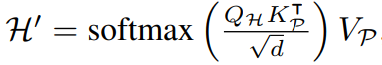
dd 为嵌入维数。这种设计选择有三个优点,1)加强了与提示符的联系,2)原有提示符的完整和深度流动,3)计算效率更高。VIMA解码器由LL 层交替交叉注意层和自注意层组成。最后,为了便于学习和优化,我们遵循常见做法将预测的动作标记映射到机械臂的离散姿态。
培训。我们遵循标准的行为克隆,通过最小化预测动作的负对数可能性来训练我们的模型。具体来说,对于TT 步骤的轨迹,我们将其最小化:
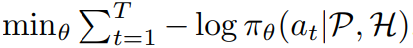
整个训练是在无法访问物理模拟器的离线数据集上进行的。为了使 VIMA 对检测不准确和故障具有鲁棒性,我们通过随机注入误报检测输出来应用对象增强。训练后,我们根据保留验证集上的聚合准确度选择模型检查点进行评估,评估涉及与物理模拟器的交互,我们遵循最佳实践使用 AdamW 优化器、学习率预热、余弦退火等来训练 Transformer 模型。
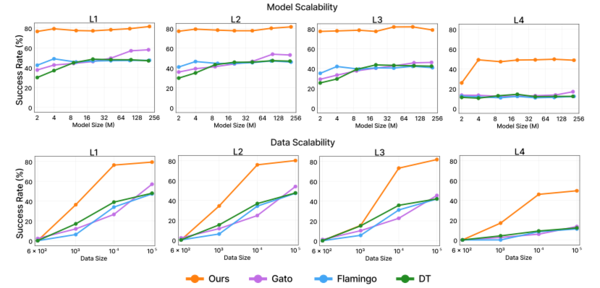
图 4:缩放模型和数据。上图:我们比较了模型大小从 2M 到 200M 不等的参数的不同方法的性能。在所有模型大小和泛化级别上,VIMA 都优于之前的工作。底部:对于 92M 参数的固定模型大小,我们比较了模仿学习数据集大小的效果0.1%,1个%,10%,以及全仿数据。VIMA 具有极高的样品效率,并且可以达到与其他方法相当的性能10倍更少的数据。
5.实验
在本节中,我们旨在回答三个主要问题:
1,VIMA 与之前基于 SOTA transformer 的代理在各种多模式提示任务上的比较如何?
2,我们的方法在模型容量和数据大小方面的缩放属性是什么?
3,不同的视觉分词器、提示条件和提示编码如何影响决策制定?
5.1基线
Gato引入了一个纯解码器模型,该模型通过用观察和动作子序列提示模型来解决来自多个域的任务,其中任务是通过指定的。为了公平比较,我们提供了与VIMA相同的条件,即我们的多模态嵌入式提示符。输入图像被划分为补丁,并通过ViT模型进行编码,以产生观察标记。
Flamingo是一种视觉语言模型,它学习生成文本补全以响应多模态提示。它通过percepver Resampler模块将可变数量的提示图像嵌入到固定数量的标记中,并通过交叉注意对已编码的提示设置语言解码器。 Flamingo不工作与具体化的代理开箱,我们通过用机器人动作头替换输出层来支持决策屏蔽。
Decision Transformer(DT)是第一批将RL问题重新解释为变压器序列建模的作品之一。在视觉RL领域,如Atari游戏,DT会根据期望的奖励值提示,并根据RGB观察嵌入自回归地输出动作,我们将DT的初始奖励提示替换为我们的多模式任务提示嵌入,并删除所有后续奖励令牌。
5.2评估结果
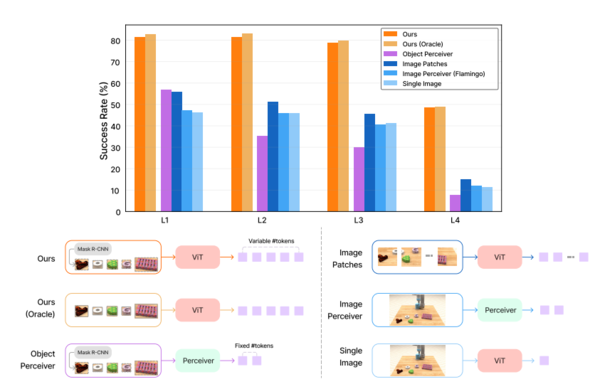
图 5:视觉分词器的消融。我们比较了 VIMA-200M 模型在不同视觉标记器上的性能。我们提出的对象标记优于所有直接从原始像素学习的方法,以及将对象序列下采样到固定数量标记的对象感知器。
我们将VIMA与其他SOTA方法在我们的基准测试中为不同的模型和训练数据集大小提供的四个级别的泛化进行比较。
模型扩展。我们训练所有方法的模型容量从2M到200M参数的频谱,在对数尺度上均匀间隔。所有方法的编码器大小保持不变(预训练的T5-Base),并从参数计数中排除。在所有级别的零概率泛化中,我们发现VIMA的表现明显优于之前的工作。虽然像Gato和Flamingo这样的模型在更大的模型尺寸下表现出更好的性能,但VIMA始终在所有模型尺寸上都取得了更好的性能。我们注意到,这只能通过交叉注意和对象令牌序列表示来实现——改变任何组件都会显著降低性能,特别是在低模型容量的情况下。
数据缩放。接下来我们研究不同的方法如何随着不同的数据集大小进行扩展。我们比较模型性能0.1%,1个%,10%以及VIMA-Bench中提供的全模仿学习数据集(图 4)。VIMA 具有极高的采样效率,并且只需要1个%的数据可以达到与训练有素的基线方法相似的性能10倍的L1 和 L2 泛化水平的更多数据。事实上,对于 L4,我们发现只有1个%训练数据,VIMA 已经优于之前使用整个数据集训练的工作。最后,在所有级别上10%的数据,VIMA 可以显着优于之前使用完整数据集训练的工作。我们假设数据效率可归因于 VIMA 的以对象为中心的表示,与直接从低数据区域中的像素学习相比,它更不容易过度拟合。这与Sax 等人的发现一致,这表明以中级视觉表示为条件的具体代理往往比原始像素的端到端控制具有更高的采样效率。
渐进式概括。最后,我们比较了在没有进一步微调的情况下,在逐步挑战零样本评估水平上测试模型时性能的相对退化(图6),我们的方法表现出最小的性能回归,特别是在L1L1 →L2L2 和L1L1 →L3L3,相比之下,其他方法可以降低多达20%,特别是在更困难的泛化测试场景中。尽管在评估时所有方法都会显着降低L4L4 ,VIMA的性能下降只有所有其他基线的一半严重。这一结果表明,与其他竞争方法相比,VIMA开发了更通用的策略和更健壮的表示。
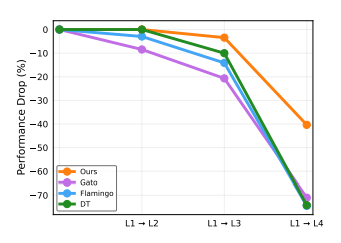
图 6:当我们评估越来越难的零样本泛化时, VIMA导致的性能下降比基线小得多。
5.3 消融研究
通过大量的实验,我们在VIMA中减少了不同的设计选择,并研究了它们对机器人决策的影响。我们主要关注以下3个方面:视觉标记化、提示编码和提示条件变量。
视觉标记化。如图4所示,VIMA使用现成的掩码R-CNN实现将提示和观察图像处理为可变数量的对象标记。视觉标记器的特殊选择有多重要?我们研究了5个不同的变体,并在VIMA-Bench上实证评估了它们的4个级别的泛化性能:(1),我们的(Oracle):我们没有使用Mask R-CNN,而是直接从模拟器中读出groundtruth边界框。换句话说,我们使用一个完美的目标检测器来估计本研究性能的上限;(2),对象感知器:我们应用一个感知器模块将每帧中检测到的可变数量的对象转换为固定数量的令牌。感知器的计算效率更高,因为它减少了平均序列长度:(3), Image Perceiver:与Flamingo中的Perceiver Resampler相同的架构,将图像转换为少量固定数量的标记:(4),图像补丁:按照Gato方法,将RGB帧划分为方形补丁,提取ViT嵌入令牌。patch的数量大于Image Perceiver的输出;(5),单幅图像:Decision Transformer的标记器,它将一张图像编码为一个标记。
消融结果如图5所示。我们强调一些发现:首先,我们注意到,与oracle边界框相比,我们的Mask R-CNN检测管道导致了最小的性能损失,这要归功于对象增强(第4节),它增强了训练期间的鲁棒性。其次,从原始像素(图像感知器、补丁或单个嵌入)进行标记始终不如我们以对象为中心的格式。我们假设这些标记器必须分配额外的内部容量来解析来自低级像素的对象,这可能会阻碍学习。Sax等人(2018)呼应了我们的发现,与端到端管道相比,使用中层视觉可以大大改善代理泛化。第三,即使我们的和对象感知器都使用相同的对象包围框输入,后者在决策方面明显更差。我们得出结论,重要的是将对象的可变序列直接传递给机器人控制器,而不是向下采样到固定数量的令牌。
即时调节。VIMA通过交叉注意在编码提示符上对机器人控制器(解码器)进行调节。一种简单的替代方法是将提示PP 和交互历史HH 连接到一个大序列中,然后应用GPT 这样的解码器转换器来预测动作。在这种消融中,我们保持对象标记器不变,只将条件机制切换到因果序列建模。图7显示了VIMA (xattn)和GPT-解码器变体在4个泛化级别上的比较。虽然GPT在较大的模型中取得了相当的性能,但交叉注意仍然在小容量范围内占主导地位,并且在最具挑战性的L4(新任务)设置中泛化得更好。我们的假设是,交叉注意有助于控制器在每个交互步骤中更好地专注于提示指令。这与Sanh等人(2021)的经验结果相似;Wang等人(2022b)的研究表明,调优的编码器-解码器架构在零样本泛化方面优于GPT-3。
提示符编码。我们改变预训练的T5编码器的大小来研究提示编码的效果。我们实验了三种T5模型的容量:T5 -small (30M), T5 -base (111M), T5 -large (368M)。对于所有的T5变体,我们微调了最后两个层,冻结了所有其他层。我们发现变量之间没有显著差异,因此我们将t5-base设置为所有模型的默认值。
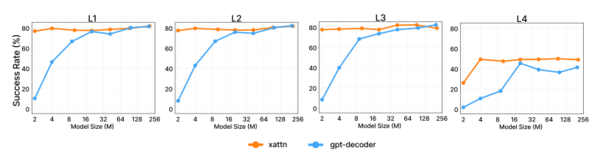
图 7:消融:即时调节。我们将我们的方法(xattn:交叉注意提示条件)与不同模型大小的普通转换器解码器( gpt-decoder )进行比较。交叉注意力在低参数体系和更难的泛化任务中特别有用。
6.结论
与GPT-3类似,一个通用机器人代理应该有一个直观和富有表现力的界面,供人类用户传达他们的意图。在这项工作中,我们引入了一种新的多模态提示公式,将不同的机器人操作任务转换为统一序列建模问题。我们提出了VIMA,这是一种概念简单的基于transformer的代理,能够解决视觉目标、单镜头视频模仿和单一模型的新概念接地等任务。VIMA展示了卓越的模型和数据缩放特性,并为未来的工作提供了一个强有力的起点。
---煤油灯科技victorlamp.com翻译整理---
